Всё о DevOps
Для связи - @raz_raz
Заказать рекламу через биржу: https://telega.in/c/devops_memops
Post #7888
1.59K
 DE
@devops_memops
Showing posts older than #7890 · Back to latest

Ваши приложения Kubernetes необъяснимо замедляются, даже когда у ваших узлов, казалось бы, достаточно свободной CPU? Возможно, вы сталкиваетесь с дросселированием CPU. Недавно я посмотрел отличное видео CNCF от Дэйва Чилука, инженера из Indeed. В этой статье приведены мои основные выводы из видео.


В вашем кластере есть Pod с ошибкой. Он пытается запуститься, но не может пройти инициализацию. Судя по всему, недавно в его спецификацию добавили новый контейнер, и с этого момента Pod перестал нормально работать. Сможете починить?

Docker Swarm может быть жив или мёртв — вопрос спорный, но сама ниша никуда не делась. И такие проекты, как Kamal (от 37signals) и Uncloud (от Паши Свидерского), пытаются её закрыть.
Если вы ещё не слышали про последний, Uncloud — это лёгкий (по сравнению с Kubernetes) инструмент для деплоя и управления контейнеризованными приложениями в сети Docker-хостов.
Антон Овчинников недавно опубликовал пошаговый гайд на iximiuz Labs, в котором показано, как развернуть кластер Uncloud на нескольких VM. Традиционно, все команды из туториала можно прогнать прямо в приложенной песочнице.
Функция Kubernetes NodeSwap, которая, вероятно, перейдет в статус стабильной в предстоящем выпуске Kubernetes v1.34, позволяет использовать swap: это значительный сдвиг от обычной практики отключения swap для обеспечения предсказуемости производительности. Эта статья посвящена исключительно настройке swap на узлах Linux, углубляясь в критические параметры ядра Linux, которые управляют поведением swap, и в том, как они влияют на производительность рабочих нагрузок, использование swap и механизмы изгнания.
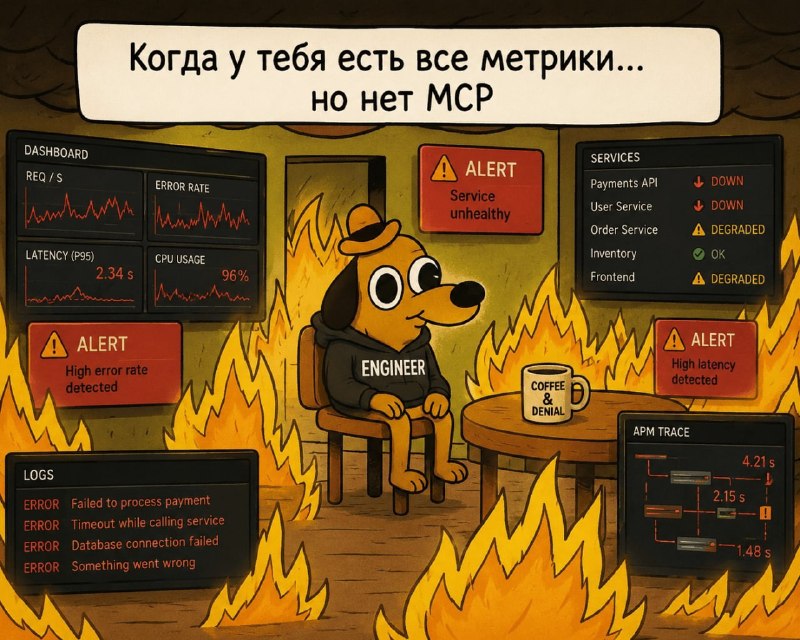

Кажется, в observability снова выбор без выбора: Grafana или ClickStack?
Статья разбирает вопрос выбора на примере ClickHouse. Если ClickHouse — центральное хранилище телеметрии, а инженеры чаще расследуют инциденты, чем смотрят на заранее созданные графики, авторы предлагают смотреть в сторону ClickStack: поиск, корреляция логов, метрик и трейсов, session replay и отдельный акцент на AI/SRE-агентов через MCP.
Grafana остаётся сильнее там, где инфраструктура неоднородная: Prometheus, ClickHouse и ещё десяток источников, которые нужно собрать на одном дашборде, добавить алертинг и не заставлять команду менять привычные процессы.
Так как статья опубликована в блоге Clickhouse, практичный вывод напрашивается сам собой: «А зачем выбирать?» Grafana можно оставить для дашбордов и мониторинга, а ClickStack использовать для глубоких расследований по данным ClickHouse. Причём данные и ingestion pipeline дублировать не придётся.