Всё о DevOps
Для связи - @raz_raz
Заказать рекламу через биржу: https://telega.in/c/devops_memops
Post #7551
1.59K
 DE
@devops_memops
Showing posts older than #7552 · Back to latest
Как мы устранили аварийные циклы и сотни ошибок и почему «высокая доступность» все ухудшала.

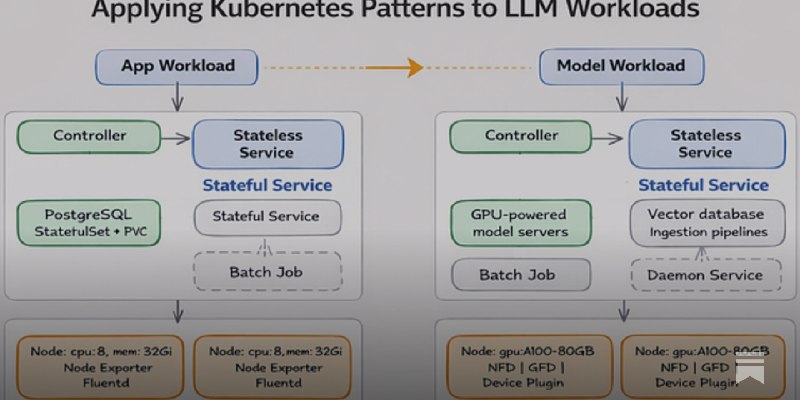
Несколько лет назад мы с Роландом Хуссом написали Kubernetes Patterns — каталог повторяемых решений для создания облачных приложений на Kubernetes. В книге рассматриваются шаблоны по шести категориям: базовые, поведенческие, структурные, конфигурационные, безопасность и расширенные — от проверок работоспособности и контейнеров инициализации до контроллеров, операторов и эластичного масштабирования. Недавно Роланд и Даниэле Зонка написали в соавторстве новую книгу «Генераторный искусственный интеллект в Kubernetes», в которой рассматривается операционная сторона запуска LLM в Kubernetes. Я был рецензентом этой книги, и чем больше я ее читал, тем больше я узнавал закономерности из нашей оригинальной работы, просто применимые к совсем другому классу рабочей нагрузки. Развертывания, StatefulSets, Init-контейнеры, DaemonSets. Они все были там. Только с большими цифрами.
Вот общий обзор того, как шаблоны Kubernetes применяются к рабочим нагрузкам LLM, которые мы с Роландом рассмотрим более подробно в нашем предстоящем выступлении KubeCon + CloudNativeCon Europe 2026 в Амстердаме.


Он выявляет метрики, которые существуют в вашей базе данных временных рядов (TSDB), но никогда не запрашиваются панелями мониторинга, правилами оповещений, правилами записи или любыми другими потребителями. Затем вы можете сгенерировать правила удаления метрик Prometheus, чтобы удалить их и уменьшить потребность в хранилище.
Неиспользуемая метрика - это метрика, которую Prometheus собирает и сохраняет, но которую никто никогда не считывает. Она занимает память, дисковое пространство и бюджет на обработку данных, не принося никакой пользы. В больших масштабах такие метрики могут составлять значительную часть общего количества рядов данных.
Cardamon сопоставляет каждую метрику в вашей базе данных временных рядов со следующими параметрами:
— журналы запросов Prometheus отображают каждое выражение PromQL, вычисленное в течение настраиваемого окна ретроспективного анализа.
— правила оповещения и записи в Prometheus. Все выражения правил в вашем Prometheus.
— панели мониторинга Grafana. Все метрики на всех панелях мониторинга в вашем экземпляре Grafana.
Любой показатель, отсутствующий в этих источниках, помечается как неиспользуемый.


Поддерживает Windows 11/10/8/7 / Linux / MacOS без дополнительных настроек.
Поддерживает протоколы:
- SOCKS
- HTTP(S)
- Shadowsocks
- Trojan
- VMess
- VLESS
- TUIC
- Hysteria
- Hysteria2
- AnyTLS
- NaïveProxy
- Juicity
- TrustTunnel
- ShadowTLS
- Wireguard
- SSH
- Custom Outbound
- Custom Config
- Chaining outbounds
- Extra Core

Это специально уязвимый кластер, где можно безопасно тренироваться в атаках и защите Kubernetes-инфраструктуры. Проект сделан как интерактивный hands-on playground: поднимаешь окружение, проходишь сценарии и смотришь, как реальные ошибки в конфигурации превращаются в проблемы безопасности.
Внутри есть сценарии про:
• утечки sensitive keys в коде
• эксплуатацию Docker-in-Docker
• SSRF в Kubernetes
• container escape на хост
• атаки на private registry
• exposed NodePort-сервисы
• обход namespace-изоляции
• RBAC misconfiguration
• DoS по CPU/Memory
• аудит кластера через KubeAudit
• runtime detection через Falco
• network boundaries через Network Security Policies
• Kyverno и политики безопасности
• eBPF-наблюдаемость через Cilium Tetragon
Запускается через kubectl и helm, после установки доступ открывается локально через port-forward. Проект поддерживает разные окружения: KIND, K3S, GKE, EKS, AKS и другие.
Важно: это намеренно уязвимая среда. Не запускайте её рядом с production-инфраструктурой - только в изолированной лаборатории.
Отличный вариант для DevOps, SRE, pentest-специалистов и всех, кто хочет понять Kubernetes Security не по слайдам, а руками.
Возможности:
— алерты из Grafana, Zabbix, Alertmanager, Uptime Kuma - в отдельные каналы
— ACK одной кнопкой - автоматический silence в Alertmanager
— Push-уведомления на телефон даже при закрытом браузере
— командный чат - каналы, @упоминания, файлы
— совместим с Telegram Bot API - существующие боты работают с заменой одной строки
Помимо проксирования, он обеспечивает интеллектуальное управление контейнерами за счет:
— автоматический запуск служб Docker при обращении к ним.
— отключение после периода бездействия (необязательно).
Это особенно полезно для сред с самостоятельным размещением, где необходимо экономить ресурсы, запуская только необходимые сервисы и обеспечивая при этом их легкий доступ по запросу.
Возможности:
— запуск контейнеров по запросу: автоматически запускает контейнеры Docker при получении HTTP-запросов.
— интеллектуальное управление простоями: отслеживает использование контейнеров и останавливает простаивающие контейнеры по истечении заданного времени ожидания.
— автоматическая настройка NGINX: генерирует конфигурации обратного прокси NGINX с поддержкой SSL.
— без простоев: бесперебойное проксирование с автоматической загрузкой страниц при запуске.
— ресурсоэффективность: контейнеры запускаются только при необходимости, что позволяет экономить ресурсы процессора и памяти.
— простая настройка: конфигурация всех сервисов в одном JSON-файле.
— автоматическая установка: установка одной командой с помощью скрипта установки.