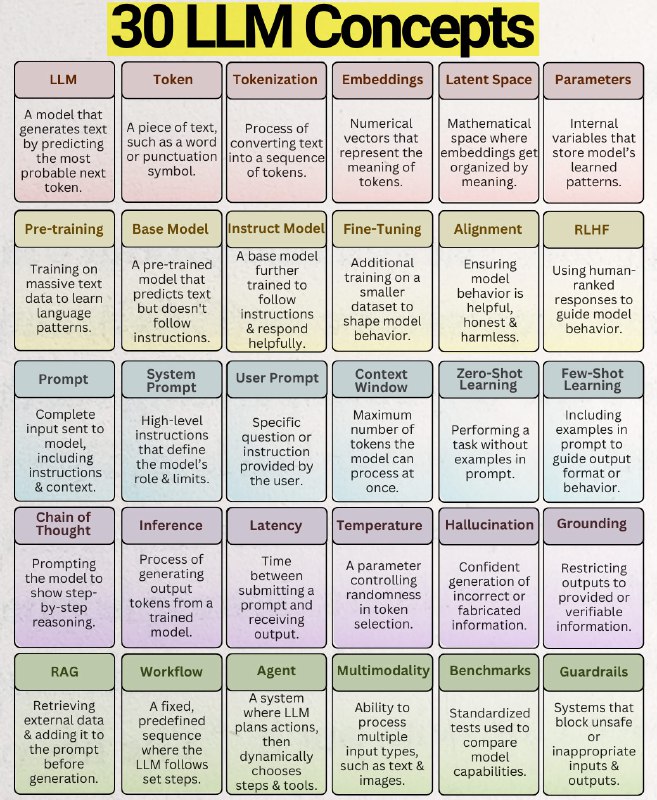
30 базовых концепций LLM(продолжение
предыдущего поста)
1.
LLM (Large Language Model) — модель, которая генерирует текст, предсказывая наиболее вероятный следующий токен.
2.
Token (токен) — фрагмент текста, например, слово или знак препинания.
3.
Tokenization (токенизация) — процесс преобразования текста в последовательность токенов.
4.
Embeddings (эмбеддинги) — числовые векторы, которые отражают значение токенов.
5.
Latent Space (латентное пространство) — математическое пространство, где эмбеддинги организуются по смыслу.
6.
Parameters (параметры) — внутренние переменные, хранящие усвоенные моделью паттерны.
7.
Pre-training (предварительное обучение) — обучение на огромных объёмах текстовых данных для освоения языковых паттернов.
8.
Base Model (базовая модель) — предварительно обученная модель, которая предсказывает текст, но не следует инструкциям.
9.
Instruct Model (модель с инструкциями) — базовая модель, дополнительно обученная следовать инструкциям и давать полезные ответы.
10.
Fine-Tuning (дообучение) — дополнительное обучение на меньшем наборе данных для формирования поведения модели.
11.
Alignment (выравнивание) — обеспечение того, чтобы поведение модели было полезным, честным и безвредным.
12.
RLHF (Reinforcement Learning with Human Feedback — обучение с подкреплением с обратной связью от человека) — использование ранжированных человеком ответов для корректировки поведения модели.
13.
Prompt (промпт) — полный ввод, отправляемый модели, включая инструкции и контекст.
14.
System Prompt (системный промпт) — высокоуровневые инструкции, определяющие роль и ограничения модели.
15.
User Prompt (пользовательский промпт) — конкретный вопрос или инструкция, предоставленная пользователем.
16.
Context Window (окно контекста) — максимальное количество токенов, которое модель может обработать за один раз.
17.
Zero-Shot Learning (обучение без примеров) — выполнение задачи без примеров в промпте.
18.
Few-Shot Learning (обучение на нескольких примерах) — включение примеров в промпт для направления формата вывода или поведения.
19.
Chain of Thought (цепочка мыслей) — побуждение модели демонстрировать пошаговое рассуждение.
20.
Inference (вывод) — процесс генерации выходных токенов с помощью обученной модели.
21.
Latency (задержка) — время между отправкой промпта и получением вывода.
22.
Temperature (температура) — параметр, контролирующий случайность при выборе токенов.
23.
Hallucination (галлюцинация) — уверенная генерация неверной или вымышленной информации.
24.
Grounding (привязка к реальности) — ограничение вывода предоставленной или проверяемой информацией.
25.
RAG (Retrieval-Augmented Generation — генерация, дополненная поиском) — извлечение внешних данных и добавление их в промпт перед генерацией.
26.
Workflow (рабочий процесс) — фиксированная, предопределённая последовательность шагов, которых придерживается LLM.
27.
Agent (агент) — система, в которой LLM планирует действия, а затем динамически выбирает шаги и инструменты.
28.
Multimodality (мультимодальность) — способность обрабатывать несколько типов входных данных, таких как текст и изображения.
29.
Benchmarks (бенчмарки) — стандартизированные тесты для сравнения возможностей модели.
30.
Guardrails (ограничители) — системы, блокирующие небезопасные или неподходящие входные и выходные данные.

 ME