
Предсказуемые обращения к памяти значительно быстрее
Загрузка данных из памяти часто занимает несколько наносекунд. Пока процессор ожидает данные, он может простаивать, не выполняя полезную работу. Аппаратные блоки предварительной выборки современных процессоров предсказывают доступ к памяти, загружая данные в кэш заранее, что оптимизирует производительность. Их эффективность зависит от шаблона обращений: последовательные чтения выигрывают от эффективной предзагрузки, в отличие от случайных запросов.
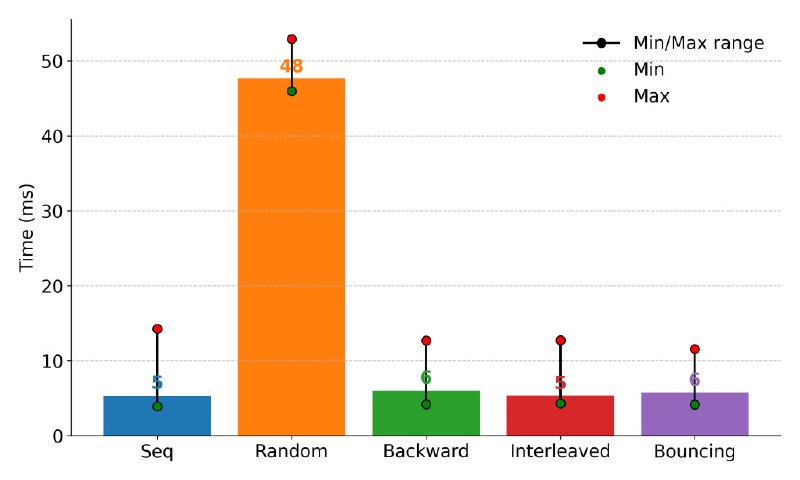
Для примера на скриншоте приведены 5 примеров доступа к элементам большого массива 32-разрядных целых чисел размером 64 Мбайта (в программе на Go)
1) Последовательный доступ (Seq): считываются каждые 8 элементов подряд.
2) Случайный доступ (Random): считываются каждые 8 элементов в произвольном порядке.
3) Обратный доступ (Backward): считываются каждые 8 элементов с конца массива.
4) Перемежающийся доступ (Interleaved): считываются каждые 8 элементов, начиная с первого, третьего, второго и далее.
5) "Перепрыгивающий" доступ (Bouncing): считываются каждые 8 элементов, начиная с первого, последнего, второго, предпоследнего и так далее.
Можно увидеть, что случайный доступ работает гораздо медленнее, чем остальные варианты, что наглядно демонстрирует, насколько хорошо процессоры умеют предсказывать обращение к данным и что следует учитывать при работе с данными
Post #2032
1.97K
- 👍 11
- 🤔 4
- 🤓 1