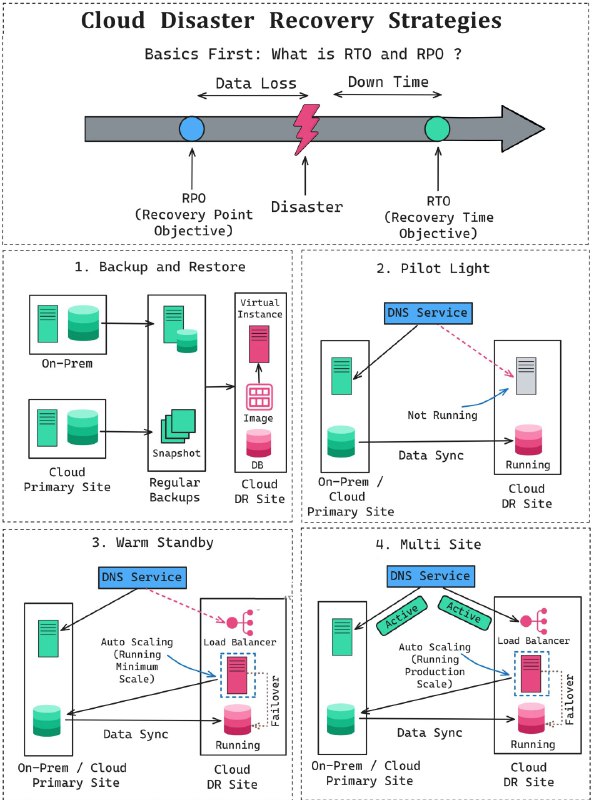
Стратегии аварийного восстановления облачных систем и веб-приложений
(описание к предыдущему посту)
Любая стратегия аварийного восстановления начинается с определения следующих параметров:
1. RTO (Recovery Time Objective) — целевое время восстановления:
* Какое время простоя допустимо для вашей системы?
2. RPO (Recovery Point Objective) — целевая точка восстановления:
* Какой объем потери данных допустим?
Стратегии аварийного восстановления
1. Резервное копирование и восстановление
Создание периодических копий данных и систем для последующего восстановления при возникновении аварии.
Характеристики:
* RTO: от нескольких часов до нескольких дней
* RPO: от последнего успешного резервного копирования до нескольких часов
2. Пилотный лайт (холодный резерв)
Поддержание основных компонентов в режиме ожидания для быстрого масштабирования инфраструктуры при аварии.
Характеристики:
* RTO: от нескольких минут до нескольких часов
* RPO: зависит от частоты синхронизации данных
3. Warm Standby (теплый резерв)
Подготовка частично функционирующей среды с актуальными данными для минимизации времени простоя при восстановлении.
Характеристики:
* RTO: от нескольких минут до нескольких часов
* RPO: последние несколько минут или часов
4. Hot Site / Multi Site (горячий резерв)
Работа полностью дублирующей, активной производственной среды параллельно с основной системой, обеспечивающей непрерывность бизнес-процессов.
Характеристики:
* RTO: практически нулевое или несколько минут
* RPO: минимальный, часто в пределах последних нескольких секунд
Post #1990
1.98K