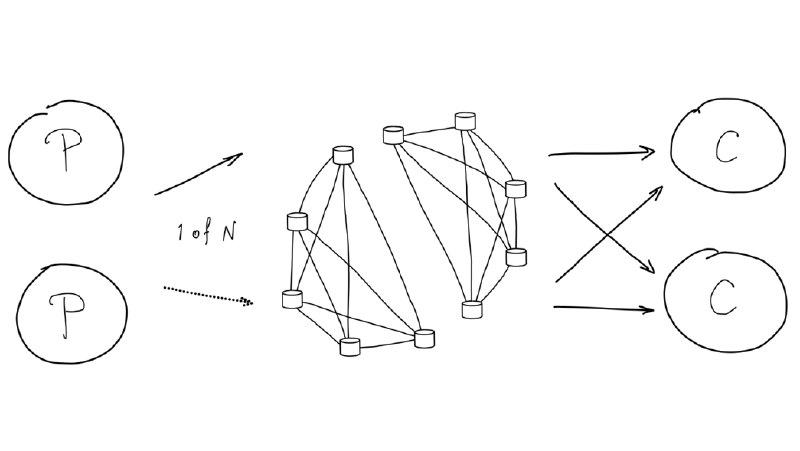
Очереди – что сложного то?
Знание и понимание очередей очень важно для разработчика. Очереди обеспечивают распределение ресурсов, репликацию сообщений, отказоустойчивость, надёжность передачи, гарантию доставки и коммуникацию микросервисов.
Подождите, очередь – это когда с одной с стороны положили, а с другой стороны кто-то забрал? Почти, но всё немного сложнее. Особенно в распределённых системах, особенно когда сообщений десятки тысяч в секунду.
В статье Соседняя очередь всегда движется быстрее автор со всех сторон рассматривает очереди. Очень захватывающее чтиво, наталкивающее на множество размышлений.
Начинается всё с базовых понятий, какие вообще бывают способы организации очередей: put/take, pub/sub, request/response.
Для применения очередей существует множество инструментов.
– Apache Kafka реплицируемый шардируемый лог сообщений для стриминга. Мы кафку очень любим, и о ней были отдельные посты (раз, два)
– RabbitMQ – традиционный pub/sub broker. В отличие от Kafka, у кролика нет ограничений на количество потребителей. Кролик часто используется как шина данных между сервисами
– NATS обеспечивает быстрый неперсистентный обмен сообщениями, высокую производительность и масштабируемость
– Tarantool – это in-memory db, которая может быть использована для организации очередей. Примечателен тем, что можно написать свою очередь на стероидах, со своим процессингом, логикой и приоритетами
На самом деле очень важно знать особенности и отличия этих инструментов, чтобы применять их к месту. На этот счёт в конце статьи у автора также есть размышления.
Напишите в комментариях, какие системы очередей вы знаете или используете на практике. За что их любите или не любите?
Говоря о проблемах – они у очередей есть.
– на уровне алгоритма важно решить, что делать при отказе консьюмера, который уже взял сообщение. Best Effort – просто вернуть сообщение обратно. Но не во всех брокерах так можно. В таком случае можно настроить dead letter queue – отдельную очередь со своей логикой обработки таких сообщений.
– а ещё бывают проблемы приоритизации, когда из-за множества задач с высоким приоритетом консьюмер может никогда не добраться до задач с низким.
– на сетевом уровне существует undefined behavior, то есть сообщение отправлено, но мы не знаем, оно дошло и получено или потерялось
– помимо сети есть диск, который влияет на пропускную способность и задержку в обработке, которая может оказаться не предсказуемой
Чтобы обеспечить доступность (avalability) и надёжность (durability) применяются разные топологии:
– single instance – самый простой вариант. Один брокер, одна очередь, продюсер и консьюмер. Немасштабируемо, низкая доступность и надежность.
– multi instance – можно масштабировать и ставить столько очередей сколько нужно. С надежностью и доступностью получше, но если одна из очередей грохнется, то данные из нее потеряются.
– идём дальше и дублируем уже сами очереди
– автор не останавливается на этом и рассказывает о реплицировании, реплика-сетах, кворумах, кворумных очередях.
Познакомившись с различными сложностями понимаешь, что хорошо бы всё это мониторить. Существуют следующие метрики: размер очереди, время обработки сообщения, количество потерь и отказов.
И всегда нужно быть готовым к самому худшему – к падению. Для этого существуют политики отказа, например, можно отказаться от приёма новых сообщений. Если нельзя, то можно уничтожать старые сообщения и продолжать принимать новые. Как вариант, когда часть сообщений ещё живая, а часть старая, можно попробовать обрабатывать живые, а потом вернуться к старым.
Напоследок ценная мысель: если вы не знаете, как ваша система падает и поднимается, быстро вы её не поднимите.
#skills
Post #334
1.23K