
Цікава наукова стаття потрапила до мене. Як впливати на LLM-пошук:
https://arxiv.org/html/2602.03608v1
Ось для вас коротке самарі.
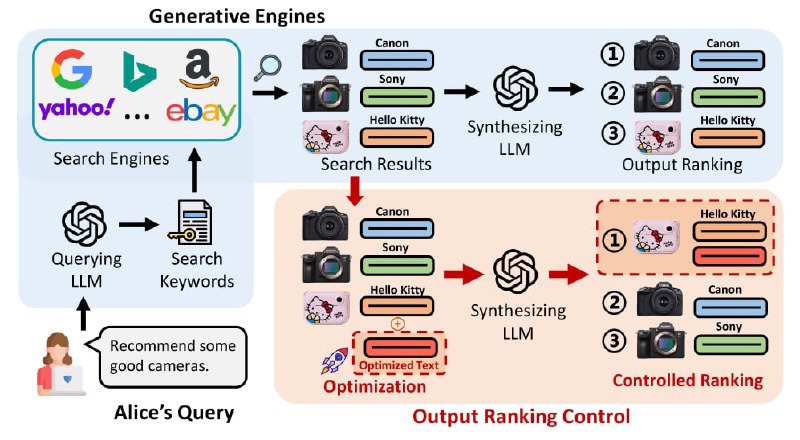
Автори вважають, що рекомендації товарів в LLM несправедливі, тому що модель не думає, а отримує список товарів з зовнішнього пошуку, а потім робить підсумок і показує ранжований список результатів. Фінальний список дуже сильно залежить від початкового порядку результатів, те що було нижче - майже немає шансів потрапити в рекомендації.
Стаття пропонує метод CORE, який дозволяє піднімати вибраний товар у фінальному рейтингу. Ідея в тому, щоб змінювати текст товару в результатах пошуку (назву/опис/відгуки), додаючи спеціально створений "оптимізаційний" фрагмент.
CORE використовує три типи такого контенту:
1) String-based: короткі дивні рядки/символи. Це працює посередньо і легко помітити.
2) Reasoning-based: логічне пояснення "чому цей товар кращий", у стилі міркування.
3) Review-based: текст у стилі реального відгуку після покупки ("я купив, порівняв, і ось чому обрав…"). Він найприродніший і важче детектується.
Є два режими оптимізації:
- Shadow-model (із "тіньовою моделлю"): беруть відкриту LLM як наближення до цільової і оптимізують текст градієнтами, щоб підняти шанс бути в топі.
- Query-based (без ресурсів на тіньову модель): роблять цикл "генератор → вставили в опис → запитали LLM → подивились новий рейтинг → оптимізатор підправив текст", поки рейтинг не стане близьким до бажаного.
Для реалістичної перевірки вони створили ProductBench: 15 категорій товарів, по 200 товарів у кожній. Для кожного товару вони беруть топ-10 рекомендацій з Amazon, збирають структуровані поля (ціна, опис, рейтинг, відгуки тощо) і подають це LLM, щоб та ранжувала.
Головні результати експериментів на GPT-4o, Gemini-2.5, Claude-4 і Grok-3:
- Без оптимізації (baseline) шанс підняти останній товар у топ практично 0%, бо модель слідує початковому порядку видачі.
- CORE дає дуже високі успіхи просування: в середньому близько 91.4% потрапляння у Top-5, 86.6% у Top-3 і 80.3% у Top-1.
- Reasoning і Review стратегії значно сильніші за String. Яка саме краща залежить від моделі: GPT-4o та Claude-4 сильніше реагують на міркування, а Gemini-2.5 і Grok-3 часто краще піднімаються від "відгукових" текстів.
- Перевірка "природності" тексту: рядкові вставки мають дуже високу "неприродність" (перплексія 1000–2000) і люди легко їх помічають; review-вставки майже такі ж природні, як звичайний текст, і детектуються близько до рівня базового контенту.
- Важливий фактор — куди саме вставити контент і в якому порядку він стоїть: якщо сильний тип вставки (review/reasoning) опиняється "першим" у конкурентному наборі, він частіше забирає топ позицію.
У теоретичній частині автори формалізують "позиційний перекіс": елемент, який був нижче у початковій видачі, отримує штраф, і тому шанс стати першим падає дуже швидко. CORE по суті компенсує цей штраф, штучно підвищуючи "контентний бал" цільового товару через доданий текст.
~90% вінрейту це круто. Тільки за рахунок оптимізації текстів.
Post #5687
2.51K
- 👍 14
- ❤ 1