Используем ИИ строго не по назначению.
Заметки про ИИ, IT, компьютерные игры, и всякие инженерные интересности.
Post #5349
4.63K
 DE
@derplearning
Showing posts older than #5350 · Back to latest


Forwarded from Neural Shit
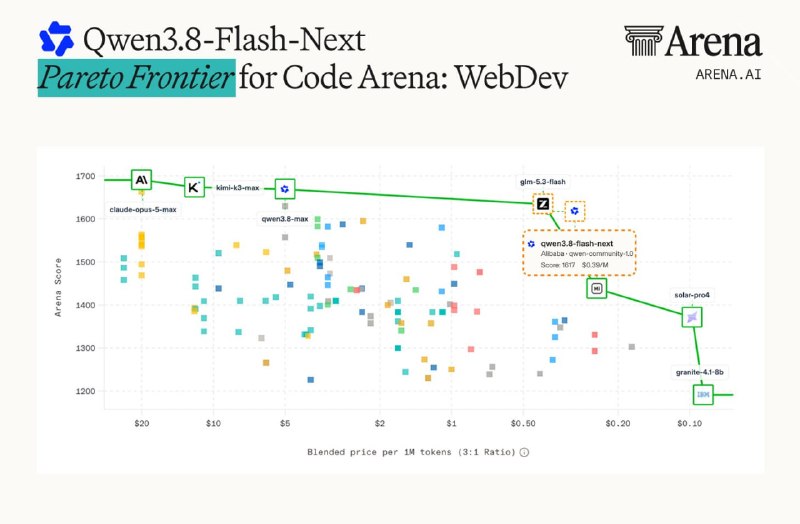



Forwarded from Старший Авгур


Derp Learning Наконец дошли руки поковырять Qwen 3.8-27b Как говорится, мое увожение. На мои 16гб комфортно влез Qwen3.8-27B-UD-Q3_K_XL от unsloth --ctx-size 100535 -ngl 99 -fa on --cache-type-k q4_0 --cache-type-v q4_0 --jinja --reasoning-effort medium --no-context…
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git fetch origin pull/27342/head:pr-27342
git switch pr-27342

# NVIDIA CUDA
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_CUDA=ON
cmake --build build -j

# Apple Silicon
cmake -B build -DCMAKE_BUILD_TYPE=Release -DGGML_METAL=ON
cmake --build build -j
llama-server.exe -m "Qwen3.8-27B-UD-Q3_K_XL.gguf" -md "Qwen3.8-27B-DFlash2-Q4_K_M.gguf" --alias qwen38 --port 8080 --ctx-size 95536 -ngl 99 -ngld 99 -fa on --cache-type-k q4_0 --cache-type-v q4_0 --jinja --reasoning-effort medium --no-context-shift --cache-reuse 256 --spec-type draft-dflash --spec-draft-n-max 3 -b 2048 -ub 512 --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.0 --tools all --parallel 1