
Post #23187
8


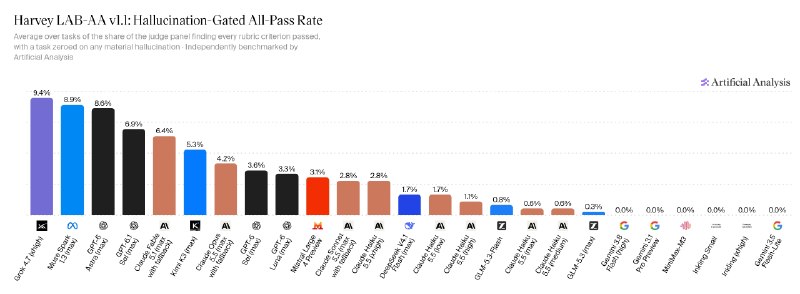
Это прямо тренд сегодняшнего дня – оценка того, насколько модели не просто справляются с работой, а насколько делают её правильно, точнее это тренд нового этапа в развитии LLM - зрелости моделей, они стали взрослыми и требования к ним теперь соответствующие, правда, в этом случае это скорее исправление проблемы в бенчмарке, которая приводила к неправильной завышенной оценке – Artificial Analysis (на этот раз это действительно Artificial Analysis) выпустили новую версию юридического бенчмарка Harvey LAB-AA (Legal Agent Benchmark), в которой учитывается есть ли в ответе галлюцинации и это обрушило результаты моделей и перестроило лидерборд (1 картинка - старый лидерборд вверху, новый внизу). Вторая картинка это количество галлюцинаций на ответ: красный столбик серьёзные ошибки, они и учитываются, аннулируя результат модели, голубой - незначительные, они не учитываются. Третья картинка полный набор протестированных на данный момент моделей