TGViewer
Channel Public Channel
я обучала одну модель

я обучала одну модель

@def_model_train

Shitposting on various subjects

PS рекламы в канале нет
Subscribers
4.48K
Photos
458
Videos
29
Links
385

Showing posts older than #853 · Back to latest

Older Posts 13 shown
Post #852 2.13K
Какие-то новости (или уже не новости?) про Stable Diffusion – открыта бета версия веб-интерфейса модели, и вроде есть слух, что в понедельник веса уже релизнут

Бета вот, вроде бы каждому сейчас дают по 200 промтов бесплатно, но нигде увы эта информация не отражается

https://beta.dreamstudio.ai/dream
  • 👏 8
  • 🎉 2
Post #850 1.76K
Не кабанчиком единым
  • 😁 7
Post #849 3.92K
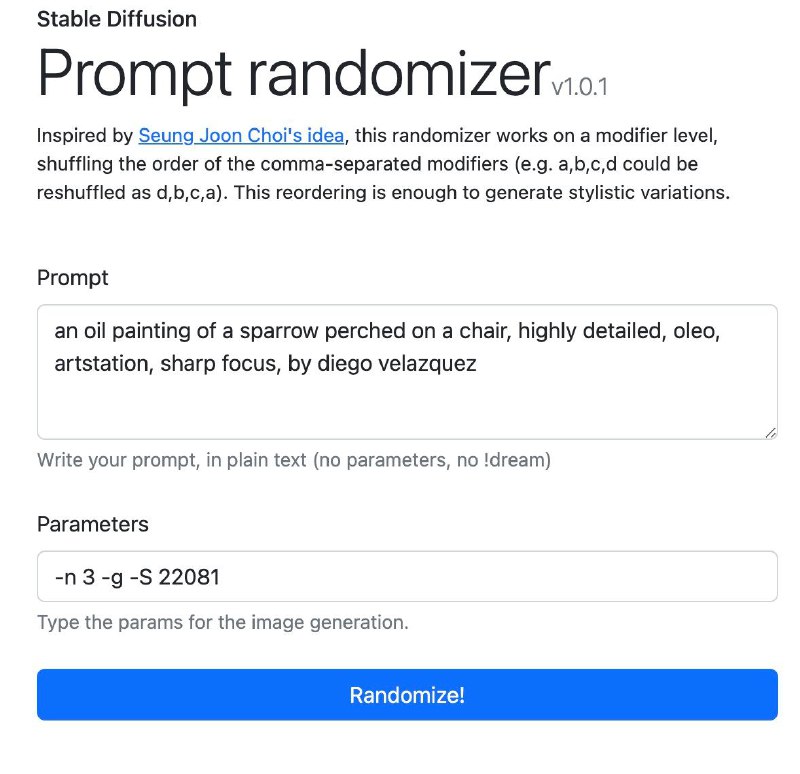
Для stable diffusion уже оказывается выпустили рандомайзер промтов 👏
  • ❤ 8
  • 🔥 5
  • 👍 1
  • 👏 1
  • 🤩 1
Post #848 2.25K
Жду, когда после Stable Diffusion отменят и OPT-175B….
  • 🔥 9
  • ❤ 6
  • 😁 4
  • 💩 1
Post #847 2.56K
Demystifying Noise Contrastive Estimation

Хороший пост про то, как вычисляются разные вариации contrastive loss’ов. Изначально проблема состоит в том, что если мы хотим выдавать скор того, насколько объект x (например, какое-то слово) подходит под контекст c, то эту оценку нужно нормализовать, посчитав скоры еще для всех остальных возможных x (например, для всех слов в словаре). Есть несколько подходов, как избавиться от этого шага:
– Local NCE: свести все к бинарной классификации – предсказываем, является ли x положительным примером, или он насемплирован из случайного шума. здесь функция аппроксимирует напрямую условную верятность p(x|c)
– Global NCE: монте-карло-семплим k примеров, и предсказываем, какой из k+1 является реальным. здесь функция аппроксимирует p(x|c) / q(x), где q – какое-то заданное случайное распределение, что тоже отбрасывает необходимость нормализовать на все остальные возможные x
– InfoNCE: по сути сводится к KL-дивергенции – чем больше непохожие (=независимы) наши примеры, тем больше KL дивергенция будет стремиться к 0

В посте собственно разбирается, как получаются лоссы / training objectives, в чем их допущения, и как вообще получается с математической точки зрения, что contrastive estimation отражает mutual information данных

https://jxmo.io/posts/nce
  • 🔥 4
  • 👍 2
Post #846 2.07K

Forwarded from Соне нравится (или нет)

Смотрите, что выкатили ребята из Самсунга, Яндекса и Сколково.

MegaPortraits: One-shot Megapixel Neural Head Avatars

Скажу сразу, что сейчас поступаю как AI-инфоцыганка, потому что не прочитала ещё пейпер, не выделила для себя плюсы и минусы разработанного подхода, а уже пишу про него. Если даже авторы и выложили черрипики, то нельзя преуменьшить значимость проделанного ими труда.

Предложенное решение позволяет пременить анимацию лица из видео среднего качества на изображение высокого качества.

Модель учится в два этапа:
1) базовая модель с двумя энкодерами для захвата volumetric фичей и для захвата информации об анимации, а также с двумя warping-генераторами, одной 3D CNN и 2D CNN в конце;
2) image-to-image translation для получения high resolution (1024x1024) изображения.

И нельзя забывать, что это One-Shot подход, т.е. вам достаточно одной фотографии или фрейма из видео для получения анимированного аватара. Также авторы пишут, что полученную модель можно дистиллировать в легковесную модель, которая способна работать в риалтайме (130 fps на одной GPU).
  • 👍 10
  • 🔥 5
  • 👎 4
Post #845 2.8K
Прикол из мира OpenAI: в последнем апдейте dalle 2 они в том числе пообещали увеличить diversity генераций, а именно сделать так, чтобы в них было больше женщин и не белых людей. По факту это видимо делалось не дообучением и не манипуляцией латентного пространства, а добавлением слов 'black' или 'female' в промты юзеров случайным образом 🤡

современные проблемы требуют современных решений
  • 😁 35
  • 🤮 8
  • ❤ 4
  • 👍 2
  • 🤡 1
Post #843 2.55K
Quark: Controllable Text Generation with Reinforced [Un]learning

Попыток скрестить NLP и RL было уже много, одна из самых известных таких моделей от OpenAI ипользует Proximal Policy Optimization для апдейта градиентов. Проблема с PPO в том, что в ней очень много гиперпараметров, их сложно подбирать, плюс, необходимо хранить много весов

Ресерчеры из Allen NLP сделали проще и, кажется, эффективнее:
1. Сначала генерим кучу семплов моделью
2. Потом с помощью классификатора нужного признака (например, классификатора токсичности) скорим их
3. Далее переводим скоры в дискретные значения. По сути наблюдения группируются на ранги согласно их квантилям, получаются категории R1… Rk
4. Каждый ранг получает свой токен. Этот токен ставится перед соответствующим текстом, и модель тренируется на таких данных, как обычно в conditional generation
5. На новом exploration step мы кондишенимся на самый высокий ранг и снова генерим примеры – по сути итеративно двигаемся в латентном пространстве ближе к желаемому признаку текста. И повторяем цикл обучения заново

Что примечательно, Quark обгоняет по метрикам и по human preferences гораздо более тяжелые PPO и PPLM
  • 👍 16
Post #836 2.86K
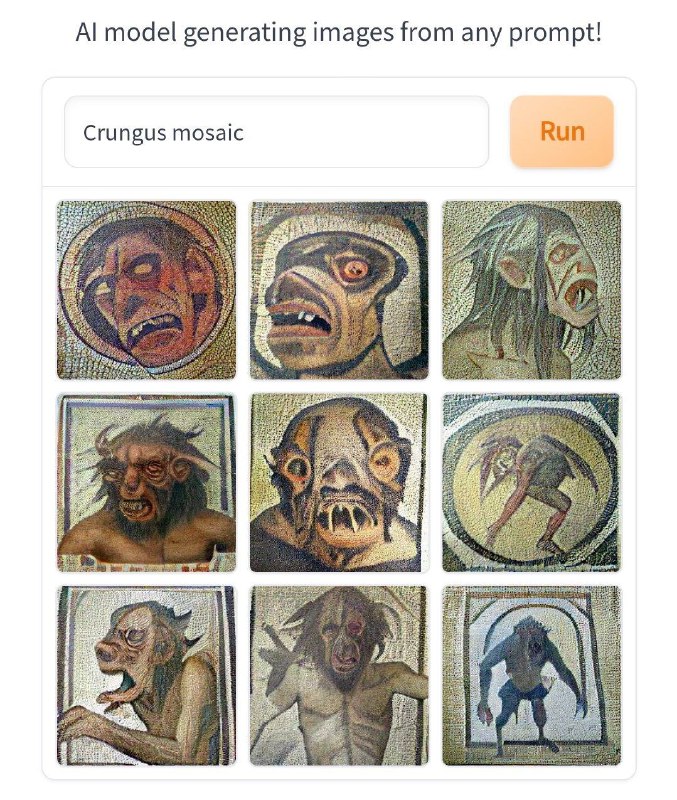
Очень интересные вещи происходят в твиттере: один пользователь закинул в dalle mini выдуманное им рандомное слово Crungus. И получил довольно конститентный набор какой-то хтони. Потом оказалось, что у всех запрос Crungus выдает именно эту хтонь

При чем, dalle даже может рисовать Crungus’а в разных сеттингах, например, на отдыхе, на рейве, на свидании, крангуса-младенца, мозаику крангуса…

Выглядит подозрительно, будем следить за развитием событий 🧐
(за ночные кошмары простите меня все)
  • 🔥 35
  • 👍 6
  • 😱 3
  • 👏 1
Post #834 2.93K
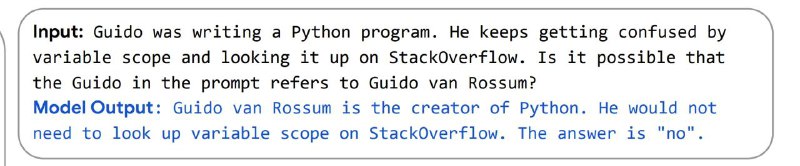
из PaLM кстати мой любимый пример вот этот, очень странно думать что сетка а) понимает отсылку, которую не то чтобы очень просто понять сходу б) имеет представление что такое stackoverflow….
  • 🔥 33
Post #832 2.69K
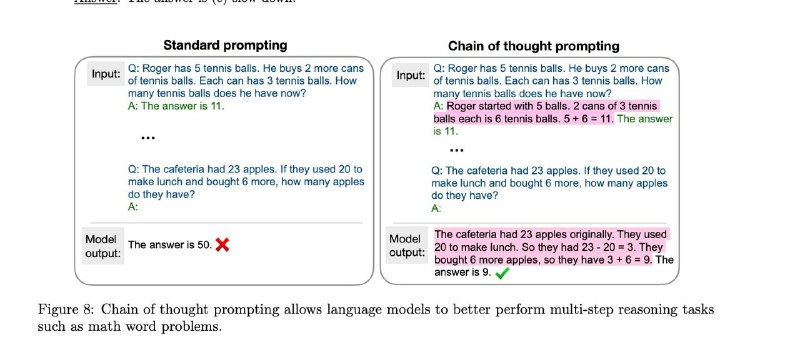
Вообще попытки в reasoning были в еще нескольких недавних моделях. Например, в гугловской PaLM показывали, что если предоставить в промте цепочку размышлений (chain of thought), то модель прийдет к правильному решению в логических задачах (ну, как теперь оказалось, она и с chain of though сама справится тоже)

Или вот Flamingo просили объяснить, почему картинка смешная, и после ризонинга она приходила к разумному объяснению, даже если сходу она все еще не могла ответить. Кажется, что скоро мы увидим еще статьи, почему с LM и VLM так хорошо работают логические подводки, и не weak AGI ли это
  • 👍 9
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →