TGViewer
Channel Public Channel
я обучала одну модель

я обучала одну модель

@def_model_train

Shitposting on various subjects

PS рекламы в канале нет
Subscribers
4.48K
Photos
458
Videos
29
Links
385

Showing posts older than #758 · Back to latest

Older Posts 20 shown
Post #757 1.47K
Классный фреймворк для topic modeling – можно подрубить какие угодно эмбеддинги на ваш выбор (или оставить дефолтные), и кластеризировать тексты в zero-shot. По умолчанию это multilingual классификация, так что на инференсе модель справится с текстами и на тех языках, которые во время обучения она могла и не видеть

Помимо того, что это позволяет не тратить время на то, чтобы писать кластеризацию руками, у них есть хороший пайплайн для автоматического препроцессинга текстов. И еще есть прикольный сабмодуль для human-in-the-loop классификации (называется Kitty 🥺), где можно самому поразмечать лейблы для текстов и потом инференсить модель
GitHub GitHub - MilaNLProc/contextualized-topic-models: A python package to run contextualized topic modeling. CTMs combine contextualized… A python package to run contextualized topic modeling. CTMs combine contextualized embeddings (e.g., BERT) with topic models to get coherent topics. Published at EACL and ACL 2021 (Bianchi et al.)....
Post #754 1.68K
Хороший лонгрид для тех, кто тоже сейчас страдает с поступленим в зарубежные маги. У автора специфичный выбор программ (не в смысле плохой, а в смысле критерии подбора могут распространиться не на всех), но имхо материал очень полезный. Пожалуй основная мысль в том, что да, если вы гений с кучей достижений и ачивок, это очень поможет вашему поступлению, но где-то 50% успеха все равно приходится на грамотный поиск и выбор подходящих программ и стипендий.

Еще статья неплохо может сориентировать в плане того, сколько документов в конечном итоге вам нужно будет подготовить, и с какими объемами бюрократии придется столкнуться (спойлер: с огромными). Очень понравилось, что там максимально подробные примеры с конкретным процессом подачи через разные студенческие сервисы из реального опыта, так что может быть кому-то еще тут будет полезно почитать:
Вастрик.Клуб Как я в магистратуру в Европу (и не только) поступал — Вастрик.Клуб TL;DR: Это лонгрид о моем поступлении в магистратуру за рубеж из Украины с подробностями о процессе выбора университетов, программ, стипендий, написа…
Post #752 1.39K

Forwarded from Мишин Лернинг

🧛‍♀️🐍 Colab StyleGAN3 + CLIP by Мишин Лернинг

Подготовил для вас отполированную и доведённую до ума версию colab для генерации арта по текстовому описанию!

🤖 Для гиков: за основу взял выложенный вчера вечером в твиттере nshepperd1 колаб StyleGAN3 + CLIP, с прикрученным интерфейсом от nn_for_science. Улучшил стабильность и качество генерации, перенеся идеи, которые считаю важными, из vqgan версии.

🎓 Что улучшено в версии от “Мишин Лернинг”:
▪️ Добавил дифференцируемые аугментации. Сильно накидывают в качестве
▪️ Увеличил размер батча для CLIP на каждом шаге оптимизации
▪️ Увеличил размер кропов в батче, на которые смотри CLIP
▪️Подобрал параметры оптимизатора и ema по z между шагами

🔮StyleGAN3 + CLIP by Мишин Лернинг colab

p.s.: prompt для анимации к посту: “A vampire woman with long hairs made of snakes in style of Gustav Klimt”
Post #751 1.93K
У Rivers Have Wings как всегда нерельно красивый AI art, это вот только что вышедший StyleGAN3
Post #750 1.6K
новое поколение девелоперов going strong 💪
Post #749 1.37K
Есть очень классное видео с объяснением того, как работает Perciever и в чем суть архитектуры. Perciever – это сетка, обученная для мультмодельных задач, то есть на вход может поступать много разных типов информации (текст, изображение, звук и т.д.), и сама нейронка не знает, что это именно за данные. Помимо того, что нужно уметь справляться с разными инпутами, в этом случае также встает проблема с размерностью, так как те же самые изображения, разбитые на пиксели, продуцируют такой размер входных данных, который классический транфсормер не особо может обработать (поэтому в предшествующих решениях картинку разбивают на патчи, например)

Если очень кратко суммировать:
1. Сначала создается latent array небольшого размера, такого, что классический self-attention может его обработать (условно, каким-то образом мы инициализируем вектор)
2. Берутся входные данные (например, картинка) и растягивается в byte array. Этот array может быть очень большой. Поскольку данные просто растягиваются, а не преобразовываются неким образом, сетка становится инвариантна с типу данных
3. Из этой входной информации получаются матрицы K и V, которые потом пойдут на вход в механизм аттеншена. Матрицу Q мы получаем из небольшого latent array, и она также имеет небольшую размерность –> после аттеншена мы получаем гораздо более короткую последовательность, чем входные данные.
Интуитивно можно понимать, что Q – это то, что мы хотим выучить на основе данных, а K и V – на что нам обращать внимание при этом (что каждый кусочек входных данных нам может сообщить в разрезе того, что мы хотим выучить)
4. Потом этот преобразованный после аттеншена вектор попадает в архитектуру трансформера, он выдает снова преобразованную последовательность, и мы снова 'добавляем' информацию из исходных данных на каждой такой итерации.
5. Архитектура в итоге работает как RNN – сначала мы инициализировали некий Q, получили K и V из данных, подали их в аттеншн и потом в трансформер, получили новый latent array, из которого снова достали Q, и снова получили K и V из данных. То есть на 2+ этапе Q уже содержит информацию о данных, и дальше мы ее 'уточняем'

Еще авторы позволяют weight sharing, чтобы снизить число параметров (получается сопоставимо с ResNet), и обучают на картинках, видео, аудио и 3D clouds. Результаты работы сетки можно посмотреть здесь, если не видели, они довольно впечатляющие

Как отмечают в коментах, подтверждается тезис Шмидхубера о том, что чем больше архитектура похожа на LSTM, тем она лучше

https://www.youtube.com/watch?v=P_xeshTnPZg
YouTube Perceiver: General Perception with Iterative Attention (Google DeepMind Research Paper Explained) #perceiver #deepmind #transformer Inspired by the fact that biological creatures attend to multiple modalities at the same time, DeepMind releases its new Perceiver model. Based on the Transformer architecture, the Perceiver makes no assumptions on the modality…
Post #748 1.19K
Фан фект – в статье к Perceiver неиронично есть ссылка на 'Критику чистого разума' Канта
Post #746 2.33K
Состояние ресерча в ИИ:
Post #745 1.58K
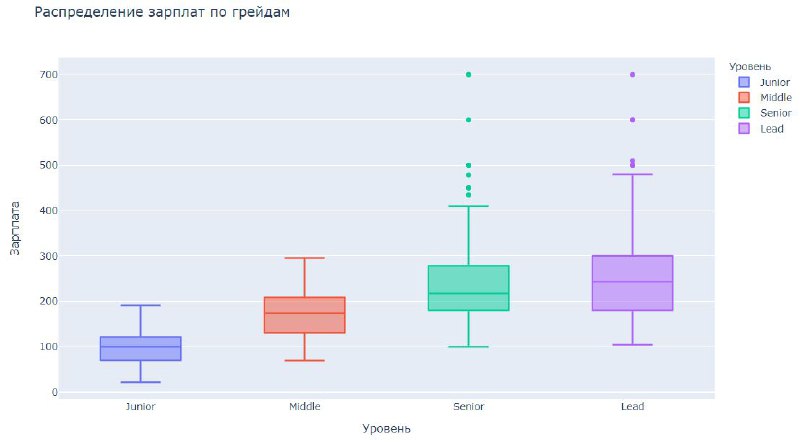
В августе на хабре вышел интересный анализ зарплат в дата саенс (на основе данных из чатика ODS), и сейчас появилось сопровождающее видео к нему. Не то чтобы там совсем новые и неожиданные вещи, но:
1. Еще раз подтверждается, что компании зачастую не повышают зарплаты текущим сотрудникам, но хайрят на аналогичные позиции по более высокой ставке. Поэтому для многих проще не ждать повышения, а просто перейти на новое место.
2. Дата саентисов ищут больше, чем аналитиков и дата инженеров, и им же в среднем больше платят. Вообще аналитикам повезло меньше всех, так как если представить специализацию как фичу в регрессии, то лейбл аналитика в среднем снижает ожидаемую зарплату 🤡 Но зато у них больше всего рост зп за 2021.
3. Очень сильно растет спрос на мидлов и синьоров, но поскольку их не может резко появиться на рынке много, зарплаты у них растут соответствующе сильно и быстро (+10% и +15%, соотвественно у лидов +22%). Зарплаты у джунов за 2021 не выросли никак.
4. Самый большой скачок зп – между джуном и мидлом, это +74k (+71%). Зато зарплаты синьоров и лидов отличаются не сильно.
5. Больше всего доплачивают за Кубер, Кафку и PyTorch.
Хабр Анализ вакансий и зарплат в Data Science Привет, Хабр! Делимся нашим исследованием вакансий и зарплат в сфере data science и data engineering. Спрос на специалистов растет, или рынок уже насытился, какие технологии теряют, а какие набирают...
Post #742 1.21K
Post #740 1.27K
Молимся за сисадминов
Post #736 1.13K
parhelia / иногда Нашёл классный сайт - вебморду для нейросетки Hi-Fi-Gan, озвучивающей введённый текст одним из предсобранных голосов. Датасетов очень много - писатели, актёры рэперы, президенты. Отличный инструмент для генерации вокальных безделушек заместо киношных сэмплов.…
Audio
Сложно было удержаться, поэтому вот vocode Елизаветы Второй читает Кендрика Ламара (vocode Ламара тоже там есть)

My left stroke just went viral
Right stroke put lil' baby in a spiral
Soprano C, we like to keep it on a high note
It's levels to it, you and I know
Bitch, be humble
Post #735 824

Forwarded from parhelia / иногда

Нашёл классный сайт - вебморду для нейросетки Hi-Fi-Gan, озвучивающей введённый текст одним из предсобранных голосов. Датасетов очень много - писатели, актёры рэперы, президенты.
Отличный инструмент для генерации вокальных безделушек заместо киношных сэмплов.

https://vo.codes/tts/
Fakeyou FakeYou Celebrity AI Voice and Video Generator FakeYou lets you generate voices and videos using AI technology
Post #733 1.1K

Forwarded from 3D ML / World Models

Привет всем исследователям и разработчикам!

Сталкивались ли вы с проблемой визуализации глубокой архитектуры или ее частей для научной статьи или для лучшего ее понимания? Если вдруг вам понадобиться решать эту задачу, то обратите внимания на репозиторий Tools-to-Design-or-Visualize-Architecture-of-Neural-Network от исследователя Ashish Patel.

23 библиотеки разной степени сложности и функциональности, Наверняка каждый найдет для себя что-то интересное =)
  • ❤ 1
Post #731 1.43K
У Яндекса крутое обновление камеры вышло, по сути сейчас они перегнали Google Lens по фунционалу. Что примечательно, в 2019 Яндекс заспускал (и активно пиарил) приложение Sloy, которое умело распознавать на видео бренды одежды, и рекомендовало видео с похожими вещами. Приложение потом закрыли даже до завершения бета-тестирования, но кажется, что сейчас начнут пилить нечто аналогичное, потому что CV для ритейла может получиться очень крутой
vc.ru «Яндекс» обновил камеру в своём приложении: научил её распознавать еду и показывать калории — Техника на vc.ru Таня Боброва Техника29.09.2021
Post #729 1.51K
Чудеса нейминга в Вышке 🥵💞
Post #728 1.32K

Forwarded from ̶с̶а̶м̶̶о̶изолента мёбиуса

Недавно я уверовал в NLI.
Убедила меня в этом статья Entailment as Few-Shot Learner от FAIR. Помните, я писал про задачу RTE в составе SuperGLUE, в которой надо определять, следует ли второй короткий текст из первого?
Эта задача крута тем, что для её решения нужно прям серьёзно понимать смысл текстов, поэтому, если есть довольно большой и интересный датасет, то и модель можно обучить очень умную, а потом переиспользовать для других непростых задач. Например, определять, что из текста "Хочу поехать в Австралию" следует "Это текст про путешествия". Таким образом можно классифицировать тексты с очень небольшим числом обучающих примеров, или даже вообще без них. Собственно, авторы показали, что так можно выбить SOTA на ряде задач zero-shot и few-shot классификации.

Для русского я не нашёл предобученных моделей для NLI, и поэтому дообучил свою (BERT от DeepPavlov), вот она. Я, наверное, ещё дообучу её, увеличив обучающий корпус (в основном - переводами с английского). Но с ней уже можно играться 🙃
Post #727 1.39K
Вчера Facebook релизнул код для Instance-Conditioned GAN. Идея проста в своей гениальности – если раньше в мультиклассовых GAN'ах к случайному шуму при инициализации передавали указатель класса, чтобы модель лучше понимала, что именно ей генерировать, то теперь можно передать эмбеддинг из CLIP'а c описанием класса, который мы хотим получить, и тогда генерация будет больше 'сдигаться' к тому описанию, которое мы передали. К тому же, теперь можно не выбирать один из классов, а делать нормальный zero-shot

Очень прикольно это работает, если использовать и инициализацию изображения, и передавать описание, так как можно добиться переноса стиля или переноса контента (в оригинальной статье авторы, например, передают сетке изображение лабрадора с подписью 'хаски', и сетка генерит нечто между). Я попробовала из фотографии гор развернуть готический кафедральный собой, некоторые кадры у сетки получились прям красиво 🌚 В конечном итоге она решила кажется сгенерить собор в горах, в принципе fair enough

Колаб вот
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →