TGViewer
Channel Public Channel
黑科技资源分享

黑科技资源分享

@deeptech123

黑科技,工具白嫖频道。提供最新技术资源,网络安全,隐私保护,编程技术,Ai工具,网络资源,实力白嫖

内容有原创,有转载
所有转载内容均不会删除来源

随心分享,永不盈利,用爱发电。

好多资源就是转发的,原频道的频道链接我都会保留,本频道也欢迎各位转发,复制。

互联网本来就应该是共享,开放的世界,不应该人为的加上限制转发复制。

本群永不盈利,用爱发电,希望大家帮忙推广给朋友。我看到任何网络上优质资源都会发给大家。

感恩感谢大家!
Subscribers
3.56K
Photos
2.6K
Videos
521
Links
1.7K

Showing posts older than #4816 · Back to latest

Older Posts 18 shown
Post #4815 100
�🔥 【把 API Key、数据库密码、内网 IP 全部本地打码,让大模型"看得懂却看不见"】
📌
项目定位:
当你用 Cursor、Claude Code、Codex 写代码时,代码里的
sk-proj-...、ghp_...、mysql://root:Pass123@192.168.1.50:3306/db、客户手机号,都在你毫无察觉时被整段发给了外部模型厂商。**Maskit(数据面具)** 就是在你的终端和外部 AI 服务之间架起的一道**本地隐私脱敏网关**:请求出网前,敏感信息在本地被自动替换成 **结构化占位符**(如
{{CONNSTR_zkpmqx}}
、
{{PHONE_bcdfgh}}
);模型基于占位符正常推理作答;回复再以 SSE 逐事件流式还原 成原文。整个过程100% 本地运算、零遥测,你看到的体验和直连官方 API 毫无差别。
⚡️
核心优势:
▫️
19 类内置正则规则库:覆盖 API Key/Token、PEM 私钥、数据库连接串、手机号、身份证、邮箱、银行卡、内网 IP(10.x/172.16.x/192.168.x),支持自定义敏感词与正则扩展。
▫️
多轮会话占位符一致性:独创滑动窗口复用机制,"张三"在第 1 轮和第 10 轮始终映射同一占位符,长对话逻辑不串号。
▫️
毫秒级 SSE 流式接管:智能处理跨 chunk 占位符切片与缓冲区拼接,完整保留原生打字机体验,不卡顿、不迟滞。
▫️
免装根证书 + Fallback 兜底:多端口反代(18701 OpenAI / 18702 DeepSeek / 18703 Anthropic),无需安装自签名 CA;即使关闭代理,本地端口仍透明直连转发,AI 工具绝不断网。
▫️
审计与成本看板:全链路日志高亮对照、被动安全审计(泄露/换芯/越狱/命令执行)、Token 用量与费用估算。
🎯
实战落地场景:
▫️
后端工程师排障:直接把带密码的连接串丢给 AI 分析,不再需要手动改成
xxx
占位符。
▫️
接私活的独立开发者:客户生产环境的 IP、账号、内部项目代号,交给 Claude Code 前自动打码,规避合规风险。
▫️
金融/医疗/政企团队:用 Docker 在 NAS 或内网服务器部署私有网关(
ghcr.io/xiayutian11/maskit
),全团队共用一套脱敏规则,日志与费用集中管控。
▫️
重度 AI 编程用户:Cursor / Codex / Pi / OpenCode / Aider 只需把
base_url
改成
http://127.0.0.1:18701/v1
,即插即用。
🔗
项目直达:
https://github.com/xiaYuTian11/maskit
🏷
标签:
#数据脱敏
#隐私安全
#AI编程
#LLM网关
#Python
Post #4813 113
wx-download是基于浏览器扩展的微信公众号文章采集和下载工具,不经服务器,无需把 Cookie交给第三方,无需本地部署,免费开箱即用。本地直连公众号后台,批量采集正文与合集,并接入 AI 写作风格建模和 Skill 创作流程。
它的目的是成为智子X写作实验室的素材入口:先把公众号文章整理、正文采集、合集归档做好,再把这些本地素材连接到写作风格建模、Skill 生成和 AI 风格写作,让“采集文章”真正进入“学习写法、沉淀风格、辅助创作”的完整流程。
这是wx-download模块的独立仓库页,点击了解:
http://github.com/zhiziX/zhiziX-wx-download
Post #4812 120
在 Apple Silicon 本机跑通类 Jev 视觉推理,一张图一次回答几十个问题,直接给候选输出打分而不自回归生成。
https://github.com/hr98w/jev-visual
给 Apple Silicon 写的视觉模型推理练手项目,MLX 跑 Qwen3.5-0.8B,一张图能连答 1 到 64 道题,选项选择、是非、分级打分都行,每题最多 26 个候选。不走自回归写 JSON 的老路,多模态上下文只 prefill 一次,后面各题拼后缀批量读分。
Post #4811 114
拉完了 硬件总裁上新第 大概是 cook 觉得要拉完了 卸任了
Post #4810 121
Encoder 的卷土重来
BERT 本来是一条极有潜力的路线:高效地把输入压成 representation。但它停留在了 task-specific 时代,每个任务都需要微调。
GPT 早期同样如此,后来却沿着 scaling、in-context learning 和 instruction tuning 走向了 泛化,把自然语言变成 universal task interface。分类、判断、推理、工具调用,统统变成 generation。
于是 decoder-only 赢下了整个 paradigm,encoder 也失去了继续探索 general classifier 和 general representation model 的历史机会。
但 Agent 改变了 workload。模型开始面对越来越大的输入、越来越重的 KV cache、越来越频繁的循环调用,此时,用一个巨大的 decoder 完整 prefill,再 autoregressive decode 几个 token 来完成一次判断,开始显得昂贵。
Jev 恰好等到了这个窗口。它试图补上 BERT 当年没有走完的路线,保留 GPT 的 task generalization,同时重新获得 encoder 和 classifier 式的 decision efficiency,成为面向 service、面向 Agent 的 泛化 decision model。
Post #4809 118
浏览器指纹
ip隔离
浏览器防检测技术
是社交媒体多账号管理的基础
Post #4808 120
今天才发现Chatgpt(其实是里面的codex)把“正在压缩上下文”改成了“正在优化对话”。
Post #4807 130
codex 为啥 现在这么慢。。。慢的我想骂人
Post #4806 136
Dan 强调下一个科技大主题是 Sovereign AI(主权 AI):通用模型终将沦为商品化基础设施,真正高壁垒的护城河在于企业私有数据与掌控权。这跟PLTR的CEO Alex Karp成天喷Frontier模型公司的意思如出一辙!
数据主权与防污染:企业绝不会把核心资产暴露给通用模型厂商;加上公开数据面临竞争者污染的风险、可信度走低,用自有数据训练自控模型将成为刚需。
马斯克“减速”的小算盘:对于马斯克呼吁 AI 发展减速,Dan 直接点破:xAI 此时明显落后于 Anthropic 和 OpenAI,拖慢大部队的节奏纯粹是为了给自家追赶争取时间。
这逻辑很透彻,通用底层模型最后大概率走“打工化”的走量路线,谁手里捏着独家数据和控制权,谁才是真正坐拥金矿的人。我一早也说过判断,老马跟着一起喊减速,无非就是Grok离前面两位的差距还是肉眼可见的(4.7已经延误了,4.8基本赶上,5.0说要超越但who knows。。。)商业战场上哪有什么大慈大悲,说白了无非是“等我把跑鞋系好大家再重新开跑”的小算盘罢了🤣
Post #4805 113
需要一些 CSS 调整来修复 UI 故障
Post #4804 116
检测 Codex 实际回答的模型是否与所选模型一致,发现静默降级或换模型。
https://github.com/kiyoakii/is-gpt-nerfed
macOS 上的 Codex 缩水检测器,常驻菜单栏,判断所选模型是否真的在回答。插件逐轮读取 Codex 会话记录,零 token 开销地标记模型切换、推理力度降低、隐藏模型和小上下文窗口。
Post #4803 108
Jev开启了Agent分层的新范式,过去两年所有人都在写同一种 agent:一个强模型 + 一堆 prompt + 工具循环(配合各种harness、loop工程),该不该调这个工具、这请求有没有风险、该用哪个模型、输出对不对,全塞进同一个上下文,让它自己想。
这种范式在demo 阶段无敌,上生产撞三堵墙:慢、贵、说不清为什么。
判断和生成是两种事:判断要的是固定选项、可校准的概率、能调的阈值、能画的 ROC,生成模型给你的是一段"我觉得这个操作有风险,建议人工确认"(除了照办,无法量化)。
老板问你幻觉和误杀率多少?
>正在发生的迁移:单体 agent → 生成层 + 一堆小决策器,跟当年 PHP 单体拆成网关/鉴权/限流,是同一个剧本,要想开使用Jev,以下3步就可以开始:
1、把你 agent 里所有判断点标出来:工具授权、模型路由、内容准入、结果验证
2、每个判断点定义:标签集、阈值、两类误判各自的代价
3、三个状态:PASS / FAIL / 不确定,别让模型在没把握的时候硬猜,把不确定导给人
提醒一句:小模型专职判断不是新东西,传统 NLP 干了十几年,只是最近这两年被 LLM 的光盖住了,真正难的从来不是模型,是标注和调阈值:幻觉或者误杀率 3% 在 demo 里没感觉,在生产里就是每天几十个投诉。
还有:这层会让系统更复杂,不是更简单,只有当你的 agent 真在替人做有后果的事时,才值得加。
如果是做demo类的agent 不需要,但生产级agent需要,但是要在成本和带来的结果提升上找平衡点,如果为了1%话费1倍的成本调这个估计老板未必会同意。
Post #4801 111
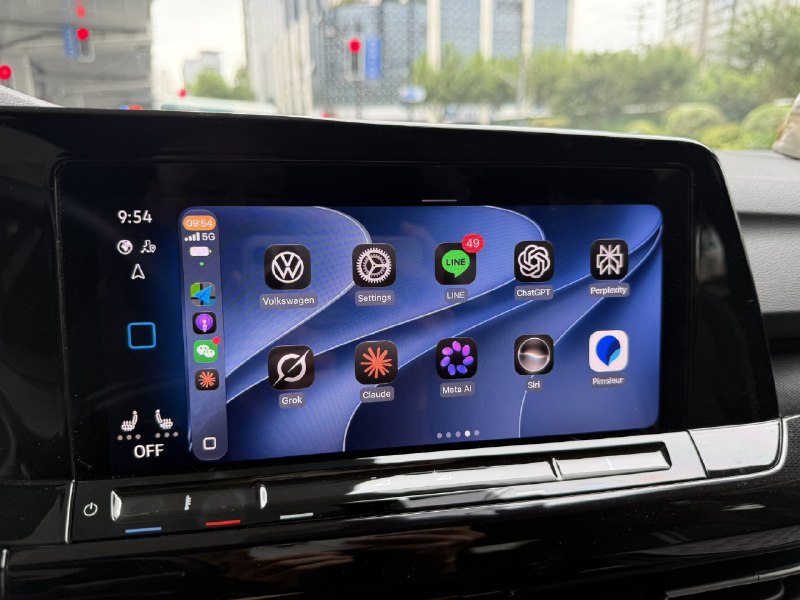
my VW golf is AI enhanced😆
Post #4799 109
韩国科技媒体 ETNews 报道称,受全球供应链调整及技术竞争加剧影响,韩国半导体与高科技产业正面临核心技术人才流失、市场份额被挤压等多重严峻挑战。报道指出,相关产业链的竞争格局正在发生剧烈变化,本土企业的优势正被削弱,行业前景引发深切担忧。
科技竞争的残酷性远超想象,危机往往隐藏于静水流深之中。唯有坚持自主创新与核心技术攻关,方能在时代变革中立于不败之地。
Post #4797 109
苹果香港官网在 iPhone 18 Pro 预售时临时取消 3D 交易验证,本想提升抢购体验,却再次沦为黑产批量盗刷的突破口。
普通持卡人未下单却遭遇批量盗刷(单笔最高损失达 11.4 万港元),而正常抢单的散客与代购反被银行风控锁卡。
黑产凭此前泄露的卡号与安全码无卡下单并转卖牟利;早在去年 iPhone 17 首发夜,同样的风险漏洞就曾爆发过一次。案发仅两天警方已接报 700 多起案件,涉及金额达 1470 万港元,案件已定性为欺骗取财,目前尚无嫌疑人落网。
为了追求极致抢购速度而一再牺牲基本的支付安全防线,这种跌倒在同一块石头上的风险漏洞实在令人唏嘘。在用户的资金安全面前,任何以“用户体验”为名的风控降维,终究都是不可承受的本末倒置。
Post #4796 125
Re 妈的,我也完蛋了,我贪小便宜,免费送我glm-3.5-flash 那3天,我大概用了zcode好几个小时,是不是也完了?被偷家了
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →