TGViewer
Channel Public Channel
Generative Ai

Generative Ai

@deeplearning_ru

Анонсы интересных библиотек и принтов в сфере AI, Ml, CV для тех кто занимается DataScience, Generative Ai, LLM, LangChain, ChatGPT

По рекламе писать @miralinka,
Created by @life2film
Subscribers
3.7K
Photos
319
Videos
131
Links
888

Showing posts older than #1160 · Back to latest

Older Posts 19 shown
Post #1159 795

Forwarded from Вайб-кодинг
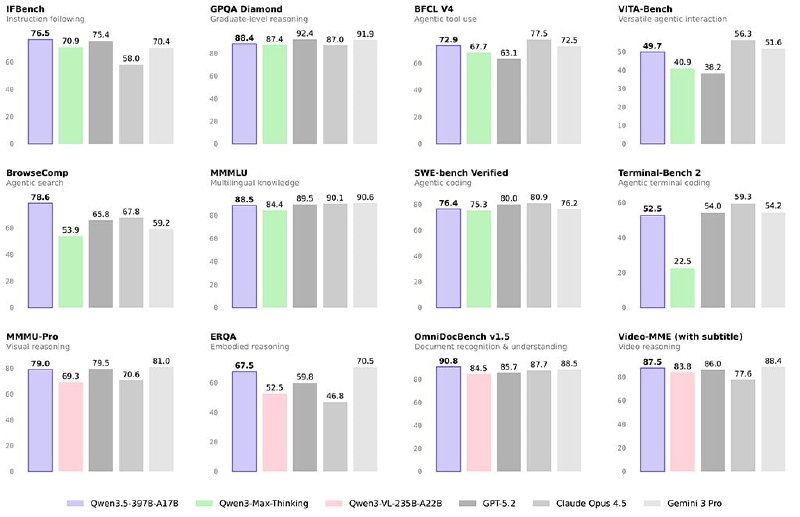
Вышел Qwen3.5-397B-A17B: первая модель с открытыми весами в серии Qwen3.5.

» Нативная мультимодальность. Обучена под реальных агентов.
» Гибрид: линейное attention + разреженный MoE, плюс масштабирование RL на больших средах.
» Декодинг быстрее в 8.6–19.0 раз по сравнению с Qwen3-Max.
» 201 язык и диалект.
» Лицензия Apache 2.0.

GitHub: https://github.com/QwenLM/Qwen3.5
Chat: https://chat.qwen.ai
API:https://modelstudio.console.alibabacloud.com/ap-southeast-1/?tab=doc#/doc/?type=model&url=2840914_2&modelId=group-qwen3.5-plus
Qwen Code: https://github.com/QwenLM/qwen-code
Hugging Face: https://huggingface.co/collections/Qwen/qwen35
ModelScope: https://modelscope.cn/collections/Qwen/Qwen35
blog: https://qwen.ai/blog?id=qwen3.5
  • 🔥 4
  • 😁 1
  • 🤯 1
Post #1158 856

Forwarded from эйай ньюз

Вышла GLM 5

У нас новая лучшая открытая модель, по крайней мере по бенчам. С проприетарными тягается неплохо, но с Opus 4.6 и GPT 5.3 Codex почему-то не сравнивают, хотя за неделю после релиза тесты можно было прогнать. Веса доступны по лицензии MIT.

Архитектура похожа на DeepSeek V3.2 — тоже используют DSA и multi-token prediction. Модель в 2 раза больше предыдущей модели компании — 744 миллиарда параметров (против 355), из которых 40B — активных. А вот датасет почти не вырос — 28.5 триллионов токенов, против 23 у GLM 4.5. Основной упор всё-таки идёт на RL, но про него-то как раз не говорят (надеюсь в техрепорте будет больше инфы).

Ложка дёгтя — модель использует заметно больше ресурсов чем основной конкурент, Kimi K2.5. У GLM 5 на 25% больше активных параметров и используется в 2+ раза больше памяти на веса из-за использования bf16, что делает модель ещё и медленнее. В результате модель на 30% дороже, судя по тестам Artificial Analysis.

Zhipu жалуются на отсутствие компьюта, похоже из-за этого GLM 5 работает на железе чуть ли не всех китайских производителей чипов для ИИ — Huawei Ascend, Moore Threads, Cambricon, Kunlun Chip, MetaX, Enflame и Hygon (я о половине даже не слышал). Из-за проблем с компьютом, доступ по подписке открыли пока только подписчикам уровня Max, но обещают докинуть остальным в ближайшее время.

Там ещё MiniMax M2.5 втихую дропнулся, но пока нет анонса и весов

Веса
Блогпост

@ai_newz
Post #1157 829

Forwarded from Все о блокчейн/мозге/space/WEB 3.0 в России и мире

Илья Полосухин создал 1-ого серьёзного конкурента OpenClaw, который может забрать значительную долю

Один из авторов статьи о трансформерах, Илья Полосухин, основатель NEAR AI, вместе с командой выпустили IronClaw - переписанная с 0 на Rust версия OpenClaw, с акцентом на приватность, безопасность и защиту от утечек данных.

За все время существования ИИ-агента OpenClaw (ex-Moltbot/Clawdbot) накопил огромное количество инцидентов по безопасности.

IronClaw решает эту проблему.

Skills из ClawHub пока не поддерживаются полноценно. Реальные тесты в проде покажут, выдержит ли.
GitHub GitHub - nearai/ironclaw: IronClaw is an Agent OS focused on privacy, security and extensibility IronClaw is an Agent OS focused on privacy, security and extensibility - nearai/ironclaw
  • ❤ 1
  • 😁 1
Post #1156 812

Forwarded from Инструменты программиста

WebMCP — Chrome даёт ИИ-агентам нормальный API вместо скриншотов

Google выпустила ранний превью WebMCP в новом Chrome. Сайты теперь могут описывать доступные действия как структурированные инструменты, которые ИИ-агенты вызывают напрямую — без парсинга DOM и распознавания пикселей.

🔘 Два API. Declarative — добавляешь атрибуты toolname и tooldescription к обычной HTML-форме, и она становится «агенто-доступной». Imperative — регистрируешь JS-функции через navigator.modelContext для сложных сценариев.

🔘 Агент вызывает buyTicket(destination, date) вместо «найди кнопку, кликни, подожди, сделай скриншот, распознай». Браузер сам заполняет форму и ждёт подтверждения пользователя.

🔘 Есть SubmitEvent.agentInvoked — сайт понимает, что сабмит пришёл от агента, и может вернуть структурированный ответ вместо HTML-страницы.

🔘 Спека — W3C Community Group Draft, разрабатывается совместно с Microsoft. Доступно за флагом в Chrome 146.

@prog_tools
  • ❤ 1
  • 🔥 1
Post #1155 1.52K
Claude Skill Building — ключевые инсайты для продакшна

1. Skill = контракт + оркестрация
• Фиксируем входы, выходы, формат, ограничения
• Модель — только слой принятия решений; вокруг нужны валидация, retry, fallback
2. Eval-first подход
• До релиза собираем набор тест-кейсов (happy path + edge cases)
• Любое изменение промпта/логики гоняем через авто-eval
• Без eval промпт-тюнинг превращается в “кажется стало лучше”
3. Контекст важнее “умности” модели
• Стабильная структура system/dev/user
• Минимизируем шум, даем только релевантный контекст
• Жёстко задаем формат ответа (JSON schema / строгий шаблон)
4. Tool use — production-фича
• Инструменты с чётким интерфейсом и предсказуемым результатом
• Таймауты, идемпотентность, обработка ошибок обязательны
• Логируем каждый вызов: что вызвали, что вернулось, почему упало
5. Надёжность > креативность
• Guardrails: policy checks, output filtering, PII redaction
• Fallback-стратегии на каждый критичный шаг
• Никаких silent failures — всегда понятный статус и next step
6. Стоимость и латентность — часть архитектуры
• Разделяем fast path и deep reasoning
• Кэшируем неизменный контекст
• Декомпозируем сложные задачи на этапы
7. UX для доверия
• Показываем прогресс: “думаю / проверяю / готово”
• Лучше короткий надёжный ответ сейчас, чем длинный нестабильный позже
Вывод: выигрывают не лучшие “магические промпты”, а системы с eval + observability + control loop.

Ссылка: https://resources.anthropic.com/hubfs/The-Complete-Guide-to-Building-Skill-for-Claude.pdf?hsLang=en
  • ❤ 3
  • 👍 2
  • 🔥 1
Post #1154 882

Forwarded from Вайб-кодинг

То, что надо: Codag позволяет визуализировать рабочие процессы AI/LLM прямо в репозитории и посмотреть, как именно работает ваш AI-код.

Без всякой настройки Codag строит карту всего AI-пайплайна: все вызовы LLM, ветвления решений и этапы обработки данных.

100% опенсорс код
  • 👍 6
  • 🤯 3
Post #1153 936

Forwarded from NeuroBuildersBot

🔥 Anthropic собрали C-компилятор командой из 16 Claude агентов


Масштаб проекта:

~2000 Claude Code сессий
$20,000 API costs
100,000 строк Rust кода
2B input токенов, 140M output
2 недели автономной работы
Результат: Компилятор собирает Linux 6.9 на x86, ARM, RISC-V + QEMU, FFmpeg, SQLite, Redis, Doom 🎮


Как работает harness:

while true; do
claude --dangerously-skip-permissions \
-p "$(cat AGENT_PROMPT.md)" \
--model claude-opus-4-6
done

Каждый агент в Docker-контейнере, общий git-репо, синхронизация через lock-файлы (current_tasks/parse_if.txt).


Ключевые уроки:

| Проблема                   | Решение                                           |
| -------------------------- | ------------------------------------------------- |
| Агенты делают одно и то же | Lock-файлы на задачи |
| Context pollution | Минимум вывода, всё в логи |
| Claude не чувствует время | --fast режим (1-10% тестов) |
| Все застряли на одном баге | GCC как oracle — каждый агент фиксит разные файлы |
| Код дублируется | Отдельный агент на рефакторинг |


Специализация агентов:

• 🐛 Основные — фиксят баги
• 🧹 Один — убирает дублирование
• ⚡ Один — оптимизирует перформанс
• 📝 Один — документация
• 🔍 Один — code review как "Rust эксперт"

Ограничения:

• Нет 16-bit x86 (звонит GCC)
• Ассемблер/линкер ещё багованы
• Код не супер-оптимальный
• Качество Rust "норм, но не эксперт"

Вывод автора:

"Я не ожидал что это будет возможно так рано в 2026. Это волнует, но и тревожит."


Код открыт: github.com/anthropics/claudes-c-compiler

Это буквально следующий уровень — от "AI помогает кодить" к "AI пишет компилятор пока ты спишь" 🤯
GitHub GitHub - anthropics/claudes-c-compiler: Claude Opus 4.6 wrote a dependency-free C compiler in Rust, with backends targeting x86… Claude Opus 4.6 wrote a dependency-free C compiler in Rust, with backends targeting x86 (64- and 32-bit), ARM, and RISC-V, capable of compiling a booting Linux kernel. - anthropics/claudes-c-compiler
  • 🤯 2
Post #1150 703

Forwarded from Вайб-кодинг

Сейчас AI-агенты всё лучше пишут код, но запускать их напрямую на локалке не всегда то и хочется

Особенно в режиме автозапуска, страшно, что AI случайно удалит важные файлы или вообще получит доступ к приватным данным.

Недавно на GitHub наткнулся на Vibe: опенсорс проект для macOS, который поднимает сверхбыструю Linux-виртуалку в песочнице.

Главные плюсы: нулевая конфигурация, изоляция за <10 секунд, можно спокойно закрыть AI в клетку.

AI видит только текущий проект, а все остальные чувствительные каталоги полностью изолированы.

Написан на Rust, использует родную виртуализацию Apple, безопаснее Docker и при этом почти не грузит ресурсы
GitHub GitHub - lynaghk/vibe: Easy Linux virtual machine on MacOS to sandbox LLM agents. Easy Linux virtual machine on MacOS to sandbox LLM agents. - lynaghk/vibe
  • ❤ 4
Post #1149 748

Forwarded from Life2film

Invoice CRM - файловая мини-CRM для инвойсов в PDF.

Сделал для себя и решил поделиться.

Главная фишка — всё управляется через Claude Code или любого другого AI-агента. Говоришь “сделай инвойс для Startup Inc на 5000 евро” — получаешь готовый PDF.

Что под капотом:
• База постоянных клиентов и провайдеров в YAML
• Реквизиты компаний и банков для переиспользования
• Шаблоны на Jinja2 - можно делать любые PDF-документы, хоть афиши
• QR-коды для оплаты (EUR/SEPA, TRY, USD/SWIFT, крипто)
• Цифровая подпись PDF
• Шифрование через age (хоть весь архив)

Всё через Make:
• make invoice-startup # инвойс пример
• make cards # карточки реквизитов
• make list # список клиентов

Стек: Python + Jinja2 + Pydantic + WeasyPrint

github.com/fortunto2/invoice-crm
  • 🔥 2
Post #1148 897

Forwarded from эйай ньюз

OpenAI запустили инструмент для написания пейперов

Prism построен на базе купленного OpenAI стартапа Crixet. Представляет он из себя совместный LaTeX редактор с интегрированным внутрь ChatGPT. Он может проверить цитаты, перевести диаграмму/формулу из наброска в LaTeX и т.д. Prism доступен бесплатно всем желающим, но подписчикам ChatGPT обещают как-то потом докинуть продвинутых фичей.

prism.openai.com

@ai_newz
  • ❤ 4
  • 🔥 1
Post #1147 879

Forwarded from эйай ньюз

Google начали раскатывать доступ к Genie 3

Пока что модель доступна лишь подписчикам Ultra. Юзеры могут создать набросок мира с помощью Nano Banana Pro, перед тем как туда залететь. Также есть библиотека готовых миров, которые можно ремиксить. Длина симуляции до 60 секунд, а видео можно потом скачать.

http://labs.google/projectgenie/

@ai_newz
  • 🔥 3
Post #1146 914

Forwarded from Вайб-кодинг

Опытные пользователи Claude Code, вам стоит это увидеть.

Есть публичный репозиторий, который по сути как полноценная ОС для Claude Code: агенты, skills, hooks, команды, правила, конфиги MCP, всё уже связали и можно просто подключать.

Можешь просто посмотреть (или забрать себе) целиком. Это мнение автора, которое уже обкатали на реальных проектах.
GitHub GitHub - affaan-m/ECC: The agent harness performance optimization system. Skills, instincts, memory, security, and research-first… The agent harness performance optimization system. Skills, instincts, memory, security, and research-first development for Claude Code, Codex, Opencode, Cursor and beyond. - affaan-m/ECC
  • 👍 3
  • 🤯 2
  • 🔥 1
Post #1145 784

Forwarded from Denis Sexy IT 🤖

Тут в деталях разобрали, что входит в 200$ подписку на Claude Code:
За 200$ вы покупаете $2708 аналога трат по API,
За 100$ – $1354
За 20$ – $163

При этом, все обращения в кеш диалога от клод кода стоят 0 денег – что делает эти подписки еще более секси; по API кэшированные запросы стоят 10% от стоимости на каждое чтение (кэширование запросов это когда у вас история чата с LLM не меняется и увеличивается от каждого хода, вот ее провайдеры API продают со скидкой – иначе дорого выходит)

В итоге, получается, что тарифный план за 100$ выгоднее API почти в 37 раз (!) – не понимаю как любой стартап может конкурировать с этим, строя своего кодинг агента ☕️

Тут все расчеты:
https://she-llac.com/claude-limits
she-llac suspiciously precise floats, or, how I got Claude's real limits I reverse-engineered Claude's hidden subscription usage caps from two unrounded utilization floats, recovered exact denominators via Stern-Brocot, and compared what Pro/Max actually buy you versus API pricing (including caching).
Post #1143 859

Forwarded from Вайб-кодинг

Исследователи собрали новый подход к RAG, который:

* не требует vector DB
* не делает эмбеддинги
* не режет документы на чанки
* не выполняет similarity search

И он показал 98,7% точности на финансовом бенчмарке (SOTA).

Вот какую ключевую проблему классического RAG этот подход решает:

Обычный RAG режет документы на чанки, превращает их в векторы и достает фрагменты по семантической похожести.

Но похожесть ≠ релевантность.

Когда ты спрашиваешь: "Какие были тренды по долгу в 2023?", векторный поиск вернет куски, которые семантически похожи на запрос.

А реальный ответ может быть спрятан где-нибудь в Appendix, упомянут ссылкой на другой странице, в разделе, который вообще не пересекается по смысловым словам с твоим вопросом.

Классический RAG, скорее всего, это просто не найдет.

PageIndex это закрывает.

Вместо чанкинга и эмбеддингов PageIndex строит иерархическое дерево структуры документа, по сути умную "таблицу содержания".

А дальше модель рассуждением проходит по этому дереву.

То есть она не спрашивает: "Какой текст больше всего похож на мой запрос?"

Она спрашивает: "Судя по структуре документа, где бы человек-эксперт искал ответ?"

Это принципиально другой подход, у которого:

* нет произвольного чанкинга, который рвет контекст
* не нужно тащить и обслуживать vector DB
* retrieval трассируемый: видно, почему выбрали конкретный раздел
* можно нормально ходить по внутренним ссылкам документа ("см. Table 5.3"), как делает человек

Но глубже проблема вот в чем.

Векторный поиск воспринимает каждый запрос как независимый.

А документы имеют структуру и логику: разделы ссылаются друг на друга, контекст накапливается по страницам.

PageIndex уважает эту структуру, вместо того чтобы сплющивать все в эмбеддинги.

При этом важно: такой подход не везде имеет смысл, потому что классический vector search все еще быстрый, простой и отлично работает во многих кейсах.

Но для проф-документов, где нужна доменная экспертиза и многошаговые рассуждения, tree-based, reasoning-first подход реально раскрывается.

Например, PageIndex показал 98,7% точности на FinanceBench и заметно обогнал традиционные vector-based RAG системы в разборе сложных финансовых документов.

Все полностью в oпенсорс, можно посмотреть реализацию на GitHub и попробовать самому.
  • 👍 6
  • 🤯 4
  • ❤ 2
Post #1142 774

Forwarded from Machinelearning

🌟 GLM-4.7 Flash: лайт-версия флагмана GLM-4.7.

В полку моделей, тех, что можно запустить локально, не продавая почку, прибыло.

ZAI выкатили GLM-4.7 Flash - облегченную версию GLM-4.7 на 30 млрд. параметров, с контекстным окном в 128К на архитектуре MoE.

Со слов создателей, модель должна занять нишу между сегментом SLM и проприетарными мастодонтами, предлагая SOTA-уровень в кодинге.

🟡MoE
Всего 30B, но активных параметров на токен гораздо меньше, официальной инфы нет, но в сообществе пишут, что 3 млрд.

🟡Interleaved Thinking
Киллер-фича для агентов, которая досталась в наследство от старшей GLM-4.7. Обычно модели выплевывают весь свой CoT в начале, а вот эта техника дает возможность модели думать перед каждым вызовом инструмента.

🟡Файнтюн на эстетику и DevOps
Опять-таки, со слов Zai, они натаскали GLM-4.7 Flash не просто писать валидный HTML/CSS, а использовать актуальные паттерны, нормальные отступы и цветовые схемы.

Плюс, подтянули работу с CLI и девопс-задачами (понимает права доступа, навигацию по файловой системе).

🟡Цифры тестов выглядят как конфетка.

В SWE-bench Verified модель выбивает 59.2%. Для сравнения: Qwen3-30B-A3B: 22.0%, GPT-OSS-20B: 34.0%.

В математическом AIME 25 тоже обходит конкурентов - 91.6%. А вот на BrowseComp она лучше GPT-OSS-20B почти в 1.5 раза.

Вобщем, Flash-версия выглядит как идеальный кандидат для локальных кодинг-агентов. Если есть пара свободных видеокарт (или есть стойкость терпеть квантование на одной), это, возможно, лучшая рабочая лошадка на сегодня.


📌Лицензирование: MIT License.


🟡Модель
🟡Квантованные варианты под все
🟡Demo1
🟡Demo2

@ai_machinelearning_big_data

#AI #ML #LLM #GLM #ZAI
  • ❤ 4
  • 👍 2
  • 🥰 2
Post #1141 763

Forwarded from О чем молчит AI CTO

image_2026-01-19_09-03-37.png444.3 KB
Агент == Бизнес-функция. Инженерный подход к проектированию

Рассмотрим проектирование агента поиска товаров в маркетплейсе по бенчмарку Store с ERC3. Попробуем подойти к проектированию агента с точки зрения структурного анализа.

Сначала посмотрим на схему #1 — из каких компонентов состоит Агент. Не буду их описывать, думаю вы и так понимаете, что они означают… НО что-то это напоминает… хм…

Да это вылитая схема IDEF0 (см. схему #2 для понимания) по описанию бизнес-функций! Слева вход — запрос пользователя или другого агента, сверху инструкции, правила поведения и навыки, снизу инструментарий для выполнения бизнес-функции, ну а справа выход.

Если смотрели выступление Ильи у Валеры, то вспомните: он применил схему оркестратора с саб-агентами для решения бенчмарка store, и один из таких агентов был агент по поиску товаров, использующий ручку API /products/list (см. схему #3).

Давайте теперь опишем данного саб-агента с помощью методологии IDEF0:

1. Определим бизнес-функцию нашего агента как «Подобрать товар» — анализ каталога товаров и выявление позиции, соответствующей запросу.

Мы выбираем «Подобрать», а не просто «Найти» или «Сканировать», потому что агент выполняет сложную когнитивную работу: он не просто делает запрос в базу (как поисковик), а итеративно сканирует каталог, фильтрует результаты в памяти и валидирует их на соответствие нечетким критериям пользователя.


2. На вход нашему агенту мы предоставляем «поисковый запрос с критериями фильтрации» — текстовая строка на естественном языке, содержащая как намерение («найди»), так и ограничения («дешевле 500», «красный»).

Пример: «Нужна игровая видеокарта не дороже 60000 рублей, желательно Asus».


На этом этапе можно размышлять над краевыми случаями и собрать Evaluation Dataset.

3. Для функции «Подобрать товар» механизм представляет собой tool, назовем ее get_product_list. В нашем случае это будет простая обертка вокруг API /products/list.

Мы осознанно не упоминаем в механизмах LLM, так как это больше НФТ (нефункциональное требование), нежели бизнес-требование.


4. В классическом менеджменте сверху находятся должностные инструкции, регламенты, ГОСТы и законы, но в нашем случае это будет Ролевая модель, Процедура поиска и Политики безопасности.

Важно: мы не отбираем у исследователей работу с промптом, но указываем в требованиях общие рекомендации.


5. Ну и Вывод — это продукт или информация, полученная в результате работы функции. Это то, ради чего функция существует. В классическом чат-боте выводом считается текстовое сообщение пользователю. В инженерии автономных агентов выводом является структурированный ответ, передающий ответственность оркестратору.

Рекомендую сразу размышлять над негативными сценариями: как мы будем обрабатывать ошибки.


Зачем это нужно?

Такая детализация позволяет еще до написания первой строки кода и промпта наглядно увидеть «дыры» в логике. Если вы не можете описать агента в этой схеме — значит, вы пока не знаете, что именно строите.

Хотите пример требований и кода по методологии? Поставьте реакцию, чтобы я знал, что вам это интересно 👇
  • 👍 5
Post #1140 629

Forwarded from DevOps

🤖 Лучшие GitHub-репозитории, чтобы выучить AI с нуля в 2026

Если хочешь разобраться в ИИ не по курсам “в вакууме”, а через реальные open-source проекты - вот топ реп, которые реально ведут от базы до практики:

1) Karpathy – Neural Networks: Zero to Hero
Самый понятный вход в нейросети и backprop “на пальцах”
https://github.com/karpathy/nn-zero-to-hero

2) Hugging Face Transformers
Главная библиотека современного NLP/LLM: модели, токенизаторы, fine-tuning
https://github.com/huggingface/transformers

3) FastAI – Fastbook
Практическое DL-обучение через проекты и эксперименты
https://github.com/fastai/fastbook

4) Made With ML
ML как инженерная система: пайплайны, прод, деплой, мониторинг
https://github.com/GokuMohandas/Made-With-ML

5) Machine Learning System Design (Chip Huyen)
Как строить ML-системы в реальном бизнесе: данные, метрики, инфраструктура
https://github.com/chiphuyen/machine-learning-systems-design

6) Awesome Generative AI Guide
Подборка материалов по GenAI: от основ до практики
https://github.com/aishwaryanr/awesome-generative-ai-guide

7) Dive into Deep Learning (D2L)
Одна из лучших книг по DL + код + задания
https://github.com/d2l-ai/d2l-en

Сохрани себе - это база, на которой можно реально вырасти до ML/LLM-инженера.

@DevOPSitsec
  • ❤ 3
  • 👍 2
  • 🔥 1
  • 🥰 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →