TGViewer
Channel Public Channel
Между инцидентами

Между инцидентами

@davydovpage

Меня зовут Иван. Это мой канал о системном администрировании, разработке и IT в целом.

- @i_davydoff
- https://davydov.page
- https://habr.com/ru/users/Davydoff33/

Канал в максе:
https://max.ru/join/ccIT52cWJG2Yss0Y8UHJocQj8PwIjvbIRC7yzGwP0Wk
Subscribers
81
Photos
41
Videos
2
Links
64
Recent Posts 20 shown
Post #98 150
WSL Manager: тула для управления wsl-инстансами

Нашёл полезный инструмент для тех, кто всё ещё основной системой на компьютере держит Windows (крайне понимаемо).

WSL Manager — это GUI для управления инстансами WSL, установленными на хосте. Под управлением подразумевается установка, удаление, обновление и бэкапы WSL'ек. Помимо этого вы можете ещё и docker-образы запускать в виде отдельных инстансов, что выглядит прям очень удобно.

https://github.com/bostrot/wsl2-distro-manager
  • 👍 2
  • 🔥 1
Post #97 125
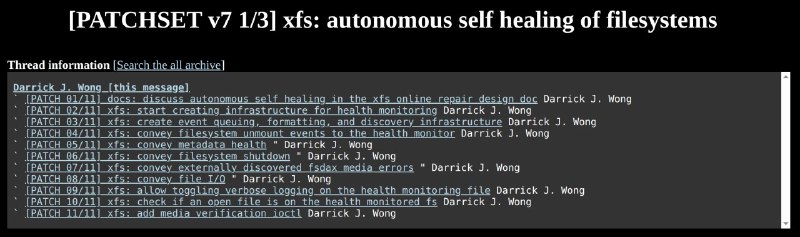
Селф-хилинг в XFS

Новая серия патчей в Linux для XFS добавила возможность мониторинга здоровья файловых систем.

События по типу read/write io ошибок, повреждения метаданных и так далее могут теперь быть «перехвачены» привилегированным процессом в пространстве пользователя.

А далее этот процесс в юзер-спейсе сам решит, что делать с полученной информацией :)
Post #96 128
Готовится новая фича дополнительных CPU планировщиков в Linux

Эта фича касается sched_ext планировщиков, это специальный отдельный класс шедулеров, которые представляют из себя eBPF программу и одновременно работают и в пространстве ядра, и в пространстве пользователя. Подробнее про них я писал у себя в блоге в прошлом году — https://davy.page/sched-ext.

В общем, sched_ext — это очень интересная штука, но у неё есть один заметный минус. Одновременно загруженным в ядро может быть только один такой кастомный планировщик. То есть если у вас на хосте запущено две программки, потоки которых по-хорошему нужно по-разному шедулить какими-нибудь самописными алгоритмами планирования, то придётся умещать эту логику в одном sched_ext шедулере, что может быть достаточно трудно (это учитывая, что писать планировщики и так тяжело по дефолту).

Чтобы побороть эту проблему, сейчас ведётся работа над патчсетом «sched_ext: Implement cgroup sub-scheduler support», который даст возможность одновременно держать загруженными в ядре несколько кастомных планировщиков.

И интересно, как автор предлагает, чтобы это выглядело. По его задумке в cgroup'е должно появится новое поле, в котором было бы прописано имя sched_ext планировщика, который бы и управлял CPU временем программ, привязанным к cgroup'е. А cgroup'ы же могут быть и вложенные. То есть, грубо говоря, может быть и такое, что в «родительской» cgroup прописан один планировщик, а в «дочерней» — другой. И как быть тогда? Во-первых, шедулер в родительской cgroup'е должен разрешить указывать другой шедулер в дочерней cgroup'е. И, во-вторых, у тебя родительский просто будет определять, сколько времени будет доставаться дочернему, исходя из какой-то своей логики.

А в случае если у тебя с планировщиком случается какое-то несчастье (например, задаче за отведённое время не назначается ядро (поток), которое будет её выполнять), то он переходит в "bypass mode" и начинает работать как обычный FIFO (First In First Out) шедулер.

Как-то так. Возможно, в будущем при установке какого-то специфичного софта нам в rpm/deb пакете будет идти ещё и кастомный планировщик для него :).
  • 🔥 3
Post #95 92
«Проблема» протокола NTP и что такое NTS

Кто ни разу не слышал про NTP, этот протокол описывает процесс синхронизации времени на хостах. Грубо говоря, у вас есть источник времени и есть одна машина или группа машин, на которых нужно установить время источника. Эта группа машин по протоколу NTP связывается с источником и устанавливает себе локально то время, которое он им передаст.

NTP — это базовая и простая технология, от корректной работы которой много чего зависит. Потому что если на вашем сервере установлено неправильное время, скорее всего, со многими функциями, которые должен выполнять ваш хост, появятся проблемы. Банально TLS-соединения перестанут устанавливаться, потому что у TLS-сертификатов есть даты начала и конца действия, а если ты владеешь неправильным временем, то и сертификаты, которые ты будешь создавать, будут недействительны.

Ну и вообще, о чем пост. Недавно на FOSDEM 2026 выступил сотрудник фонда Trifecta Tech Рубен Найвелд с докладом «Делаем время безопаснее с NTS». В нём он рассказал про три вещи: проблему NTP, что такое NTS, и про проблему уже NTS в виде реализации NTS-пулов. Давайте вкратце про все три пункта.

Первое — «проблема» NTP. Она заключается в том, что NTP передаёт данные по интернету в незашифрованном виде, и что их в целом легко перехватить и подменить. Цитата Рубена про NTP звучит так: «fundamentally a broken protocol. It is a protocol that is fundamentally insecure». На этом этапе в интернетах сразу подметили, что раз это так страшно и плохо, то почему за столько времени это не исправили? Может, это не так уж и страшно? Потому что на самом деле, когда вы обслуживаете какую-то сложную систему, то на её хостах скорее всег остоит что-то типа chronyd, который умеет брать время сразу из нескольких источников. Поэтому если у вас один из них начнёт отдавать какую-то дичь, стать для вашей системы проблемой это не должно.

Второе — что такое NTS. NTS — это протокол, который в стандартный процесс получения времени через NTP добавляет ещё и обмен ключами. При этом само время передаётся по сети всё так же в незашифрованном виде, но теперь к пакетам добавляются хедеры, которые позволяют убедиться в том, что время вам прислал именно тот источник, который вы указали, и трафик не был перехвачен и подменён по пути. Стандарт был опубликован в 2020 году, и на данный момент его поддерживают NTPSec, Chrony и ntpd-rs.

Третье — проблема с пулами NTS. В NTP что удобно, это то, что ты можешь указать (например, в chronyd), что брать время тебя нужно из pool.ntp.org, который выдаёт тебе N серверов из твоего региона. И ты, соответственно, дальше уже с этими серверами общаешься. В NTS с этим есть проблемы. В пуле ntp.org сейчас +- 5 тысяч серверов. Если организовывать такой же пул с NTS-серверами, то на каждом из 5к серверов должен лежать единый сертификат для pool.ntp.org. А если у вас на таком количестве неконтролируемых вами серверов лежит общий сертификат, то приватный ключ этого сертификата, скорее всего, утечёт, и смысла от NTS не будет. А выписывать отдельные сертификаты для каждого сервера нет варианта, потому что они все живут под одним доменом. Команда Рубена сейчас работает с двумя вариантами реализации пулов, оба они, на мой взгляд, такие себе, и расписывать я их тут не буду, так как уже много букв, если вам интересно, то Рубен рассказывает про них в конце своего доклада.

Выглядит вся эта история прикольно, но, конечно, попахивает «решением, ищущим проблему»). За сотрудников фонда Trifecta можно только порадоваться, что им дают деньги всякими такими приколами заниматься.
  • 😁 3
Post #94 80
Из разряда «современные проблемы требуют современных решений»

Команда GNOME столкнулась со значительными «data-transfering costs». То есть чисто за трафик своих ресурсов они начали платить уже столько, что пришло время задуматься. Ну или просто бюджет сдулся, всё может быть.

В общем, в качестве одной из мер борьбы с толстыми чеками теперь при клонировании репозиториев с их гитлаба вас будет редиректить на зеркало репозитория в гитхабе (см. скриншот). Smart move 😎
  • 🤔 2
  • 💯 2
Post #93 96
Забавная старая задачка с собеседований

Что будешь делать если случайно выполнишь "chmod 444 /bin/chmod"? Как откатывать обратно?

Есть способ, вспомнить который будет, наверное, проще всего. Вам тут по сути нужен любой исполняемый файл, который сможет выполнить syscall chmod(2). Например, таким файлом может быть питон:

python3 - <<'EOF'
import os
os.chmod("/bin/chmod", 0o755)
EOF
Post #92 104
RFC 406i: Борьба с AI Slop’ом в опенсурсе

В связи с наплывом сгенерированных ИИшкой мердж-реквестов в опенсурс-проектах родилась занятная RFC. Её предполагается отправлять авторам таких мердж-реквестов в качестве объяснения отказа.

Вольный перевод части RFC:

Как перестать нарушать RFC?

- Выполни rm -rf по всему, что сгенерировала твоя ИИ

- Выполни хард ребут своего мозга

- Прочитай кодовую базу и документацию проекта

- Не возвращайся, пока не обретешь способность к осознанному восприятию окружающего мира и не будешь готов печатать код своими собственными пальцами


https://406.fail/
  • 😁 1
  • 💯 1
Post #91 109
  • 😁 4
Post #90 122
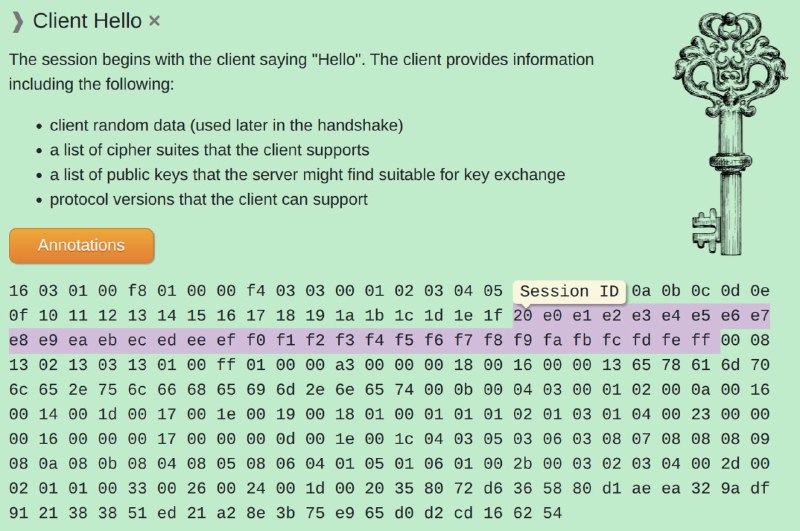
Работа TLS 1.3

Нашел интересный сайт, который в формате иллюстраций объясняет, как выглядит начало сессии в TLS 1.3. Прям наглядно показывается, что на каком этапе происходит и кто кому что пересылает. Вплоть до значения каждого байта в пересылаемых пакетах. Очень интересно.

Я лично не знал раньше, что в TLS 1.3 шифрование включается УЖЕ на этапе хендшейка и далее в конце него ключи шифрования меняются. То есть есть ключи для частичного шифрования хендшейка, и есть уже другие ключи для шифрования трафика приложения. Ну и то, что у TLS 1.3 для совместимости с некоторыми устройствами есть режим маскировки под TLS 1.2, в котором часть пакетов маскируется под пакеты версии 1.2 — это тоже прикольно.

В общем, всем советую -> https://tls13.xargs.org
  • ❤ 4
  • 👍 2
Post #89 126
🟢Retry

Время в секундах, говорящее вторичным серверам, через какое время нужно повторять запрос в мастер, если он не ответил на запрос SOA-запись.

🟢Expire

Время в секундах, говорящее вторичным серверам, сколько им продолжать отвечать на запросы по зоне, в случае если мастер перестал отвечать.

🟢Negative response caching TTL

Время в секундах для ответов с ошибками. Например, если было запрошено имя, которого не существует.

___

Ну вот как-то так ☺️
  • 👍 6
Post #88 116
Что такое SOA-запись в DNS и для чего она нужна

Обычно, если вам нужно проверить состояние DNS-записи, то это, скорее всего, будет какая-нибудь A, CNAME, TXT или NS запись. Очень редко когда нужно смотреть, что там с SOA, да и в целом большинство людей, которые не погружались в детали работы DNS, вероятно, даже никогда и не слышали об этом типе записей.

SOA-запись — это обязательная запись для вашей зоны, без неё зона не может работать и считается некорректной. А что есть зона? Зона — это домен. Например, купили вы себе домен второго уровня big.bob, вот ваша зона — big.bob. Допустим, инфраструктура сервиса, который стоит за доменом big.bob, разрастается до такой степени, что какая-то часть её становится самостоятельной и хочет сама рулить своими DNS-записями без согласования с главными админами, которые управляют основной зоной big.bob. Допустим, эта часть инфраструктуры живёт под доменом small.big.bob. Чтобы реализовать их требования по независимости, мы делегируем small.big.bob на их DNS-сервера через NS-записи, в которых указываем адреса этих серверов. Далее они на своих DNS-серверах создают зону small.big.bob, которая всегда начинается с SOA-записи. Теперь эти сервера полностью отвественны за зону small.big.bob. В общем, зона — это управляемая часть доменного имени.

Вернёмся к нашим SOA-записям. Понятно, что зона без SOA-записи не существует, но что входит в эту SOA-запись?

Вот так, к примеру, в синтаксисе BIND выглядит SOA-запись:

$TTL 86400
@ IN SOA <master-dns> <admin-email> (
2020080302 ;Serial
7200 ;Refresh
3600 ;Retry
1209600 ;Expire
3600 ;Negative response caching TTL
)


Давайте теперь по порядку, что тут что значит.

FYI
Далее по тексту будут использоваться термины «мастер-днс» и «вторичный сервер». Мастер это авторитетный сервер, который управляет зоной, вносит в неё изменения, отвечает на запросы по записям в зоне. Вторичный же сервер только отвечает на запросы по записям. Грубо говоря это dns-сервер с ReadOnly доступом к зоне. Он регулярно общается с мастером и клонирует актуальную информацию о зоне себе.


🟢master-dns

DNS-имя основного DNS-сервера зоны. В теории на этот сервер должны идти запросы на обновление записей зоны (например, утилитой nsupdate), и только от этого сервера должны лететь уведомления вторичным DNS-серверам о том, что в зоне произошли обновления.

На практике же, если мы говорим, например, о зонах в диком интернете, в master-dns может быть прописан вообще даже не существующий домен. Такие зоны либо обновляются администратором путём прямых изменений на DNS-сервере, либо какой-то внутренней автоматизацией владельца зоны, либо зона, которую мы видим в интернете, это реплика зоны, которая живёт в серой сети администратора, но имеет другую SOA-запись с master-dns, который ведёт на реальный сервер во внутренней сети, и, соответственно, во внутренней сети своего хозяина эта зона нормально обновляется тем же nsupdate, а все изменения попадают на реплику, которая "проецируется" в интернет.

🟢admin-email

По названию в целом понятно, что это такое — мыло администратора зоны. Может быть реальным, может быть выдуманным, зависит от админа. Единственный нюанс — это то, что символ "@" должен быть заменён точкой.

🟢Serial

Серийный номер зоны. Меняется, когда необходимо сказать вторичным серверам: "зона обновилась - стягивайте изменения себе!".

Представляет из себя просто набор цифр, но чаще всего эти цифры выставлены в виде какой-то конкретной даты последнего обновления. К примеру возьмём такой Serial - 2020080302. Тут первые 8 цифр это дата обновления, а последние 2 это дополнительные цифры, которые указывают на количество обновлений зоны в этот день.

Если вашей зоной управляет один сервер и у вас нет вторичных серверов, то изменение серийного номера зоны при каждом её обновлении становится бессмысленным.

🟢Refresh

Время в секундах, говорящее вторичным серверам, как часто нужно ходить к мастер-серверу и стягивать информацию о зоне.

продолжение следует...
  • 👍 7
Post #86 115
Дело о HAProxy и Nginx

Представьте, что у вас есть следующая конфигурация: «Nginx -> HAProxy -> Backend». И вы в какой-то момент сталкиваетесь с ситуацией, когда GET HTTP-запрос напрямую в backend или через HAProxy проходит без ошибок, а если в цепочку добавляется Nginx — клиент получает 413 Payload Too Large. Вот мы когда-то столкнулись с подобным.

Казалось бы, ну «payload too large» — значит запрос упёрся в лимит nginx'а на размер пейлоада, и нужно просто подкрутить директивы. Но нет, 413 — это ответ от HAProxy, а не от Nginx (nginx его просто передал). Да и в принципе запросы там были маленькие, они никак не могли упираться ни в какие лимиты Nginx. Тут можно было бы ещё сказать, что какой вообще пейлоад, если мы про GET-запрос говорим? Но, к сожалению, бывает и такое 😊.

В общем, что мы имеем: HAProxy отдаёт 413 на GET-запрос с пейлоадом, если этот запрос был спроксирован через Nginx, если идти напрямую в HAProxy, то всё проходит без проблем. Идём читать доку. И в доке мы видим следующее: "413 when a HTTP/1.0 GET/HEAD/DELETE requests has a payload". То есть HAProxy сама отдаёт 413 только в случае, если в GET/HEAD/DELETE HTTP/1.0 запросе был передан какой-то пейлоад.

В целом понятно, в чём дело, но почему тогда проблема появляется только если ходить в haproxy через nginx? На самом деле это тоже становится понятным после прочтения того отрывка из документации, что я привёл выше. HAProxy отдаёт 413 только на запросы с версией HTTP 1.0. А эта версия является дефолтной для proxy_pass в nginx, поэтому если явно не указывать директиву proxy_http_version в nginx'е, то он с апстримом будет устанавливать HTTP соединение версии 1.0. А если ходить напрямую в HAProxy или бэк, то у нас устанавливалась версия HTTP/1.1, на которой, соответственно, HAProxy 413 не отдаёт.

Поэтому устанавливая в таком случае директиву "proxy_http_version 1.1", ситуация полностью решалась.
  • 👍 6
Post #85 120
Что такое git patch и как выстрелить им себе в ногу

Вероятно, если вы ни разу не сталкивались с процессом применения изменений в опенсурс-разработке, то вы и никогда не сталкивались и с git patch. Собственно, что такое этот git patch? Вкратце, это специальный формат текстового файла, который отображает изменения в коде между двумя коммитами. Например, изменения, внесённые разрабом относительно ветки master. Зачем это нужно, когда есть git merge, пул реквесты и т. д.? Ну... Не знаю, насколько это хорошая практика, но много опенсурсных проектов (в частности, Linux) принимают от контрибьюторов изменения по почте 😊. В некоторых случаях это из-за их олдовости, а в других, я полагаю, это единственный доступный способ для владельцев репозитория работать с контрибьюторами. Но так или иначе, git patch'и идеально подходят для того, чтобы их отправлять по мылу. Выглядят они как-то так.

Теперь к нашей истории. Как видно из примера патча сверху, в него входит также и описание патча. И недавно произошёл один забавный случай, связанный как раз с этим описанием. Некий Орестис Флорос завёл в гитхабе пулреквест для i3 (оконный менеджер). Меинтейнер принял его и в виде гит патча забрал себе для того, чтобы вставить в другой репозиторий и сформировать debian пакет приложения. После того, как он применил патч, он заметил, что некоторые операции в приложении теперь занимают на несколько секунд дольше.

Дебаг показал, что помимо валидных изменений, которые и должны были примениться после патча, были применены также изменения, которые были в описании патча. А в описании было что-то типа: «Эти изменения я протестил так» и git diff изменений, которые автор вносил для тестирования своих правок, и в которых как раз был sleep(1), из-за которого в некоторых местах и появлялись непонятные паузы.

То есть ещё раз. Были применены изменения, которых не было в коммитах пулреквеста (!), но которые были в его описании и имели формат git diff. Дело в том, что в патче любой текст формата git diff будет рассматриваться как валидные изменения и будет применён. И не важно, в какой последовательности будут идти дифы и обычный текст, который будет принят за обычные комментарии.
  • 🤔 3
Post #84 124
Как LinkedIn детектит ботов и абузеров

Для LinkedIn'а большой проблемой являются боты, которые скачивают резюме/вакансии, и пользователи, которые с помощью всяких client-side автоматизаций слишком сильно себе облегчают жизнь (лучше, чтобы они линкедын премиум купили 😄).

Среди этих ботов и пользаков есть, конечно, такие, чей софт вообще никак не задетектить, но всё-таки абсолютное большинство пользуется не такими умными программками, и не умеет скрывать факт их использования. К этой категории у нас относятся, например, большинство пользователей браузерных расширений со словом «LinkedIn» в названии.

Один энтузиаст обнаружил, что как раз использование таких расширений LinkedIn детектит при каждом заходе на страницу. Детект происходит за счёт попытки запросить у расширения файл, который оно сделало доступным для сайтов (если такой файл есть, значит расширение установлено). Соответственно LinkedIn берёт список расширений, которые ему не нравятся, берёт файлы, которые каждое из расширений делает публичными, и просто проходится пробами по этому списку. А в этом списке на минуточку почти 2 тыщи расширений (уже я думаю больше), наличие которых сайт проверяет и отправляет своему бэкенду.

P.S. В списке, кстати, не только тулы для автоматизации чего-либо конкретно в линкедыне. Там ещё, например, и просто куча всяких AI расширений. Это уже, видимо, делается для анализа того, кто что использует.
  • 👍 3
Post #83 134
В OCI-реестрах можно хранить вообще всё

Основное их назначение — это хранение контейнерных образов. Но в какой-то момент люди подумали, что им этого недостаточно, и что они хотят вместе с образами хранить и другие артефакты.

Например, как-то рядом, связно с образом, хотелось бы хранить и его SBOM (Software Bill of Materials) и подписи. Помимо этого есть ещё всякие Helm-чарты, которые также неплохо было бы поместить где-то по соседству.

Так появился ORAS — инструмент-воркэраунд, который позволяет хранить в OCI-реестрах не только образы, но и другие артефакты. Список приложений, которые поддерживают ORAS, можно посмотреть тут. Среди них, например, есть вышеупомянутый Helm, Inspektor Gadget (коллекция дебаг-тулов для куба) и OpenTofu (форк терраформа).

Но на воркэраунде никому долго жить не хочется, поэтому в спецификации OCI 1.1, вышедшей в ещё 2024 году, добавили две важные штуки. Первое — поле artifactType, в котором нативно можно указать тип артефакта, без «костылинга». Второе — добавили возможность связывать артифакты друг с другом, то есть у вас теперь тот же Helm-чарт может быть связан с образом, и, конечно же, все связанные с образом артифакты можно запросить по API.

До сих пор не все тулы и реестры поддерживают OCI 1.1, но однажды...

Под конец приведу частичный список того, что уже может храниться в OCI, и что не является образом.

🟢WASM Модули
🟢Docker Compose YAML
🟢Helm чарты
🟢Gatekeeper политики
🟢Желаемый стейт приложения в Flux
🟢Homebrew bottles
🟢Подписи, SBOM и тд (через Cosign, Notation и другие тулы)
  • 👍 3
Post #82 115
Телегу сегодня официально начали душить. И по невероятному совпадению сегодня же в максе стало доступно создание каналов для простых смертных.

Видимо время пришло. Для тех, кому интересно читать, что я тут публикую, и у кого (почему-то) всё еще не настроен ВПН, я создал канал в этом великолепном мессенджере 😬

Канал в телеграме продолжит жить, но те же самые посты будут дублироваться в макс.

https://max.ru/join/ccIT52cWJG2Yss0Y8UHJocQj8PwIjvbIRC7yzGwP0Wk
MAX MAX – быстрое и легкое приложение для общения и решения повседневных задач MAX позволяет отправлять любые виды сообщений и звонить даже на слабых устройствах и при низкой скорости интернета.
  • 🤬 5
  • 😢 3
Post #81 126
Меинтейнер SUDO ищет финансирования

В течение последних 30 с лишним лет я занимался сопровождением sudo. В настоящее время я нахожусь в поиске спонсора для финансирования дальнейшего обслуживания и развития sudo. Если вы или ваша организация заинтересованы в спонсировании sudo, пожалуйста, дайте мне знать.


Написал Тодд Миллер на домашней странице своего блога.

С 2010 по 2024 год главным спонсором sudo выступал работодатель Тодда — компания Quest Software. Спонсорство прекратилось, вероятно, в связи с уходом Тодда из дочерней компании Quest'а в 2024 году.

Сколько ещё на столько важного опенсурс софта поддерживается сейчас одним единственным разработчиком за бесплатно? Вопрос для размышления.

Касательно sudo, у нас уже есть замена в виде sudo-rs. По сути, тот же самый sudo, но переписанный на Rust и поддерживающийся фондом Trifecta Tech. Контрибьюторов в фонде достаточно, деньги (вроде как) имеются, да и сам Тодд в разговоре с The Register сказал, что поддерживает связь с разработчиками sudo-rs и верит, что они идут в верном направлении.
Post #80 184
Публичные VPN-сервисы врут о своих локациях

Вы не факт, что пользовались, но наверняка много раз видели VPN-сервисы (хотя бы их рекламу), у которых и в США, и в Великобритании, и в Бразилии, и в Нидерландах, и в Швейцарии, и ещё в куче других стран есть свои сети. Как они поддерживают такую большую инфру в таком количестве стран? Удивительно!

На самом деле подход у большинства из них существенно проще. Ребята из ipinfo выяснили, что многие публичные VPNы, заявляющие о наличии сетей в 100+ странах, на самом деле физически держат оборудование большинства из них в одном или нескольких дата-центрах США или Европы 😊. Как такое может быть? Они просто врут ARIN, RIPE и провайдерам геоданных, предоставляя тем ложную информацию о расположении их IP-адресов.

Вскрывается это путём сравнения RTT (Round-Trip Time) из разных локаций до IP-адреса VPN. Для примера: если у VPN'а заявленная локация — это Сомали, а RTT от Лондона до неё 0.32ms, то, скорее всего, где-то в Европе этот VPN в реальности и находится.

https://ipinfo.io/blog/vpn-location-mismatch-report
  • 💯 3
Post #79 146
Увидел в интернетах вот такой комментарий под очередным ИИ-инструментом.

Все эти инструменты нужны для того, чтобы что-то создавать, но создавать нечего. У меня такое чувство, что я участвую в финансовой пирамиде, где каждый продукт предназначен для создания какого-то другого, но до конечного пользователя так ничего и не доходит.


Не в бровь, а в глаз.
  • 👍 4
Post #78 162
Chrome и HTTP/2

Наткнулись на интересную «особенность» хрома при работе с HTTP/2 соединениями.

В общем, какая у нас база: если вы откроете сайт, который использует HTTP/2, и в другой вкладке ещё раз откроете этот же сайтик, то на обе вкладки у вас будет шариться одно TCP соединение. В целом прикольно, но, зная, как работает HTTP/2, вау не случается.

Но!

Представим, что у вас есть сайты «a.ru», работает на HTTP/2, и «b.ru», работает на HTTP/1.1. Два отдельных сайта со своей логикой, своей тематикой, клиентами и т.д. Но на одном IP-адресе. Если вы в одной вкладке сначала откроете «a.ru», а потом в другой попытаетесь открыть «b.ru», то поймаете ошибку (скорее всего, 404).

Почему? Да потому что хром уже открыл HTTP/2 сессию с «a.ru», у которого IP-адрес такой же, как и у «b.ru». Соответственно, он не считает нужным открывать новую сессию, потому что «ну IP-адрес-то один и тот же», и все запросы, которые должны были идти в «b.ru», идут в сессию «a.ru» 😊.

При этом если «не дёргать» какое-то время вкладку c «a.ru», то сессия протухает и появляется возможность нормально пользоваться сайтом «b.ru».

Такое поведение воспроизводится в браузерах на базе хрома — если попробовать проверить это же, например, в Safari, то всё будет окей.
  • 🤯 5
  • 👍 1
Older posts →

About this channel

How can I read @davydovpage without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Между инцидентами: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Между инцидентами have?
Между инцидентами (@davydovpage) has 81 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Между инцидентами know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →