TGViewer
Channel Public Channel
دیتایاد | هوش مصنوعی و علم داده

دیتایاد | هوش مصنوعی و علم داده

@datayad

دوره های جامع پایتون، علم داده و یادگیری ماشین و دیگر دوره های مرتبط با این حوزه
(با بالا ترین سطح رضایت دانشجویان دوره)

سایت دیتایاد:
https://datayad.com

پشتیبانی دیتایاد در بله:
https://ble.ir/@datayad_support
Subscribers
5.61K
Photos
408
Videos
105
Links
962

Showing posts older than #821 · Back to latest

Older Posts 20 shown
Post #820 896
🎙️ تقلید صدا با هوش مصنوعی چطوری کار می‌کنه؟

حتماً دیدی که AI صداها رو طوری تقلید می‌کنه که حتی خانواده‌ت هم اشتباه می‌گیرن 😅
اما واقعاً این اتفاق چطور می‌افته؟
بیاین پشت صحنه‌ی مدل‌های Voice Cloning رو ببینیم 🧠

🔊 مرحله اول: استخراج ویژگی‌های صوتی
هوش مصنوعی اول صدای فرد رو تجزیه می‌کنه تا ویژگی‌هایی مثل زیر و بمی (Pitch)، لحن (Tone) و ریتم گفتار رو بفهمه.
این داده‌ها معمولاً به‌صورت Spectrogram ذخیره می‌شن، یه تصویر دوبعدی از شدت و فرکانس صدا در طول زمان.

🧩 مرحله دوم: مدل‌سازی صدا
بعد، یه مدل عصبی (معمولاً Encoder-Decoder یا VAE) یاد می‌گیره که چطور اون ویژگی‌ها رو به یه نمایه عددی (Voice Embedding) تبدیل کنه.
این عددها در واقع “DNA صوتی” اون فردن!
با چند ثانیه نمونه صدا، مدل می‌تونه این امضا رو بسازه.

🗣️ مرحله سوم: تولید صدا جدید
در نهایت، مدل با ترکیب متن ورودی (Text) و Voice Embedding، یه صدای جدید می‌سازه.
اینجا از Text-to-Speech (TTS) استفاده می‌شه، همون فناوری‌ای که تو ChatGPT Voice یا ElevenLabs هست.

🎯 نتیجه؟
مدل نه فقط کلمات رو می‌گه، بلکه حس، مکث و حتی لهجه رو هم تقلید می‌کنه.
ترکیب پردازش صوت + یادگیری عمیق = صدایی که کاملا انسانی به نظر میاد.
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 🤯 6
Post #819 996
🧠 تبدیل ریپازیتوری به داکیومنت هوشمند در یک ثانیه!

فقط کافیه توی آدرس اون ریپازیتوری، کلمه‌ی github رو با deepwiki عوض کنی ✅
نتیجه؟ یه مستندات مرتب، قابل جستجو و زیبا از همون ریپو! 🚀

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 🔥 8
Post #818 873
🧠 داده‌های پنهان در مدل‌های زبانی؛ وقتی AI چیزهایی رو که نباید یاد می‌گیره!

مدل‌های زبانی مثل GPT یا Gemini با میلیاردها جمله آموزش دیدن. اما یه نکته‌ی مهم این وسط هست:
اونا فقط «یاد نمی‌گیرن»، بلکه چیزهایی رو هم به خاطر می‌سپارن! 😳
گاهی اطلاعات حساس یا الگوهای ناخواسته‌ای از داده‌های آموزشی توی حافظه‌شون باقی می‌مونه، حتی اگه اون داده‌ها حذف شده باشن.

⚙️ چطور این اتفاق می‌افته؟
وقتی یه مدل با حجم عظیمی از متن آموزش می‌بینه، ناخودآگاه بعضی از اطلاعات خاص مثل ایمیل‌ها، اسم‌ها یا داده‌های شخصی رو در وزن‌هاش رمزگذاری (encode) می‌کنه.
این داده‌ها قابل مشاهده مستقیم نیستن، اما گاهی با پرامپت‌های خاص یا حملات مهندسی معکوس، بازسازی می‌شن.
به همین خاطر شرکت‌ها الان دارن دنبال روش‌هایی مثل Differential Privacy و Selective Forgetting می‌رن تا مدل یاد بگره چی نباید یاد بگیره! 😅

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • ❤ 4
  • 🔥 2
Post #817 845
🤖 قدرت جدید Siri با کمک Google!

اپل بالاخره یه تصمیم بزرگ گرفت!
طبق گزارش‌ها، این شرکت داره نزدیک میشه به یه قرارداد ۱ میلیارد دلاری در سال با گوگل تا از مدل هوش مصنوعی Gemini برای نسخه جدید Siri استفاده کنه.
یعنی چی؟ یعنی Siri قراره با مغز گوگل کار کنه! 😅
🧠 اپل با این کار می‌خواد عقب‌افتادگی خودش از رقبا مثل ChatGPT و Gemini رو جبران کنه و تجربه‌ای خیلی طبیعی‌تر و هوشمندتر از Siri بسازه.

⚙️ پشت‌پرده فنی
مدلی که گوگل در اختیار اپل می‌ذاره، یه نسخه سفارشی‌شده از Gemini با حدود ۱.۲ تریلیون پارامتره، یعنی تقریباً ۸ برابر بزرگ‌تر از مدل داخلی اپل!
این تصمیم نشون می‌ده اپل بالاخره به‌طور ضمنی قبول کرده که در رقابت AI از بقیه عقب مونده و فعلاً باید از قدرت گوگل کمک بگیره.
البته برای حفظ حریم خصوصی، همه‌ی پردازش‌ها روی سرورهای اختصاصی اپل انجام میشه تا داده‌های کاربر همچنان داخل اکوسیستم خودش بمونه.

🔗 منبع TechCrunch
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 🔥 4
Post #816 844
🤖 چرا مدل‌های هوش مصنوعی گاهی «توهم» می‌زنن؟

تا حالا دیدی ChatGPT با اعتمادبه‌نفس کامل یه جواب اشتباه می‌ده؟ 😅
این رفتار اسمش Hallucination یا «توهم مدل» هست، یعنی مدل چیزایی می‌گه که واقعی نیستن ولی خودش خیلی بهشون ایمان داره 🧠🔥
بیایید ببینیم چرا این اتفاق میفته 👇

🧩 مدل نمی‌فهمه، پیش‌بینی می‌کنه
مدل مثل انسان معنی رو درک نمی‌کنه.
کارش فقط پیش‌بینی بهترین کلمه بعدی بر اساس میلیاردها نمونه‌ست.

یعنی چی؟ یعنی:
حقیقت ≠ همیشه محتمل‌ترین جواب

پس گاهی مدل، پاسخ محتمل ولی نادرست می‌سازه.

اگه مدل یه موضوع خاص رو کم دیده باشه (یا بد دیده باشه)،
مجبوره حدس بزنه، و همون‌جا توهم شروع میشه 😬

مثلاً:

سوال درباره قوانین مالیاتی یک کشور کوچک؟ احتمال توهم بالا

سوال درباره فیزیک دبیرستان؟
داده زیاد = توهم کمتر
🛠️ راه‌حل‌ها: چطور جلوی توهم AI رو بگیریم؟
چند تکنیک مهم تو دنیای AI:

RAG ✅ داده‌برداری از منابع واقعی قبل از پاسخ

Fine-tuning ✅ آموزش مدل روی داده واقعی کسب‌وکار

Feedback Loop ✅ اصلاح جواب‌ها و یادگیری با گذر زمان

این روش‌ها باعث میشن AI کمتر حدس بزنه و بیشتر بدونه 📚⚙️
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 👍 4
  • ❤ 2
Post #815 813
🤖 اولین چت‌بات جهان: وقتی ELIZA همه رو شوکه کرد!

امروز همه با ChatGPT و بقیه چت‌بات ها حرف می‌زنیم…
ولی داستان از سال ۱۹۶۶ شروع شد، وقتی یه برنامه ساده به اسم ELIZA باعث شد مردم فکر کنن کامپیوتر «می‌فهمه» 😮🧠

این اولین لحظه‌ای بود که انسان‌ها حس کردن ممکنه ماشینی بتونه مکالمه کنه.

💬 ظهور ELIZA تو سال ۱۹۶۶
خالق: جوزف ویزنبام، MIT
ایده: شبیه‌سازی یک روان‌درمانگر

چت‌بات ELIZA جملات آدم‌ها رو می‌گرفت و با الگوهای ساده جواب می‌داد:

کاربر: من احساس تنهایی می‌کنم
چت‌بات ELIZA: چرا فکر می‌کنی تنهایی؟

هیچ مدل زبانی، هیچ ریاضیات سنگین، هیچ شبکه عصبی ای دخیل نبود.
فقط جای‌گذاری کلمات و قواعد ساده… اما نتیجه؟
آدم‌ها فکر می‌کردن باهاش درد دل می‌کنن 😅
🔥 چرا مهم بود؟
✅ اولین نقطه تماس بشر با مکالمه هوشمند
✅ پایه‌ساز NLP و چت‌بات‌ها
✅ فهمیدیم انسان‌ها می‌تونن به ماشین‌ها همدلانه پاسخ بدن (اثر ELIZA)
✅ الهام‌بخش مسیر مدل‌های زبانی امروز

وقتی یه سیستم ساده تونست این‌قدر اثر بگذاره،
دنیا فهمید «هوش مصنوعی فقط عدد و الگوریتم نیست؛ تعامل با انسانه.»
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 👏 3
Post #814 2.88K
💣 جامع ترین دوره LLM و NLP در ایران 💣

💎 از «مبانی» تا «معماری»: تسلط کامل بر LLM و NLP
🎁 تخفیف  + پرداخت سه قسطی + مشاوره رایگان

‼️این یک دوره آموزشی سطحی برای آشنایی با هوش مصنوعی نیست! دیتایاد، یک برنامه مهندسی فشرده برای تسلط بر مدل‌های زبانی بزرگ و پردازش زبان طبیعی رو برای ساخت سیستم‌های هوشمند واقعی، از مدل‌های اختصاصی تا APIها، براتون فراهم کرده!

🚀  برنامه درسی ما دقیقاً برای همین هدف طراحی شده است:
پایه‌ها (فصل ۱): شروع با مبانی پردازش زبان طبیعی.

هسته (فصل ۲): کالبدشکافی کامل معماری ترنسفورمر.

اجرا (فصل ۳): بررسی معماری‌های شاخص LLM و استراتژی‌های پیاده‌سازی.

تخصص (فصل ۴): تسلط بر تکنیک‌های حیاتی RAG و Fine-Tuning.

خروجی (فصل ۵): اجرای پروژه‌های واقعی و پایان‌دوره.

🤝
این یه رفاقت دائمیه:
✅ دسترسی دائمی به ویدیوها
✅ پشتیبانی همیشگی در تلگرام
✅ به‌روزرسانی‌های رایگان


🔴 لینک دسترسی و ویدیو معرفی دوره
🟡لینک دریافت مشاوره رایگان

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • ❤ 3
Post #813 798
🚀 چرا دیگه فقط Fine-Tuning جواب نمی‌ده؟

تا چند سال پیش هرکی می‌خواست یه مدل هوش مصنوعی مخصوص نیاز خودش بسازه فقط یه راه داشت: فاین‌تیون (Fine-Tuning) کردن مدل.
اما الان بازی عوض شده. مدل‌های زبانی بزرگ مثل GPT دارن با روش‌های جدید خیلی سریع‌تر و بهینه‌تر تطبیق پیدا می‌کنن.⚡🤖

🧠 مدل‌ها چرا از Fine-Tuning رفتن جلوتر؟
دلیلش ساده‌ست؛ کسب‌و‌کارها نیاز دارن سریع، ارزان و قابل کنترل مدلشون رو شخصی‌سازی کنن.
فاین‌تیون فوق‌العاده‌ست اما همیشه بهترین انتخاب نیست — چون:
- هزینه محاسباتی بالا 💸
- نیاز به داده تمیز و زیاد 📦
- ریسک از دست رفتن دانش اصلی مدل 😬
- آپدیت‌پذیری سخت 🔁
برای همین راه‌های جدید اومدن تا بدون اینکه دوباره مدل رو "آموزش" بدیم، بهش یاد بدیم بهتر رفتار کنه 👇
⚙️ جایگزین‌های امروزی
✨ Prompt Engineering (مهندسی پرامپت)
با دستور درست، مدل رو مجبور می‌کنی بهتر فکر کنه — بدون تغییر وزن‌ها.
✨ RAG (بازیابی اطلاعات به مدل)
به مدل حافظه واقعی می‌دی؛ مثل دادن دیتابیس و نُت‌ها برای جواب‌های دقیق‌تر.
✨ LoRA / PEFT (بهینه‌سازی سبک وزن)
به‌جای آموزش همه مدل فقط بخش کوچیکی رو یاد می‌دی، ارزون و سریع.
✨ Function Calling / Tool Use
به مدل ابزار می‌دی تا کار عملی انجام بده، نه فقط متن تولید کنه.
✨ AI Agents (ایجنت‌ها)
مدل + حافظه + ابزار + تصمیم‌گیری مرحله‌ای = رفتار هوشمند واقعی 🔁
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 🔥 2
Post #812 810
⚡ ایجنت‌های هوش مصنوعی حالا یاد می‌گیرن! با Agent Lightning از مایکروسافت

اگه فکر می‌کردیم رقابت فقط روی مدل‌های هوش مصنوعیه… الان وقتشه ایجنت‌ها هم یه لِوِل آپ بزرگ بگیرن 😎🤖
مایکروسافت یه فریم‌ورک جدید به اسم Agent Lightning معرفی کرده که مشکل اصلی ایجنت‌ها رو حل می‌کنه:
قبلاً فقط کار انجام می‌دادن، الان می‌تونن یاد بگیرن و بهتر بشن! 🚀

🧠 چی تغییر کرده؟
ایجنت‌ها تو ابزارهایی مثل LangChain، AutoGen و OpenAI Agents تا الان این‌جوری بودن:
✅ اجرا می‌کردن
❌ از تجربه یاد نمی‌گرفتن
❌ خودشون بهتر نمی‌شدن

اگه می‌خواستیم بهتر شن؟
یا باید پرامپت‌رو دستی بهینه می‌کردیم
یا کل مدل رو از اول آموزش می‌دادیم 😵

اما Agent Lightning بازی رو عوض کرده:

✨ یه لایه‌ی آموزش میاد روی همون ایجنت فعلی
✨ رفتار ایجنت ضبط می‌شه (trace + actions + reward)
✨ با Reinforcement Learning، SFT و Prompt Tuning خودش بهتر می‌شه
✨ می‌تونی Reward Function اختصاصی تعریف کنی

به زبان ساده:
ایجنت‌ها از "ربات اجراکننده" به "عامل یادگیرنده" تبدیل شدن 🧠🔥
🔗 ریپو Agent Lightening
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 😍 6
Post #811 775
🚀 چرا «اعداد کوچک‌تر» مدل‌های هوش مصنوعی رو سریع‌تر می‌کنن؟

تو مدل‌های هوش مصنوعی، همه‌چی عدد و ماتریسه!🧮
اما نکته جذاب اینجاست: وقتی عددها رو با بیت کمتر ذخیره کنیم (مثلاً 8-bit به جای 32-bit)، محاسبات خیلی سریع‌تر میشه و حافظه کمتری لازم داریم، مخصوصاً روی موبایل و لپتاپ.
این روش اسمش Quantization‌‌عه، و باعث میشه مدل‌های بزرگ راحت روی دستگاه‌های کوچیک اجرا بشن. 🤖⚡

🔢 کوانتیزیشن یعنی چی؟
در حالت عادی، مدل‌ها با اعداد ۳۲ بیت یا حتی ۶۴ بیت کار می‌کنن؛ یعنی دقت بالا اما مصرف رم و انرژی خیلی سنگین. ⚙️💥
کوانتیزیشن میاد این عددها رو کوچیک‌تر می‌کنه تا سرعت و بهره‌وری بره بالا.

🔹 ۳۲ بیت → دقت عالی، اما هزینه پردازش و حافظه زیاد
🔹 ۱۶ بیت → استاندارد اکثر مدل‌های مدرن مثل GPT برای حفظ دقت و افزایش سرعت
🔹 ۸ بیت و حتی ۴ بیت → مناسب برای اجرای مدل روی CPU لپتاپ‌ها و موبایل‌ها

🧠 با بیت کمتر، مدل سریع‌تر میشه، ولی اگه بیش از حد کم کنیم، دقت افت می‌کنه.
بنابراین مدل‌های پیشرفته ترکیبی کار می‌کنن: بخش‌های حساس با دقت بالا، بقیه با دقت پایین.
اسم این رویکرد Mixed Precision هست ✨


نتیجه؟
هوش مصنوعی مقیاس‌پذیرتر، کم‌هزینه‌تر و قابل حمل روی دستگاه‌های روزمره. همین تکنیکه که باعث شده LLMهای لوکال اینقدر ترند بشن! 📱🔥
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • ❤ 4
Post #810 784
🛠️ دیباگ هوشمند در گوگل کروم با Gemini🤖

دیگه لازم نیست بین هزار تا داده Performance گم بشیم!
حالا داخل Chrome DevTools می‌تونیم بعد از ضبط Trace، مستقیم با Gemini چت کنیم و ازش بخوایم عملکرد اپ رو تحلیل کنه، bottleneck ها رو پیدا کنه و حتی داده‌های مرتبط میدانی رو هم بررسی کنه. 🤖

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 🔥 5
Post #809 1K
🧠 یادگیری MLOps از پایه با این ریپازیتوری کاربردی

خیلی وقت‌ها برای یادگیری MLOps منابع پراکنده هستن.
پروژه MadeWithML یک مسیر مرحله‌به‌مرحله ارائه می‌کنه که چطور مفاهیم پایه مهندسی نرم‌افزار و یادگیری ماشین رو کنار هم قرار بدیم و سیستم‌های عملی بسازیم.🤖
تو این پروژه با مفاهیمی مثل ساختاردهی پروژه، مدیریت داده، پایپ‌لاین مدل، تست و دیپلوی آشنا می‌شید.👨‍💻
نکته مهم اینه که اصولش برای کار با مدل‌های زبانی بزرگ و LLMOps هم قابل استفاده است.✅

تمام محتوا رایگان و اوپن‌سورس منتشر شده و تمرکز اصلی روی درک عمیق اصول و ساخت راهکارهای واقعیه.🦾

🔗 ریپو MadeWithML
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • ❤ 3
  • 👏 3
Post #808 791
🎯 قانون احتمال؛ قلب تصمیم‌گیری در هوش مصنوعی

تقریباً هر مدل هوش مصنوعی یه کار اصلی انجام می‌ده:
پیش‌بینی احتمال.
اینکه کلمه بعدی چیه؟ تصویر چیه؟ کاربر چی انتخاب می‌کنه؟
همه‌ش یعنی مدل داره احتمال می‌سازه و انتخاب می‌کنه. 🤖📊
پس اگه بگیم «قانون احتمال = ستون اصلی AI مدرن»، اغراق نکردیم.
از چت‌بات‌ها تا سیستم‌های توصیه‌گر و مدل‌های مولتی‌مودال، همه روی احتمال می‌چرخن. 🧠⚡

🕰 مسیر ورود احتمال به هوش مصنوعی (از قمار تا مدل‌های زبانی)
داستان از قرن ۱۷ شروع شد، وقتی پاسکال و فرما روی مسائل قمار کار می‌کردن و ریاضی احتمال رو پایه‌گذاری کردن.
بعد، دانشمندانی مثل لابِلاس و بیز نشون دادن که می‌تونیم با احتمال درباره جهان فکر کنیم و پیش‌بینی انجام بدیم.

تو قرن ۲۰، با کارهای کولموگوروف و فیشر احتمال تبدیل به چارچوب رسمی آمار شد.
این پایه شد برای الگوریتم‌هایی مثل:

- شبکه‌های بیزی (Bayesian Networks)

- مدل‌های مارکوف پنهان (HMM)

- الگوریتم EM

دهه ۹۰ و ۲۰۰۰ هوش مصنوعی فهمید:
بدون احتمال نمی‌تونیم از داده یاد بگیریم.

امروز هم LLMها، سیستم‌های توصیه‌گر، مدل‌های تولید تصویر،
همه دارن یه کار انجام می‌دن:
انتخاب محتمل‌ترین پاسخ.
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 🤯 5
Post #807 886
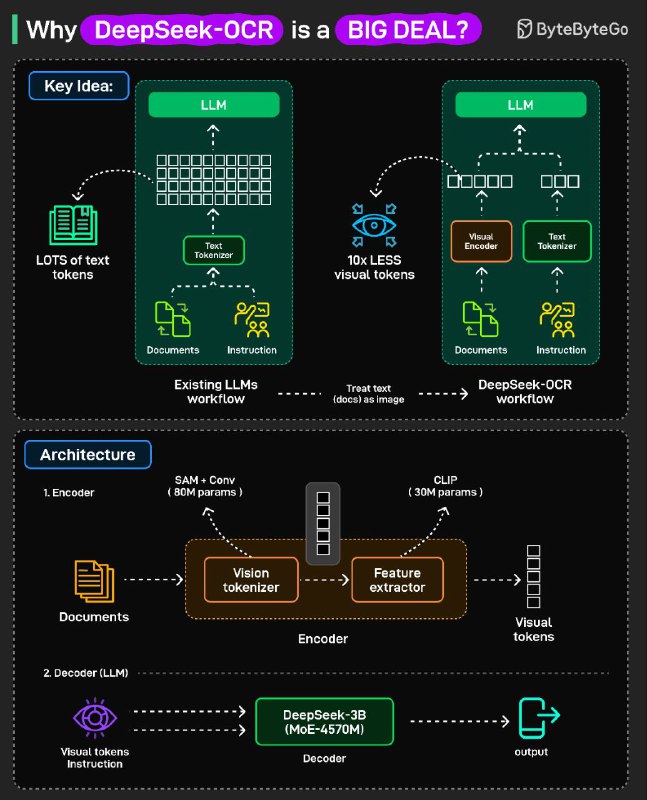
🧠 مدل DeepSeek-OCR چطور بازی OCR رو عوض کرد؟

قبلاً درباره DeepSeek-OCR حرف زدیم، اما این تصویر دقیقاً نشون میده چرا این مدل ترند شد.
ایده ماجرا ساده‌ست ولی impact خیلی بزرگه:
به‌جای اینکه مثل همیشه هر کلمه جداگانه پردازش بشه، کل سند به شکل تصویر خونده میشه و تعداد توکن‌های متنی تا ۱۰ برابر کمتر میشه. 🤯

نتیجه؟
سرعت بالاتر، هزینه کمتر، دقت بهتر، به‌خصوص تو فایل‌های پیچیده و چندزبانه. 📄⚡

🚀 معماری جدید یعنی چی؟
در OCRهای قبلی، مدل مستقیماً متن رو توکنایز می‌کرد و پردازش می‌کرد.
ولی اینجا سند اول به توکن تصویری تبدیل میشه، ویژگی‌ها استخراج میشن و بعد مدل تصمیم می‌گیره.

این یعنی:
✅ محاسبات کمتر
✅ عملکرد بهتر روی جدول‌ها، فرمول‌ها و دست‌خط
✅ سرعت عالی روی اسناد بزرگ و پیچیده

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • ❤ 4
  • 🔥 1
Post #806 979
🧠 کامپیوترهای کوانتومی چه اثری روی هوش مصنوعی دارن؟

همه دارن درباره AI حرف می‌زنن، ولی یه موج دیگه آروم‌آروم نزدیک میشه:
کامپیوترهای کوانتومی.
اگه GPUها موتور انفجار یادگیری عمیق بودن، کوانتوم قراره توربو بوست علم داده و مدل‌های هوش مصنوعی باشه.
ولی نه الان، در آینده نزدیک. 🌀⚡

🚀 تاثیرش روی AI چیه؟
✅ آموزش مدل‌های عظیم سریع‌تر
به‌جای روزها یا هفته‌ها، مدل‌های غول‌پیکر ممکنه تو چند ساعت آموزش ببینن.
مخصوصاً الان که مدل‌ها دارن میرن سمت تریلیون پارامتر.

✅ حل بهینه‌سازی‌های سخت شبکه عصبی یعنی حل یک مسئله بزرگ بهینه‌سازی.
کامپیوتر کوانتومی اینجا مثل تقلب تو بازیه 🎮
راه‌حل‌های بهتر → دقت بالاتر → مدل‌های هوشمندتر

✅ پیشرفت در علم داده و شبیه‌سازی
تحلیل داده‌های بسیار پیچیده، شبیه‌سازی‌های پزشکی/مالی/اقلیمی…
جایی که کلاسیک‌ها کم میارن، کوانتوم می‌درخشه.

✅ الگوریتم‌های جدید یادگیری
یادگیری ماشینی کوانتومی (QML)
مدل‌هایی که اساسشون با اکنون فرق داره, نه فقط نسخه سریع‌تر از LLMهای فعلی.

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • ❤ 7
  • 🔥 1
Post #805 881
🧠 چرا مدل‌های زبانی دارن ماژولار می‌شن؟ 🤖

دیگه دوران «یه مدل که همه‌چیز رو خودش انجام بده» تمومه.
حالا AI داره از یه مغز بزرگ، تبدیل میشه به تیم اکسپرت‌ها.
چرا؟ چون مدل‌های عظیم وقتی همه مسئولیت‌ها رو خودشون به دوش می‌کشن، هزینه می‌ره بالا، سرعت کم میشه و آپدیت‌شون سخت میشه.
پس رفتن سمت معماری ماژولار باعث میشه هر بخش یه کار مشخص رو انجام. بده، دقیق و کم‌هزینه ✅

⚙️ چی تغییر کرد؟
تو مدل‌های قدیمی، LLM هم دانش ذخیره می‌کرد، هم استدلال، هم ابزار اجرا، هم بازیابی اطلاعات. 💯
الان؟ هرکدوم جدا شده 👇

- حافظه بیرونی (Memory / Vector DB) برای دانش

- ماژول بازیابی اطلاعات (Retriever)

- ماژول استدلال (Reasoning Engine)

- ابزارهای بیرونی مثل Python و APIها

- خود LLM فقط نقش مغز هماهنگ‌کننده داره

نتیجه؟
🔹 هزینه کمتر
🔹 سرعت بیشتر
🔹 آپدیت راحت‌تر
🔹 دقت تخصصی‌تر

هوش مصنوعی داره میره سمت سیستم‌های چندبخشی؛ نه یه مغز همه‌چیزدان، بلکه معمار + متخصص + حافظه + ابزار کنار هم. 🚀
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 👏 4
  • ❤ 2
Post #804 906
🧠 ورک‌فلو پردازش در هوش مصنوعی؛ پشت صحنه مغز دیجیتال 🚀

وقتی یه مدل هوش مصنوعی جواب می‌ده، پشت پرده کلی مسیر داده و محاسبه اتفاق میفته. خیلی‌ها فکر می‌کنن “دیتا → مدل → خروجی” اما واقعیتش یه جریان حرفه‌ای و چند مرحله‌ایه که سرعت، دقت و مصرف منابع رو تعیین می‌کنه.

امروز می‌خوایم دقیق ببینیم داده‌ها کجا میرن؟ چطور پردازش می‌شن؟ و مدل کجا زندگی می‌کنه؟ 🤓

📂 مرحله 1: ذخیره‌سازی اولیه (Storage Layer)
داده‌ها اول تو سیستم‌های ذخیره‌سازی قرار می‌گیرن:

- دیتابیس‌ها (SQL/NoSQL)

- فایل سیستم‌ها یا فضای ابری (S3, GCS)

- دیتا‌لِیک‌ها برای داده‌ خام

⚠️ اینجا فقط آرشیوه — بی‌هیچ پردازش سنگینی.
🔄 مرحله 2: پردازش و آماده‌سازی (Data Pipeline)
داده‌ها قبلِ رسیدن به مدل باید تمیز و قابل استفاده شن:

- پاکسازی و نرمال‌سازی

- تبدیل و فیلتر کردن

- استخراج ویژگی‌ها

📍 این مرحله معمولاً روی سیستم‌های پردازشی جدا انجام میشه
مثل Spark، Airflow یا GPUهای مخصوص پردازش دیتا.
🎛️ مرحله 3: حافظه سریع پردازش (RAM / GPU VRAM)
وقتی مدل آماده اجراست، داده‌ها میان تو حافظه سریع:

- حافظه RAM برای CPU

- حافظه VRAM برای GPU

اینجاست که مدل می‌تونه بلادرنگ داده رو بخونه و عملیات ماتریسی انجام بده.
🤖 مرحله 4: اجرای مدل (Inference Engine)
مدل داخل حافظه GPU/CPU لود میشه و محاسبه شروع میشه:

- عملیات Tensor

- ضرب ماتریس ها

- اکتیویشن‌ها و لایه‌ها

نتیجه داخل همون حافظه موقت ذخیره میشه تا خروجی تولید بشه.
📤 مرحله نهایی: خروجی و ذخیره پس از پردازش
نتیجۀ مدل می‌ره به:

- حافظه موقت (cache) برای پاسخ سریع

- دیتابیس گزارش‌ها

- سرویس API یا اپلیکیشن

مثلاً توی ChatGPT، خروجی یه‌بار حافظه کوتاه‌مدت می‌گیره تا پیام بعدی رو بهتر بفهمه.
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 👍 3
  • 🤯 2
  • 🗿 1
Post #803 750
⚙️ هوش مصنوعی در جیب شما، اما چطور؟! 📱

وقتی از مدل‌های هوش مصنوعی حرف می‌زنیم، ذهنمون می‌ره سمت سرورهای غول‌پیکر و کارت‌های گرافیک چندده‌هزار دلاری.
اما واقعیت اینه که یه بخش بزرگ از آینده‌ی AI داره روی دستگاه‌های کوچیک و با منابع محدود اتفاق می‌افته, از موبایل گرفته تا سنسورهای IoT. 🤖

🧠 تفاوت مدل‌های سبک با مدل‌های عادی
مدل‌هایی که برای دستگاه‌های کوچک طراحی می‌شن، معمولا چند تا ویژگی مهم دارن:
✅ تعداد پارامتر کمتر: به جای میلیاردها پارامتر، فقط چند میلیون دارن تا روی حافظه‌ی محدود جا بشن.
✅ حافظه و توان مصرفی پایین‌تر: طوری طراحی می‌شن که با رم یا باتری کم هم کار کنن.
✅ پاسخ‌دهی سریع‌تر: نیازی نیست برای هر سؤال به سرور متصل شن؛ مستقیماً روی دستگاه جواب می‌دن.
🔧 چطور بهینه‌سازی می‌شن؟
برای اینکه این مدل‌ها همچنان دقیق بمونن، چند تکنیک کلیدی استفاده می‌شه:

کوچک‌سازی مدل (Model Compression): حذف وزن‌ها و نودهای غیرضروری بدون افت زیاد در دقت.

کوانتیزیشن (Quantization): کاهش دقت اعداد (مثلاً از ۳۲ بیت به ۸ بیت) برای سرعت و صرفه‌جویی در فضا.

پرونینگ (Pruning): بریدن شاخه‌های کم‌اثر شبکه برای سبک‌تر شدن مدل.

دانش‌انتقالی (Knowledge Distillation): یه مدل بزرگ، نقش معلم رو برای یه مدل کوچک‌تر بازی می‌کنه تا اونم یاد بگیره.
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 👏 4
Post #802 779
🧠 سونیک ۳؛ هوش مصنوعی اما صدای انسانی!🤖

یه ویدیو منتشر شده که مدل صوتی جدید Cartesia Sonic 3 رو با ElevenLabs مقایسه می‌کنه، و نتیجه فوق‌العاده‌ست! 😮
سونیک ۳ نه‌تنها سریع‌تره (فقط ۴۰ میلی‌ثانیه تأخیر در مقابل ۱۳۰)، بلکه احساسات و لحن انسانی رو خیلی طبیعی‌تر منتقل می‌کنه. از کنترل زنده‌ی سرعت و بلندی صدا گرفته تا لهجه‌های بومی در ۴۲ زبان مختلف، این مدل نشون داده که صداهای هوش مصنوعی دیگه فقط «شبیه انسان» نیستن، دارن انسان می‌شن! 🎙️

⚡ رقابت، موتور پیشرفت هوش مصنوعی
ورود مدل‌هایی مثل سونیک ۳ رقابت رو در دنیای صداهای هوشمند به اوج رسونده. هر بار که یک شرکت مرز جدیدی رو جابه‌جا می‌کنه، بقیه مجبور می‌شن سریع‌تر، طبیعی‌تر و خلاق‌تر عمل کنن. همین رقابت، دلیلیه که امروز صداهای مصنوعی می‌تونن خنده، هیجان یا حتی تردید رو مثل انسان ادا کنن، چیزی که تا چند سال پیش غیرممکن به نظر می‌رسید. 🚀

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 🤯 3
Post #801 755
🚀 ربات G1 و قدرتی فراتر از تصور! 🧠

ربات G1 تونسته یه ماشین ۱۴۰۰ کیلوگرمی رو بکشه! 😲 واقعاً قدرت مهندسی و دقت کنترلش خیره‌کننده‌ست.
🦾 منبع قدرت G1، موتورهای پیشرفته و سیستم هیدرولیک فوق‌العاده‌ست. نکته جالب اینجاست که هوش مصنوعی به‌صورت هوشمند میزان نیرو و سرعت رو کنترل می‌کنه تا بدون آسیب به خودش یا محیط، چنین حرکت‌های فوق‌العاده‌ای انجام بده.

📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@
  • 🤯 5
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →