
تو پست قبلی دیدیم چطور Alternating Attention با ترکیب لایههای محلی و سراسری، سرعت مدل رو بالا میبره بدون افت دقت. حالا بریم یه قدم جلوتر... 🧠
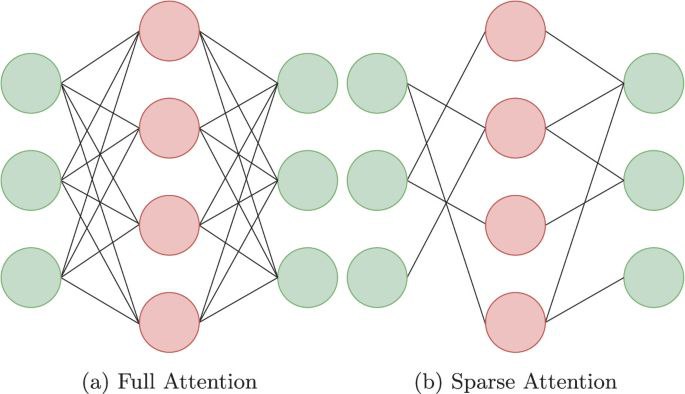
🧩 توجه فشرده (Sparse Attention)
اینجا دیگه بعضی ارتباطها کلاً حذف میشن! هر توکن فقط به چند نقطهی مهم توجه میکنه، نه به همه.
نتیجه؟ مدل سریعتر، سبکتر و آمادهی پردازش متنهای خیلی طولانی — دقیقاً همون کاری که مدلهایی مثل Longformer و BigBird انجام دادن.
📌 مرجع تخصصی هوش مصنوعی و علم داده
🤖 دیتایاد / datayad@