

Последний пост серии, первые два по ссылкам:
1. Подготовка данных
2. Анализ данных
Для виза снова используем cv2. Если данные записаны в таблицу xlsx, то понадобится модуль ast для корректного считывания синтаксиса списков.
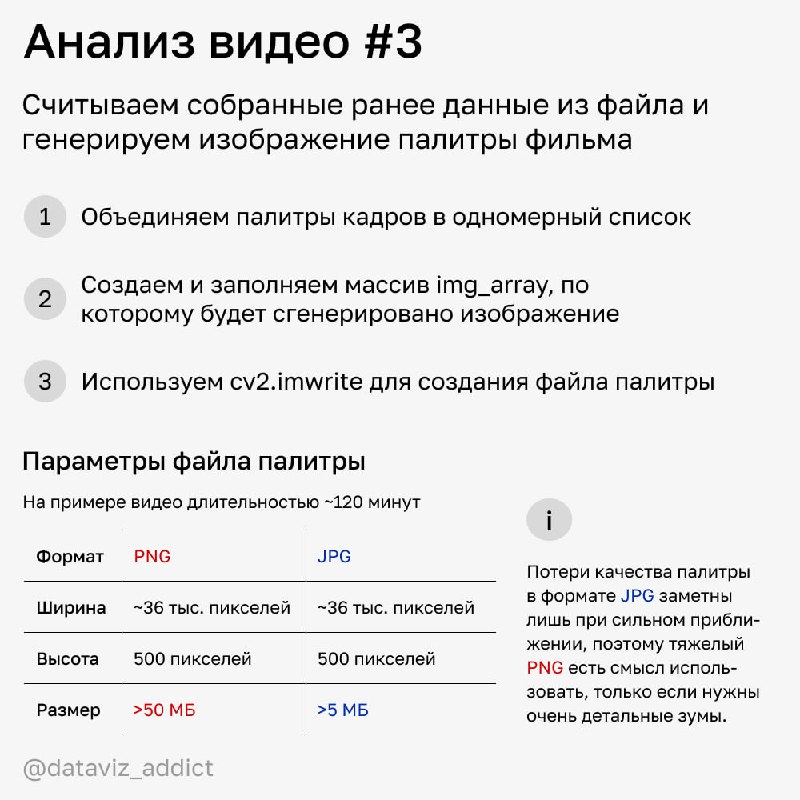
При считывании объединяем данные в одномерный список (colors) и создаем пустой массив:
# суммарное число цветов
colors_length = len(colors)

# высота изображения в пикселях
height = 500;

# создаем пустой массив
# height: число строк
# colors_length: число столбцов
# 3: массив цвета (r, g, b)
img_array = np.zeros((height, colors_length, 3), np.uint8)
После этого заполняем массив цветами и с помощью cv2 создаем изображение:
# заполняем массив
for x in range(colors_length):
    img_array[:,x] = colors[x]

# записываем в файл
cv2.imwrite('file_name.png', img_array)
Подробнее о параметрах файла палитры и том, как с ним работать, — в карточках.
P.S. И как обычно, полный код этой части в комментариях.
#датавиз #python