Допустим вам нужно быстро создать приложение для работы с данными. Оно может включать в себя дэшборд и работу с моделью. Или если вам нужен быстрый прототип для показа заказчику, который можно сделать за несколько часов и бесплатно.
Streamlit отлично подходит под эти задачи. Все на чистом Python. Нужно будет освоить только интерактивные компоненты для создания фильтров/ чекбоксов/ полей ввода/ загрузки файлов.
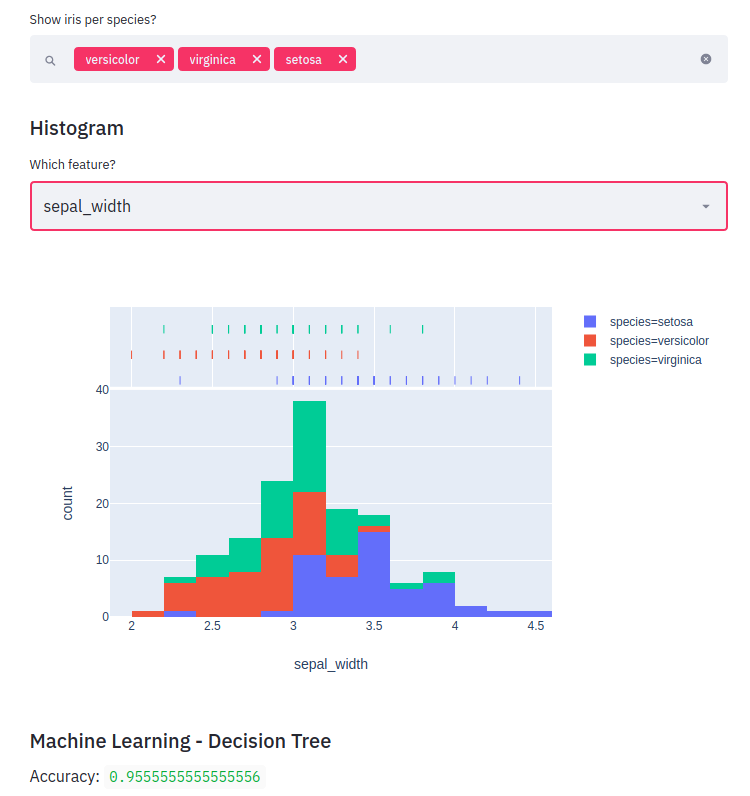
Разберём функционал на уже знакомом примере Ирисов Фишера. Сделаем очень простой дэшборд с выбором вида Ирисов и построением гистограмм. Так же в Streamlit можно обучать и делать инференс моделей.
import streamlit as stimport pandas as pdimport numpy as npimport plotly.express as pximport seaborn as snsimport matplotlib.pyplot as pltimport plotly.graph_objects as gost.title('Iris')df = pd.read_csv("iris.csv")st.subheader('Scatter plot')species = st.multiselect('Show iris per species?', df['species'].unique())new_df = df[(df['species'].isin(species))]st.subheader('Histogram')feature = st.selectbox('Which feature?', df.columns[0:4])new_df2 = df[(df['species'].isin(species))][feature]fig2 = px.histogram(new_df, x=feature, color="species", marginal="rug")st.plotly_chart(fig2)st.subheader('Machine Learning - Decision Tree')from sklearn.model_selection import train_test_splitfrom sklearn.tree import DecisionTreeClassifierfrom sklearn.metrics import confusion_matrixfeatures= df[['sepal_length', 'sepal_width', 'petal_length', 'petal_width']].valueslabels = df['species'].valuesX_train,X_test, y_train, y_test = train_test_split(features, labels, train_size=0.7, random_state=1)dtc = DecisionTreeClassifier()dtc.fit(X_train, y_train)acc = dtc.score(X_test, y_test)st.write('Accuracy: ', acc)pred_dtc = dtc.predict(X_test)cm_dtc=confusion_matrix(y_test,pred_dtc)st.write('Confusion matrix: ', cm_dtc)Дополнительный материал:
Сайт Streamlit - https://www.streamlit.io/
Код с Docker - https://github.com/alimbekovKZ/ML-DL-in-production/tree/master/streamlit