
🗯Поиск аномалий в работе установок грануляции пресс-порошка двуокиси урана для изготовления топливных таблеток. Часть 2 — Алгоритм поиска аномалий на основе генерации невязки
Часть 1 здесь. Научная статья по кейсу здесь
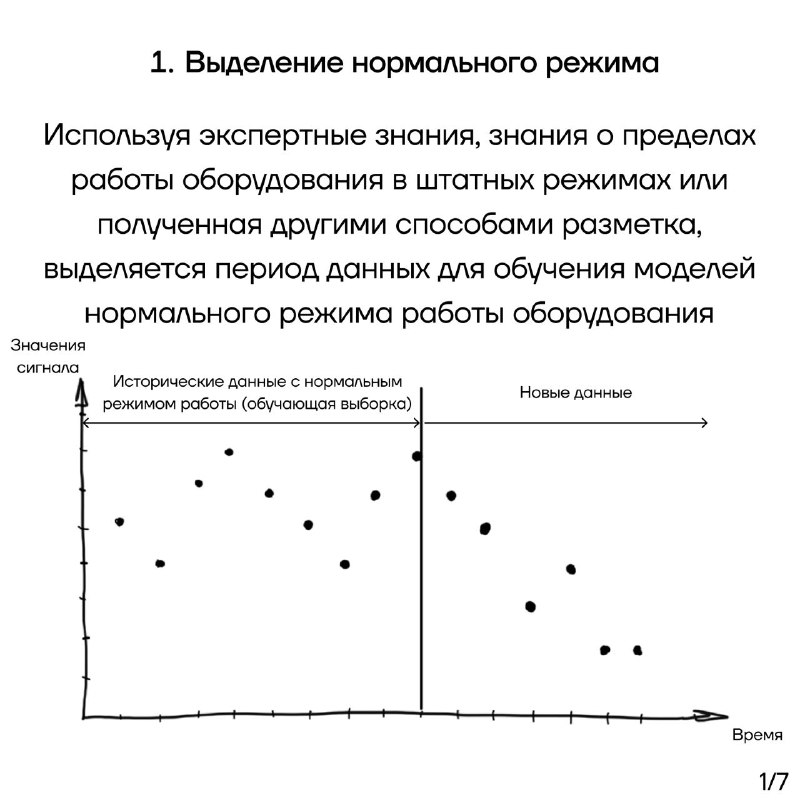
В качестве алгоритма обнаружения аномалий в работе был выбран наиболее распространенный алгоритм - на основе генерации и оценки невязки (расхождения, англ - discrepancy или residuals). Одним из преимуществ алгоритма является необходимость иметь только нормальный режим работы оборудования в исторических данных.
Но сначала давайте немного синхронизируемся в терминологии:
• Модель машинного обучения - функция, отображающая или переводящая объекты (исходные данные) в предсказания (таргет или ответы)
• Алгоритм или метод машинного обучения - процедура или пайплайн, позволяющая превращать обучающую выборку в обученную модель или строить (обучать, подбирать параметры) модель на основе данных
• Алгоритм решения задачи (в нашем случае алгоритм поиска аномалий) - это последовательность действий или пайплайн, приводящий к получению результата в терминах бизнеса. Более общее понятие, чем алгоритм машинного обучения. Может содержать препроцессинг, модель машинного обучения и постпроцессинг
Конечно, модель машинного обучения может являться алгоритмом поиска аномалий, например, если задача ставится как бинарная классификация событий (часто в задачах детекции фрода), то кроме классификатора нам больше ничего и не нужно, как правило. Но чаще модель - всего лишь часть алгоритма решения задачи.
О самом алгоритме на основе генерации и оценки невязки рассказано в карточках 👆
👨💻Кстати, пример реализации алгоритма в коде продемонстрирован здесь
Post #75
1.97K



- 👍 15
- 🔥 6
- 👏 3