TGViewer
Channel Public Channel
Data Engineer

Data Engineer

@dataengineernews

Дата-инженерия в схемах и мемах

По всем вопросам — @mobiledeveloper_bot
Subscribers
478
Photos
190
Videos
3
Links
128

Showing posts older than #209 · Back to latest

Older Posts 20 shown
Post #208 282
#заметкинаполях #C4model #напочитать

Simon Brown, автор книги «C4 Model for Visualising Software Architecture», в которой он вводит лаконичную, но мощную нотацию для построения архитектурных диаграмм, оказал сильное влияние на авторов «Data Mesh in Action», коей, в свою очередь, вдохновляюсь я при решении рабочих задач, а коль скоро так, то мимо пройти я никак не мог. Тем более, что о данной методологии был наслышан, но вот случая ознакомиться не представлялось. А сейчас словно звезды сошлись…

Зачем нужна еще одна методология визуализации архитектуры? Автор отвечает на это следующим образом:

➕ C4 model - это простой способ «увидеть всю картинку целиком» (кто помнит героя популярного сериала, сделавшего эту фразу легендарной?), показать, как все устроено и как составные части «упаковываются» в картину еще большего размера

➕Создает единое видение разрабатываемого «нечто» у каждого члена команды и помогает им оставаться в фокусе, объясняет суть происходящего в том числе и людям без технического бэкграунда

➕ Быстрее вводит в курс дела новых членов команды

➕ При всей своей простоте и лаконичности данный вид диаграмм прекрасно отражает реальность

продолжение следует…
  • 👍 6
Post #207 352
Сохраняем DAG best practices checklist от Марка Ламберти. Он плохого не посоветует...
  • 👍 7
Post #206 372
Ведь может? 😀
  • 🤔 1
Post #205 333
#заметкинаполях #introducingmlops

Закончил чтение «Introducing MLOps». Еще одна понравившаяся глава рассказывает про управление моделями, если кратко, то - это очередное «наше все», без которого ничего работать не будет нормально.

В общем, относитесь к руководству моделями серьезно, не откладывайте в долгий ящик, планируйте процесс заранее, продумывайте политики, найдите инструменты для централизованного их представления и распространения на всю организацию ради.

Это займет много времени, понадобится не одна итерация, но в конце пути, оглянувшись назад, вы будете гордиться собой, подобно Александру Овечкину, давеча перекрывшему великое достижение товарища Ивана Грецкого.

За сим на этом все. А коль скоро так, самое время открыть новую книгу, надеюсь, не менее интересную.
  • 👍 4
Post #204 354
Post #203 295
Post #202 370
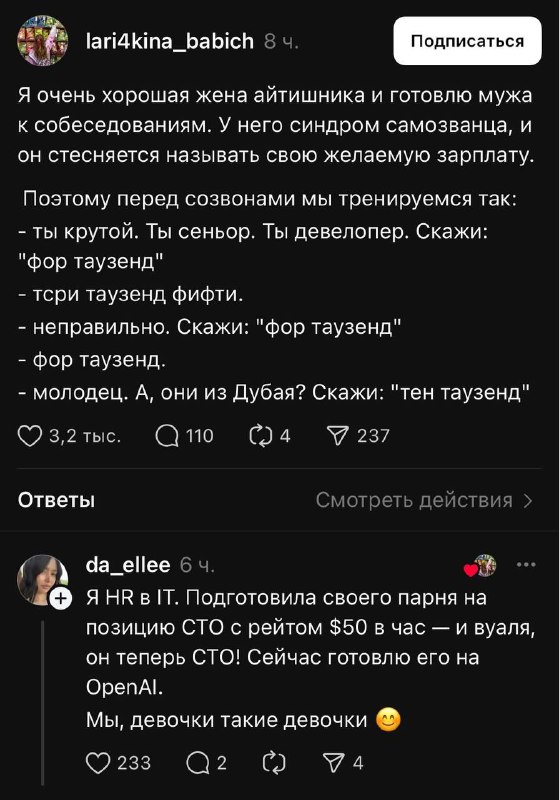
Как правильно готовиться к собеседованиям... "Жены всегда лучше знают, чего мы хотим" ("Папины дочки. Новые")
  • 😁 11
Post #201 317
#заметкинаполях #introducingmlops

В последние три недели с головой упал в омут типичных трудовых будней среднестатистического отечественного «руками водителя». Времени #напочитать не было практически совсем. Ну, как совсем… Просто в пятом томе великой «Махабхараты» про данные нет ни единого слова. Зато много чего интересного есть про ведение сложных переговоров, разрешение конфликтных ситуаций и последствиях потакания токсичным персонажам… Но это так, лирическое отступление. Время возвращаться к делам нашим MLOps-ным.

Третья глава - самая полезная в книге, на мой взгляд, ибо в ней дается вехнеуровневое описание жизненного цикла машинного обучения (development, deployment, monitoring, iteration, and governance) достаточное для понимания человеком от ML довольно далекого, что является бесценным для «руками водителя», просто сверяйся с книгой, «все уже украдено до нас».

В последующих главах каждый компонент цикла рассматривается подробнее.

продолжение следует...
  • 👍 2
Post #200 271
По-моему, прекрасно...
  • 👍 8
Post #199 405
Еще не читал, но уже рекомендую. Ибо статья от первопроходца, начавшего внедрять Data Mesh на отечественных просторах, "у берез и сосен", так сказать, задолго до того как это стало мейнстримом, обязательна к прочтению, на мой взгляд.

Дима - топчик!

https://medium.com/adeo-tech/samurais-journey-mashup-of-data-mesh-and-other-data-approaches-1286a2a5c72d
Medium Samurai’s Journey: Mashup of Data Mesh and Other Data Approaches This article explores our ongoing transition from a centralized data management and governance approach, which began in 2019, to an…
  • 👍 2
Post #198 288

Forwarded from DataJourney

…продолжаю про Iceberg

Попробую вкратце описать фичи протокола, который делает его таким популярным. Первое, о чем хочется поговорить и самое главное, на мой взгляд, - это пачка статистики и описаний, которая лежит рядом с дата файлами и содержит информацию, которую используют движки расчета для того, чтоб поднимать данные из S3. Несмотря на все свершения человечества, одной из самых медленных операций по прежнему остаётся подъем данных с диска и все системы, которые оперируют с данными, стараются уменьшать количество байт, которые читаются в память. У Iceberg эти принципы вшиты прямо в протокол.

На картинке к посту изображена схема хранения из документации Iceberg (github link). Условно, протокол делит все данные на три большие части (снизу-вверх):
1️⃣ Собственно сами данные. Это файлы в форматах Parquet, Avro или ORC. Тут никакой магии. Просто данные, просто на хранилище.
2️⃣ Слой метаданных. Тут уже начинается магия связи верхнеуровнего объекта «таблица» с множеством файлов из первого пункта. Имеем три группы файлов:
файлы манифеста, который описывает файлы с данными: их расположение, статистики столбцов и партиции;
файлы со списком файлов манифеста, который описывает обобщенные статисткии уже файлов манифестов и их перечень;
файлы метаданных, который описывает «таблицу» в целом, списки манифестов для каждого конкретного снэпшота. Эти же файлы обеспечивают изоляции по принципам MVCC. Если два процесса одновременно собираются читать и писать данные, то создается копия файлов, достаточная для того, чтобы каждый процесс получил доступ к данным изолированно. Каждая такая копия - это снапшот. О них детальнее поговорим позже, но даже на этой схеме уже видны две версии таблицы db1.table1: S0 и S1, для которых хранятся отдельные наборы файлы манифестов, метаданных и данных. При этом, для обеспечения изоляции, в моменте файлы с данными будут дублироваться, что приведет к повышенному потребелению ресурсов дискового пространства.

3️⃣ Каталог. Некая сущность, которая умеет хранить информацию о связи «объект таблица» - «набор метаданных». Единственное требование к каталогу - уметь инфомрацию перезаписывать атомарно. Так, чтобы два процесса одновременно не смогли создать конкурирующие наборы файлов. Поговорим о каталогах чуть поздней.

Таким образом, получается, что для записи информации в формате Iceberg движок должен последоватльно создать записи в трёх местах:
1. Записать данные на хранилище.
2. Посчитать агрегаты и записать их в слой метаданных.
3. Записать информацию о привязке новых метаданных в каталог.

При этом есть одна вещь, про которую следует помнить. Информация, которая указана в манифесте - даётся под «честное слово». Так как Iceberg это не управляющая программа, то никто не проверяет действительно ли есть файл данных, если он указан в манифесте. Действительно ли существуют ограничения (uniq, not null, order) если они указаны в манифесте.
  • 👍 5
Post #197 300

Forwarded from DataJourney

Кто такой Apache Iceberg

В последнее время вокруг ввсе больше и больше информации про озера данных и какое-то слово «Iceberg», которое позволяет строить такие хранилища. До ознакомления с вопросом, я ошибочно полагал, что Icebrg - это просто новый формат файла по аналогии с Parquet или Avro, которй предлагает какие-то новые фичи, которых не было до него.

На самом же деле, Iceberg - это некий протокол, который описывает договоренность по укладке файлов в хранилище, чтобы потом эти файлы можно было удобно с хранилища поднимать и выполнять к ним запросы. При этом сами файлы, которые физичеки находятся на диске, имеют уже знакомые форматы: Parquet, Avro или ORC. Рядом с файлами данных лежат статистики - отдельные файлы, в которых описано их содержимое: максимумы, распределения, количество и т.п.

Команда Icebreg написала реализацию протокола для некоторых движков (вот, например, jar для Apache Spark 3), что позволило достаточно комформтно начать работать работать с новым форматом на имеющихся инсталяциях этих самых движков. По сути, администратору нужно добавить пару библиотек и дать доступ к бакету S3, чтоб начать использование.

Пошупать Iceberg локально в связке со с Spark можно с помощью Docker и нехитрой инструкции из официальной документации: https://iceberg.apache.org/spark-quickstart/
  • 👍 7
Post #196 290

Forwarded from Архитектор Данных

3 основных кейса применений Лейкхаусов

По наблюдениям, сегодня доминируют эти три основных кейса внедрения домика у озера.

1. КХД+. У нас уже есть достаточно развитое хранилище данных. У нас есть команда в 30-50 человек специалистов по данным. Мы хорошо умеем извлекать из них ценность. И вот у нас появляются данные, которые все еще ценные для бизнеса, но которые уже нецелесообразно загружать в КХД. Логи, события, кликстримы. Нужно решение, которое сохранит простоту и привычность доступа к данным, при этом не разорит нас. Тут и появляется гибко масштабируемый ДатаЛейк[Хаус].

2. Next Gen DataLake. И здесь же миграция с хадупа. Вы не поверите, сколько сейчас хадупов на бесплатном Хортоне, который застыл в развитии в 2016 году. Куда-то надо это везти в перспективе. Менять старый хадуп на более новый - ну такое, это все же очень архаичная система. А что есть современнее? (Желательно не очень дорогое)

3. Технологии+. Некоторые не хотят Мерседес, некоторые фанаты Теслы. Причем, с пониманием, что Тесле нет того и этого, и вообще как машина она, мягко говоря, уступает. Но вот хочется быть на острие прогресса.

Стыдливо опускаем кейс номер три-с-половиной, где нам всем очень хочется поиграться с новой технологией и записать ее себе в CV.
  • 👍 4
Post #195 381
#заметкинаполях #introducingmlops

Пока доволен чтением «Introducing MLOps». Авторы, следуя заветам Льва Николаевича Гумилева, начали с определения.

MLOps - это процесс стандартизации и оптимизации цикла (development, deployment, monitoring, iteration, and governance) машинного обучения.


Что характерно, важную роль в процессе должны играть все: от представителей бизнеса до технарей все мастей.
Несмотря на то, что из определения все понятно, продолжил читать дальше

Продолжение следует...
  • 👍 7
Post #194 333

Forwarded from DataJourney

Немного истории Greenplum

В продолжение новости про документацию GP. Порой, в поисках доки или каких-то решений в поисковике можно попадать на разные сайты или на мертвые ссылки, которые вроде бы должны описывать то или иное поведение. А все по той причине, что история владения Greenplum сложна:

2005 год, компания Greenplum Software выпускает продукт Bizgres – СУБД, основанную на коде PostgreSQL, которая умеет в колоночное хранение и горизонтальное масштабирование;
2010 год, компанию поглощает компания EMC (ныне Dell EMC), продукт сохраняет название компании и теперь называется Greenplum Database;
2012 год, из EMC выходит компания Pivotal, которая продолжает разработку, а продукт теперь называться Pivotal Greenplum Database;
2013 год, Pivotal презентует вариант Greenplum с хранением данных файловой системе Hadoop, который называет Hawq;
2015 год, Pivotal выкладывает код Greenplum DB и Hawq в OpenSource;
2019 год, компанию Pivotal поглощает компания VMware, продукт теперь называется VMware Greenplum;
2020 год, VMware презентует VMware Tanzu Greenplum – вариант Greenplum для разворачивания в облаке;
2022 год, Broadcom анонсирует крупную сделку и покупает VMware целиком по рыночной стоимости;
2024 год, Broadcom закрывает код Greenplum (github)

Что будет дальше? А дальше все в тумане. Ближе всего к нам есть Greenplum от Аренадаты, но это уже не OpenSource.
Post #193 353
#пятница

Когда с утра сделал 12x(200/200) по 38-39с под генделевские кантаты в исполнении французского ВИА «Il Seminario Musicale» под руководством заслуженного контратенора Gérard Lesne, невольно приходишь к выводу, что сия модель данных единственно верная.
  • 👍 4
Post #192 321
Post #191 419
Когда
аналитик
терзает
витрины,
Адхоки
селектя
в пятьсот,
измерений,
Вскрывать,
инженер,
не спеши
себе вены,
А взор
обрати свой
на Iceberg
и Trino!
В. В. Маяковский (ну почти)

Если кому-то нечем заняться в выходные, то посмотреть запись вебинара от VK Cloud - прекрасное решение.

https://t.me/analyticsfromzero/86
Telegram Архитектор Данных Спасибо всем кто смотрел вебинар! Запись тут: https://vkvideo.ru/video-164978780_456239621 Спасибо всем, кто задавал вопросы! Продолжить дискуссию можно в комментариях.
  • 👍 5
  • 🔥 1
Post #190 329
Если ваши друзья или же коллеги до сих пор не понимают, чем Data Engineering отличается от Software Engineering, просто покажите им эту статью.
Она, конечно, уже старенькая, но, тем менее, ее чтение поможет понять разницу.

Любимая цитата:
Если набор данных содержит 9 из 10 необходимых колонок, является ли он на 90% полезным?


Осторожно, очень много букв (примерно на 14 минут чтения) и, возможно, понадобится VPN, но оно того стоит.

https://medium.com/better-programming/data-engineering-is-not-software-engineering-af81eb8d3949
Medium Data Engineering is Not Software Engineering Pretending like data and software are the same is counterproductive to the success of your data engineers
  • 👍 4
Post #189 270
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →