Я писал не так давно
большой пост о том, что AI постепенно становится не только объектом исследований, но и субъектом научного поиска. Тот пост был посвящён
Google Co-Scientist и
AI Scientist-v2 от Sakana AI. И вот появились ещё новости в том же направлении, отчасти буквально точные аналогии.
Robin: A multi-agent system for automating scientific discoveryЭто новая мультиагентная система (см. структуру и схему работы на рис. 1), во многом аналогичная Google Co-Scientist, но вот другие исследователи (из FutureHouse и Оксфорда) тоже попробовали, и у них тоже получилось! У них все агенты — это птицы: в системе Robin есть Crow и Falcon, которые анализируют литературу и генерируют идеи, а Finch обрабатывает экспериментальные данные. Как известно (хотя не факт), хищным птицам у людей больше всего нравятся глаза. Вот и здесь система Robin нашла перспективный препарат для лечения
сухой макулодистрофии (вообще не разбираюсь, не знаю что это, но говорят, что одна из основных причин слепоты у взрослых). Очень, кстати, разумная общая постановка задачи: авторы сконцентрировались на drug repurposing, то есть, с одной стороны, здесь уже заведомо есть литература, которую LLM может изучить, а с другой стороны, если что-то найдётся, путь к реализации будет относительно простым.
ZochiА это прямой аналог AI Scientist'ов от Sakana: тоже мультиагентная система, которая пишет статьи end-to-end (схема на рис. 2), по абстрактному запросу вроде "придумай что-нибудь новенькое про AI safety". Когда модель от Sakana попала на workshop при ICLR, я тут же (успешно) предсказал, что все сразу скажут, что "воркшоп не считается". Ну что ж, вот теперь статью
приняли на ACL 2025, на главный трек, acceptance rate около 20%, всё совсем уж всерьёз. Принятая статья, кстати, про jailbreaking, называется "
Tempest: Autonomous Multi-Turn Jailbreaking of Large Language Models with Tree Search", и выглядит она очень круто, я бы тоже принял не задумываясь. Там нет ничего технически сложного, все эксперименты и подходы по сути пишут сами себя, но, если я правильно понял, Zochi смог сделать главное: найти пробел в текущем фронтире этой области, тот самый низко висящий плод, который потом уже сорвать было делом техники.
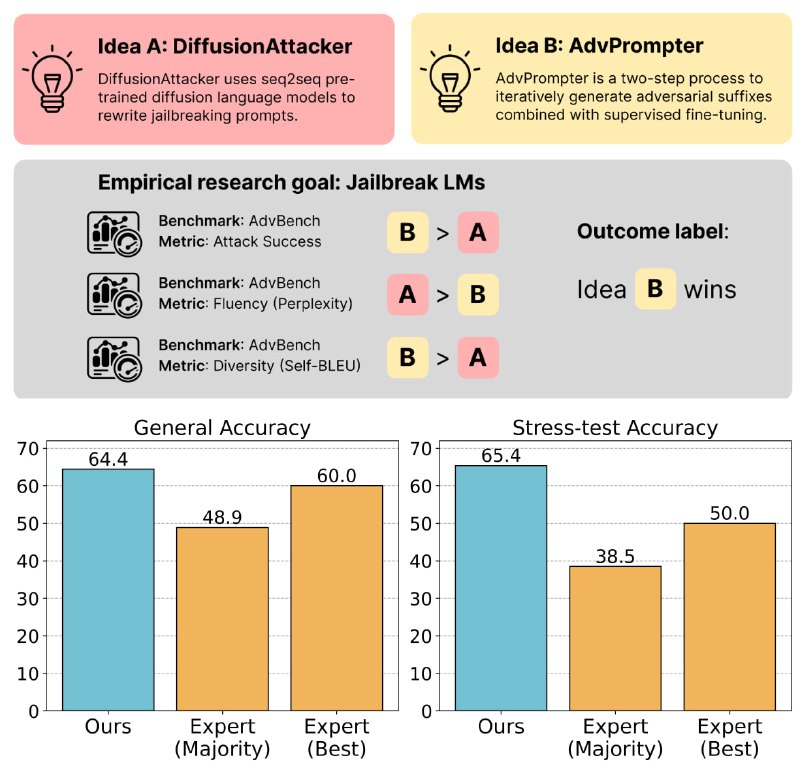
Predicting Empirical AI Research Outcomes with Language ModelsЭтому я прямых аналогов не знаю, но это направление возможного ответа на гипотезу о том, что LLM не смогут сами планировать исследования, им всегда нужен будет человек во главе, они просто будут ускорять работу учёного в качестве "лаборантов". Оказывается, LLM-based модель (пока ещё не прямо o3, надо ещё что-то сделать) может предсказывать результаты ML-экспериментов лучше, чем люди-эксперты (на рис. 3 пример запроса и результаты). Особенно если людям пустить немножко пыли в глаза: stress-test accuracy на рис. 3 — это результаты в случаях, когда менее успешный на практике подход имеет более интересное математическое обоснование и тем самым для людей выглядит более красивой идеей. То есть в каком-то смысле это о том, что уже сейчас у AI-моделей очень даже неплохой research taste — и хотя пока мы говорим о результатах вроде 64% верных предсказаний с двумя исходами, это уже лучше, чем у людей с теми же вводными.
В общем, дивный новый мир продолжает расцветать, буду держать вас в курсе!