TGViewer
Channel Public Channel
SQL и Анализ данных

SQL и Анализ данных

@databases_tg

Базы данных и всё, что с ними связано!

Сотрудничество: @haarrp

РКН № 6766085482
Subscribers
12.4K
Photos
752
Videos
91
Links
765

Showing posts older than #742 · Back to latest

Older Posts 20 shown
Post #741 3.49K
➡️ SQL Community | #memes
  • 😁 77
  • 🤯 10
  • 😭 6
  • ❤ 3
  • 😱 3
  • 🔥 1
Post #739 3.61K
💻 Шпаргалка по MySQL

Этот репозиторий представляет собой лаконичную и удобную шпаргалку по основным SQL-командам для работы с MySQL.

В ней собран синтаксис для создания и управления базами данных, выполнения запросов и работы с индексами.

⛓ Ссылка на GitHub

tags: #полезное #mysql

➡ SQL Community | Чат
  • 👍 3
  • 🔥 1
Post #738 3.44K
  • 😁 18
  • 👍 5
  • ❤ 2
Post #736 3.97K
Ох уж эти питонисты

➡ SQL Community | #memes
  • 😁 34
  • 👍 5
  • ❤ 3
  • 👾 2
Post #735 3.72K
💻 Что нужно знать, чтобы писать быстрые SQL-запросы?

Неоптимальные SQL-запросы могут замедлить работу базы данных, даже если данных немного.

Использование индексов, правильная структура запросов и понимание порядка выполнения операций позволяют значительно ускорить обработку данных.

Автор разбирает ключевые принципы оптимизации и показывает, как писать эффективные SQL-запросы.

⛓ Читать статью

tags: #статья

➡ SQL Community | Чат
  • 👍 4
  • 🔥 4
  • ❤ 1
Post #734 3.3K
❔ Вопрос с собеседования

Чем отличается VARCHAR от NVARCHAR?

Ответ: NVARCHAR хранит данные в формате Unicode — каждый символ занимает 2 байта, что позволяет хранить текст на любом языке. Используется в Microsoft SQL Server, Oracle (NVARCHAR2) и частично поддерживается в MySQL и SQLite.

VARCHAR хранит данные в ASCII или заданной кодировке — каждый символ занимает 1 байт. Поддерживается практически во всех СУБД.


tags: #собеседование

➡ SQL Community | Чат
  • 🔥 13
  • 👍 7
  • ❤ 3
Post #732 3.61K
💻 Индексы в убывающем порядке и NULLS FIRST

Правильная индексация — ключ к быстрой работе базы данных, но даже мелкие нюансы вроде порядка сортировки могут заметно повлиять на производительность.

В статье разбирается, как использование ASC/DESC и параметра NULLS FIRST влияет на скорость запросов и размер индексов в PostgreSQL.
⛓ Читать статью

tags: #статья

➡ SQL Community | Чат
  • ❤ 7
  • 🔥 2
Post #731 3.33K
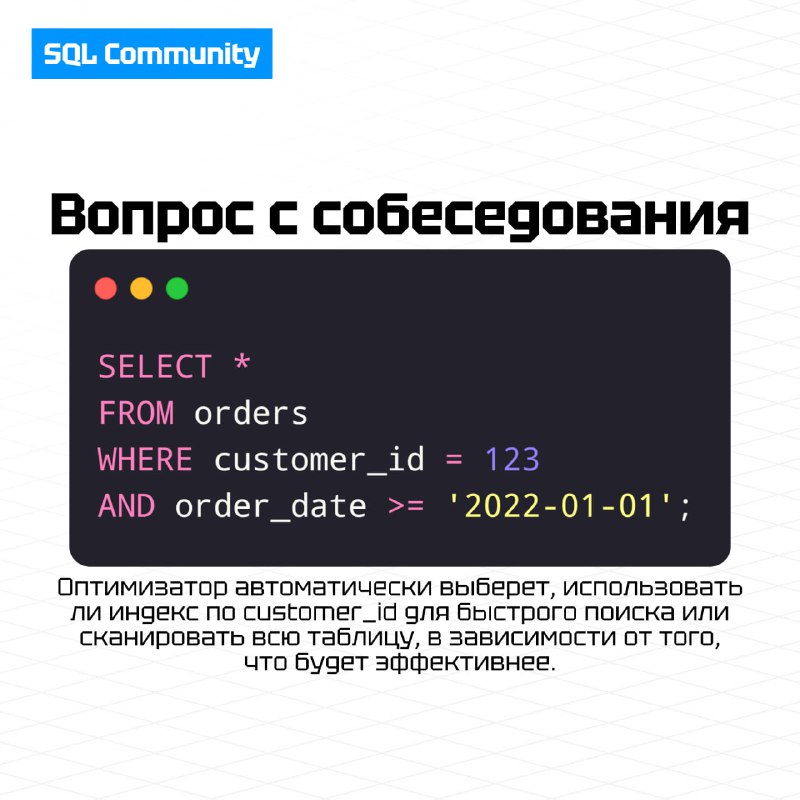
❔ Вопрос с собеседования

Что такое оптимизатор SQL-запросов и как он работает?

Ответ: Оптимизатор SQL-запросов — это компонент СУБД, который автоматически генерирует наиболее эффективный план выполнения для запроса. Он анализирует запрос, использует статистику по таблицам и индексы, чтобы минимизировать затраты на доступ к данным и их обработку. Оптимизатор оценивает несколько стратегий выполнения запроса и выбирает ту, которая требует наименьшего количества ресурсов, таких как диск, процессор и память.

tags: #собеседование

➡ SQL Community | Чат
  • 👍 18
  • 🔥 8
  • ❤ 4
Post #730 3.44K
Это база

➡ SQL Community | #memes
  • 💯 46
  • 😁 19
  • 👍 4
  • ❤‍🔥 1
Post #729 3.63K
💻 800+ вопросов и ответов по SQL Server для собеседований

Этот репозиторий содержит подборку из более чем 800 вопросов и ответов, которые помогут подготовиться к техническим собеседованиям по SQL Server.

Здесь разобраны ключевые темы, включая запросы, оптимизацию, индексы, транзакции и хранимые процедуры, что делает его отличным ресурсом как для начинающих, так и для специалистов.

⛓ Ссылка на GitHub

tags: #полезное

➡ SQL Community | Чат
  • 👍 12
  • ❤ 4
Post #728 3.48K
  • 👍 13
  • 🥱 7
  • ❤ 3
  • ⚡ 2
Post #726 3.86K
А джунам остаётся только закинуть этот промпт в ChatGPT 😆

➡ SQL Community | #memes
  • 🔥 29
  • 😁 22
Post #724 3.38K
💻 Как превратить PostgreSQL в мощный поисковый движок?

Обычно для реализации поиска в приложениях используют специализированные решения, но PostgreSQL может справиться с этой задачей не хуже.

В статье автор объясняет, как использовать tsvector для полнотекстового поиска, pgvector для семантического поиска и pg_trgm для нечеткого соответствия.

Что вы узнаете из статьи:
▶️ Как реализовать полнотекстовый поиск в PostgreSQL?

▶️ Как применять векторный поиск для семантического анализа?

▶️ Как улучшить точность поиска с помощью триграмм?

▶️ Как объединить все три метода для мощного поиска в базе данных?


Автор делится практическими примерами, показывая, как PostgreSQL можно использовать не только как хранилище данных, но и как полноценный поисковый инструмент.

⛓ Читать статью

tags: #статья

➡ SQL Community | Чат
  • ❤ 4
  • 👍 1
  • 🔥 1
Post #723 3.46K
❔ Вопрос с собеседования

Почему хранимые процедуры могут быть медленнее, чем обычные SQL-запросы?

Ответ:

▶ Кэширование планов запросов внутри процедуры может привести к неоптимальному плану выполнения

▶ Ограниченные возможности индексации внутри процедуры могут сделать сложные выборки медленными

▶ Плохая масштабируемость — если хранимые процедуры выполняют много логики, нагрузка ложится на сервер БД, а не на приложение

▶ Обновление хранимой процедуры требует перезапуска сессий, в отличие от динамического SQL

tags: #собеседование

➡ SQL Community | Чат
  • 👍 13
  • 🔥 2
  • 💊 1
Post #722 3.44K
Ну тут без комментариев 🙃

➡ SQL Community | #memes
  • 😁 58
  • 🔥 6
  • ❤ 4
  • 👍 4
Post #720 3.41K
💻 Семь фаз вакуумирования в PostgreSQL

Чтобы база данных PostgreSQL оставалась эффективной, ей нужно регулярно очищать ненужные версии строк. Этот процесс называется вакуумированием, и в 17-й версии PostgreSQL он получил важные изменения.

В статье подробно разбираются все семь фаз вакуумирования, их влияние на производительность и сравнение работы алгоритма в новых и старых версиях PostgreSQL.

Что вы узнаете из статьи:
▶️ Как именно работает вакуумирование в PostgreSQL?

▶️ Какие этапы проходят данные во время очистки?

▶️ Как изменился алгоритм в версии 17?

▶️ Влияет ли число сканирований индексов на производительность?


Автор объясняет, как PostgreSQL управляет свободным местом в таблицах и что делать, чтобы база работала быстрее.

⛓ Читать статью

tags: #статья

➡ SQL Community | Чат
  • 👍 5
  • ❤ 2
Post #719 3.27K
❔ Вопрос с собеседования

Изменится ли результат запроса, если в LEFT JOIN поменять таблицы местами?

Ответ: Да, результат запроса изменится кардинально. LEFT JOIN выбирает все строки из "левой" таблицы, дополняя их данными из "правой". Если поменять таблицы местами, логика изменится: "правая" станет "левой", а "левая" — "правой". Это влияет на то, какие строки и как будут включены в результат.

tags: #собеседование

➡ SQL Community | Чат
  • 👍 22
  • ❤ 7
  • 🔥 4
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →