TGViewer
Channel Public Channel
SQL и Анализ данных

SQL и Анализ данных

@databases_tg

Базы данных и всё, что с ними связано!

Сотрудничество: @haarrp

РКН № 6766085482
Subscribers
12.4K
Photos
754
Videos
91
Links
767

Showing posts older than #282 · Back to latest
Older Posts 19 shown
Post #279 3.76K
➡️ SQL Community | #memes
  • ❤‍🔥 27
  • 😁 12
  • 🔥 2
  • 🏆 2
  • 👍 1
Post #278 3.71K
💻 SQL injection: почему, зачем и как защититься

В этом видео подробно рассказано про опасную хакерскую атаку - SQL Injection. Это одна из старейших атак, до сих пор не потерявшая свою актуальность.

Автор разбирает использование SQL Injection на примере небольшого C# приложения, но в других языках программирования и фреймворках всё работает идентично.

📱 Смотреть на YouTube

➡️ SQL Community | #полезное
  • 👍 11
  • ❤ 2
Post #267 3.27K
  • 👍 6
  • ❤ 1
Post #259 3.45K
💻 Что такое партиционирование?

Партиционирование — это метод разделения больших таблиц в базе данных на более мелкие, управляемые части, называемые партициями.

Каждая партиция хранится в той же базе данных и управляется системой управления базами данных (СУБД), что позволяет оптимизировать выполнение запросов и упростить управление данными.

Предположим, у нас есть таблица orders с миллионами записей. Чтобы ускорить доступ к данным, её можно разделить на партиции по году:

▶️ orders_2023 — заказы за 2023 год
▶️ orders_2024 — заказы за 2024 год

С помощью партиционирования запросы, обращающиеся только к конкретному периоду, будут работать быстрее, так как обрабатывается только соответствующая партиция.

📌 При настройке партиционирования важно выбрать подходящий критерий разделения, например, по дате или диапазону значений, чтобы максимально ускорить ключевые запросы.


❤️ — если было полезно
🤓 — если уже знал

➡️ SQL Community | #обучение
  • ❤ 46
  • 🤓 15
  • 👍 12
Post #257 3.29K
❔ Вопрос с собеседования

Как оператор GROUP BY обрабатывает поля с NULL?

Ответ: Учитывая, что NULL в SQL — просто отсутствие значения, то все значения NULL при группировке попадают в одну группу.

➡️ SQL Community | #собеседование
  • ❤ 16
  • 👍 10
  • 🔥 4
Post #253 3.85K
💻 Асинхронный SQLAlchemy 2: пошаговый гайд по управлению сессиями, добавлению и извлечению данных с Pydantic

В статье рассматривается использование асинхронной версии SQLAlchemy 2.0 для управления сессиями, добавления и извлечения данных с помощью Pydantic.

Автор подробно описывает создание асинхронных сессий, методы добавления записей в базу данных и извлечения данных с применением фильтров и преобразования объектов SQLAlchemy в словари Python.

⛓ Читать статью

➡️ SQL Community | #статья
  • 👍 5
  • ❤ 2
Post #251 3.64K
  • ❤ 13
  • 👍 9
Post #250 3.66K
  • ❤ 6
Post #247 4.55K
💻 Полезная шпаргалка по основам SQL

Эта шпаргалка по SQL кратко описывает основные категории, команды, операторы, функции агрегирования, виды соединений и примеры запросов для эффективной работы с базами данных.

➡️ SQL Community | #полезное
  • 🔥 35
  • ❤ 3
Post #236 3.27K
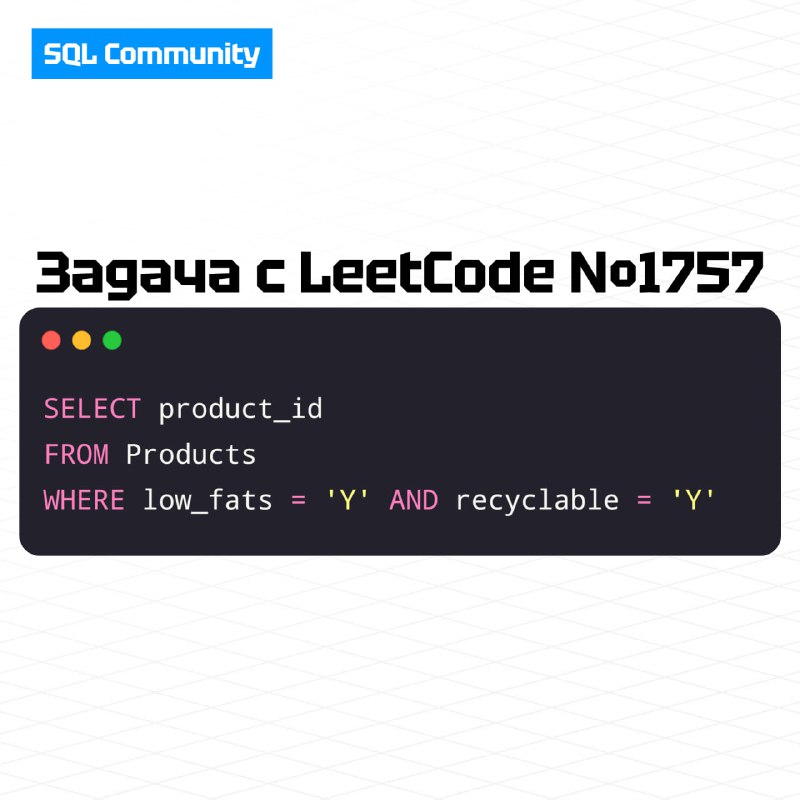
❔ Задача с LeetCode «Recyclable and Low Fat Products №1757»

Напишите решение для поиска идентификаторов продуктов с низким содержанием жира, пригодных для вторичной переработки.

Верните таблицу результатов в любом порядке.

Формат результатов приведен в следующем примере.

Входные данные:

+------------+----------+------------+
| product_id | low_fats | recyclable |
+------------+----------+------------+
| 0 | Y | N |
| 1 | Y | Y |
| 2 | N | Y |
| 3 | Y | Y |
| 4 | N | N |
+------------+----------+------------+


Вывод:
+------------+
| product_id |
+------------+
| 1 |
| 3 |
+------------+


Пояснение: Только продукты 1 и 3 содержат мало жира и пригодны для вторичной переработки.

➡️ SQL Community | #задача #easy
  • 👍 19
  • 😁 11
  • ❤ 5
Post #233 3.61K
💻 Что такое шардирование?

Шардирование — это метод горизонтального разделения данных в базе данных, при котором большие таблицы разбиваются на более мелкие, называемые шардами.

Каждый шард хранится на отдельном сервере или узле кластера, что позволяет распределить нагрузку и повысить производительность системы.

Предположим, у нас есть таблица users с миллионами записей. Чтобы улучшить производительность, можно разделить её на несколько шардов по географическому признаку:

▶️ users_east — пользователи из восточного региона

▶️ users_west — пользователи из западного региона

Каждая из этих таблиц будет храниться на отдельном сервере, что позволит параллельно обрабатывать запросы и снизить нагрузку на систему.

📌 Важно учитывать, что шардирование добавляет сложность в управление базой данных, так как требует продуманной стратегии разделения данных и обеспечения целостности между шардированными таблицами.


❤️ — если было полезно
🤓 — если уже знал

➡️ SQL Community | #обучение
  • ❤ 73
  • 🤓 11
  • 👍 5
  • 💯 1
Post #231 3.55K
❔ Вопрос с собеседования

Как работает SQL-триггер?

Ответ: Когда происходит событие, СУБД автоматически вызывает триггер, который затем выполняет набор операторов SQL, определенных в триггере. Триггеры определяются для каждой таблицы и создаются с помощью оператора CREATE TRIGGER. Они могут запускаться до или после наступления события и выполняться один раз для каждой затронутой строки либо один раз для каждого оператора.

➡️ SQL Community | #собеседование
  • 👍 16
  • ❤ 5
Post #227 3.52K
💻 Быстрее пули: как найти счастье с PostgreSQL

Полнотекстовый поиск — мощный инструмент, который может значительно улучшить ваши приложения. Но как сделать его максимально быстрым и эффективным?

В статье автор делится, как применять встроенные средства базы данных для работы с текстовой информацией, включая индексы, специальные типы данных и подходы к ранжированию результатов.

⛓ Читать статью

➡️ SQL Community | #статья
  • 👍 7
  • ❤ 1
  • 🔥 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →