TGViewer
Channel Public Channel
SQL и Анализ данных

SQL и Анализ данных

@databases_tg

Базы данных и всё, что с ними связано!

Сотрудничество: @haarrp

РКН № 6766085482
Subscribers
12.5K
Photos
750
Videos
90
Links
763

Showing posts older than #1391 · Back to latest

Older Posts 18 shown
Post #1390 1.95K

Forwarded from Machinelearning

✔️ Anthropic переработала команду code-review в Claude Code

Команда получила уровни Low, Medium, High, X-high и Ultra.

И это не один и тот же промпт с разным временем на ризонинг - на каждом уровне процесс построен по-своему.


Уровень подхватывается из настроек сессии автоматически, но его можно задать руками командой /code-review high.

🟢Low делает один быстрый проход по диффу.

🟢Medium читает изменённый код в контексте проекта, прогоняет несколько поисковых проходов под разными углами и перепроверяет находки перед выдачей.

🟢High выносит поиск и верификацию в субагентов с чистым контекстом, чтобы проверяющие не были заякорены на рассуждениях агента, который этот код только что писал.

🟢X-high дополнительно ищет, как изменения влияют на код за пределами самого диффа.

🟠Ultra - верхняя ступень, где ревью выполняется в облачной песочнице, куда Claude Code выгружает состояние репозитория или клонирует PR с GitHub. Там запускается целый парк агентов, и каждая находка независимо воспроизводится и верифицируется.

Ultra находится в статусе research preview и оплачивается отдельно от подписки - Pro и Max подписчикам дают 3 бесплатных запуска, дальше каждый прогон списывается из кредитов на дополнительное использование стоит примерно от 5 до 20 долларов в зависимости от размера изменений.

Качество новой системы подкрепляют замерами Opus 4.8 на открытом датасете с ручной разметкой ошибок. Уровень Low нашёл 17% размеченных багов, Medium - 22%, High - 24%, X-high - 25%.

У "конкурента" (компания его не называет) - те же уровни дали от 8 до 12%.

Anthropic утверждает, что использует Ultra-режим на каждом пулл-реквесте в собственной разработке.


@ai_machinelearning_big_data

#news #ai #ml
  • ❤ 4
  • 🔥 2
  • 👍 1
Post #1389 2.14K
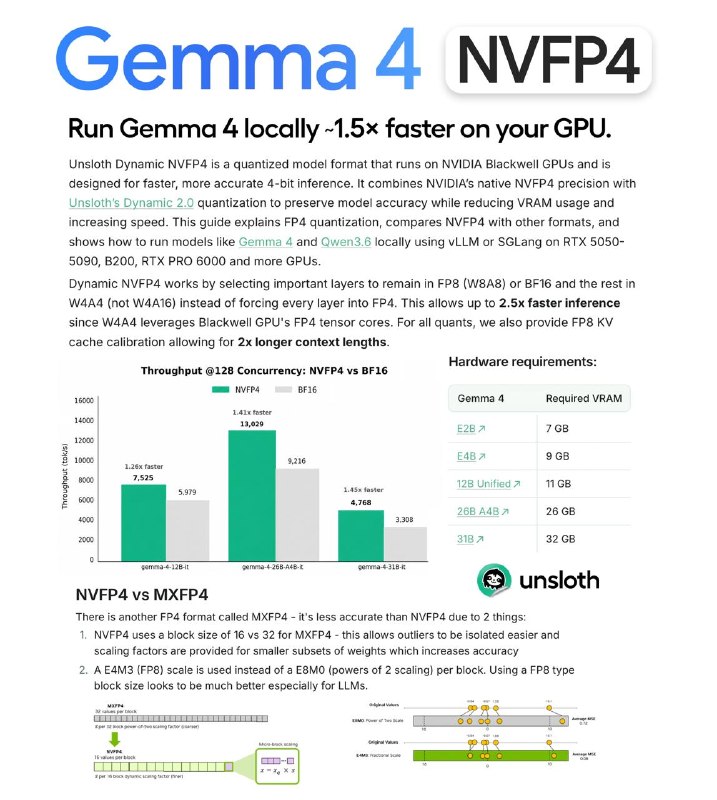
Unsloth выкатили Gemma 4 NVFP4 quants.

Заявка простая: быстрее 4-bit inference на Blackwell GPU без обычного компромисса “сжали, но стало заметно тупее”.

Главные цифры:

* Gemma-4-12B NVFP4 запускается на 11 GB VRAM
* Gemma-4-26B-A4B доходит до 13K tok/s на B200
* NVFP4 даёт до 1.5× ускорения на GPU

NVFP4 - это не просто “ещё один 4-bit формат”. Он заточен под Blackwell и позволяет делать inference быстрее, сохраняя точность лучше, чем грубая квантизация.

Для локального и self-hosted inference это важный сдвиг: больше моделей помещается в память, throughput растёт, стоимость токена падает.

Особенно полезно для тех, кто гоняет много коротких запросов, агентные пайплайны или batch-инференс, где скорость и VRAM решают всё.

Blog: https://unsloth.ai/docs/basics/nvfp4
Gemma NVFP4: https://huggingface.co/collections/unsloth/nvfp4
  • ❤ 3
  • 👍 1
  • 🔥 1
  • 😁 1
  • 🤨 1
Post #1388 2.44K
SQL-задача с подвохом посложнее

Нужно найти пользователей, у которых последний заказ был оплачен.

Есть таблица:


orders
id | user_id | status | created_at
1 | 10 | paid | 2026-01-01
2 | 10 | cancelled | 2026-01-05
3 | 20 | paid | 2026-01-03
4 | 30 | failed | 2026-01-02


Кто-то пишет так:


WITH ranked AS (
SELECT *,
ROW_NUMBER() OVER (
PARTITION BY user_id
ORDER BY created_at DESC
) AS rn
FROM orders
WHERE status = 'paid'
)
SELECT *
FROM ranked
WHERE rn = 1;


На вид логично. Но запрос неверный.

Подвох: фильтр WHERE status = 'paid' срабатывает до ROW_NUMBER().

То есть SQL сначала выбрасывает все неоплаченные заказы, а потом ищет последний среди оставшихся оплаченных.

Пользователь 10 попадёт в результат, хотя его реальный последний заказ — cancelled.

Правильно так:


WITH ranked AS (
SELECT *,
ROW_NUMBER() OVER (
PARTITION BY user_id
ORDER BY created_at DESC, id DESC
) AS rn
FROM orders
)
SELECT *
FROM ranked
WHERE rn = 1
AND status = 'paid';


Сначала находим последний заказ вообще, и только потом проверяем его статус.

Вот почему порядок фильтрации в SQL может полностью менять смысл запроса.
  • 👍 11
  • ❤ 1
  • 💯 1
Post #1387 2.46K
Algebra, Topology, Differential Calculus, and Optimization Theory For Computer Science and Machine Learning

Недавно был обновлен огромный PDF-учебник по математике на 2204 страницы:

Внутри - алгебра, топология, дифференциальное исчисление и теория оптимизации для Computer Science и Machine Learning.

Найти можно здесь:

https://cis.upenn.edu/~jean/gbooks/geomath.html
  • ❤ 3
  • 👍 2
  • 🔥 1
Post #1384 2.86K

Forwarded from Machinelearning

🌟 TabFM: модель для работы с табличными данными от Google

Google Research опубликовала модель машинного обучения для классификации и регрессии на табличных данных. TabFM делает прогнозы на ранее не встречавшихся таблицах без отдельной тренировки под каждый набор данных.

Табличные данные лежат в основе множества прикладных задач - от прогноза оттока клиентов до выявления финансового мошенничества. Десятилетиями здесь доминировали алгоритмы на основе деревьев решений, которые требуют долгого подбора параметров и выстраивания признаков под каждую новую задачу.


TabFM использует подход, заимствованный у LLM - обучение в контексте.

Модель получает всю таблицу целиком как единый запрос и определяет связи между столбцами и строками прямо в момент прогноза, не меняя своих внутренних параметров. Эту архитектуру Гугл описывает как гибрид двух ранее опубликованных решений TabPFN и TabICL.

TabFM обучалась на сотнях миллионов сгенерированных таблиц, построенных с помощью структурных причинных моделей.

Разработку проверили на бенчмарке TabArena, который ранжирует системы по итогам прямых сравнений между собой. Тестирование включало 38 наборов для классификации и 13 для регрессии, размером от 700 до 150 000 строк.

По результатам TabFM обошла тщательно настроенные отраслевые решения TabPFN-3, AutoGluon и RealMLP.

В ближайшие недели TabFM будет встроена в сервис Google BigQuery, там классификацию и регрессию можно будет запускать одной SQL-командой, без специальных знаний в области ML.


📌Лицензирование: Tabfm Non-commercial


🟡Блогпост
🟡Модель
🖥GitHub


@ai_machinelearning_big_data

#AI #ML #TabFM #Google
  • 🤔 1
Post #1383 1.99K
`O_DIRECT`: когда база данных обходит page cache

В Linux флаг O_DIRECT позволяет читать и писать файл почти напрямую, минуя page cache ядра.

Зачем это нужно базам данных?

У PostgreSQL, MySQL, RocksDB и других систем часто уже есть свой buffer pool.
Если ещё и ядро будет кэшировать те же страницы, получится двойное кэширование и лишняя трата памяти.

Но у O_DIRECT есть неприятное условие: всё должно быть выровнено по блоку.

• buffer
• file offset
• размер чтения / записи

Например, под 4 KB блоки нельзя просто так прочитать 123 байта в любой `malloc`-буфер.
Промахнулся с alignment — read() вернёт EINVAL.

Именно поэтому низкоуровневый I/O в базах выглядит таким странным: там важны не только данные, но и то, как они лежат в памяти.
  • ❤ 5
  • 👍 3
  • 🔥 1
  • 🤔 1
  • 💯 1
Post #1381 2.57K
Мы годами строили предсказуемые монолиты и микросервисы, но AI превратил PDLC в Дикий Запад, где старые паттерны проектирования больше не работают. Хватит делать вид, что ты контролируешь ситуацию, просто прикрываясь новой версией TOGAF.

Приходи 1 июля на Arch.Meetup, где мы поговорим про архитектурный подход AI disrupt PDLC, и вместе со спикерами из Сбера, Вебпрактик и Газпром нефти будем учиться управлять этим хаосом, пока нейросети не начали проектировать системы вместо нас.

🔗Выбирай удобный формат и регистрируйся по ссылке
 
📍Встречаемся очно на Кутузовском 32, а ссылку для онлайн пришлем накануне.
  • 👍 1
  • 🤔 1
Post #1380 2.29K

Forwarded from Data Science. SQL hub

SQL-инъекция за 40 секунд: Лайт против L

Разбираем SQL-инъекцию на пальцах в формате Лайт против L. Что это такое, как обычная строка ввода меняет логику запроса, к чему это приводит и какими способами реально закрыть дыру. Коротко, по делу и так, чтобы запомнилось.

Больше таких видео: https://www.youtube.com/shorts/c4gBi094jkU

@sqlhub
  • 🔥 4
  • ❤ 1
  • 👍 1
  • 💯 1
Post #1379 2.37K
  • 👍 6
  • 😁 2
Post #1377 2.36K
Вы можете выучить SQL по «Тетради смерти»

О времена, о нравы)
  • 🤩 7
  • ❤ 2
  • 😁 2
  • 👏 1
  • 👻 1
Post #1376 2.05K

Forwarded from Machinelearning

🌟 MolmoMotion: модель прогнозирования движения объектов в трёхмерном пространстве

Институт Аллена (Ai2) выпустил MolmoMotion - модель, которая предсказывает, как отмеченный в кадре объект будет двигаться в ближайшие секунды.

На вход подаётся кадр или короткая видеоистория, на видимом в сцене предмете отмечаются опорные точки, и добавляется текстовая инструкция (например, "подвинь и поверни деревянную миску с фруктами").

На выходе модель строит траекторию этих точек в трёхмерном пространстве, в метрах относительно камеры.

Под капотом - модель Molmo 2 на 4 млрд параметров. Институт обучил 2 версии:

🟢Авторегрессионный вариант, который достраивает траекторию по шагам;

🟠Версию на основе flow-matching для случаев, когда у действия есть несколько вероятных продолжений.

🟡В открытый релиз вошли только 2 AR-чекпойнта

🟢H3-F30 для типичного видео: 3 кадра истории и прогноз примерно на 2 секунды при 15 FPS;
🟢H1-F32 - когда доступен лишь один кадр.

🟡Помимо моделей опубликованы датасет и бенчмарк

MolmoMotion-1M - набор из 1,16 млн видео, который охватывает 736 типов движения и около 5,6 тыс. объектов.

PointMotionBench состоит из 2,7 тыс. размеченных людьми видеоклипов из сетов DAVIS, HOT3D и WorldTrack.

По замерам Ai2, на этом бенче MolmoMotion точнее всех методов, с которыми его сравнивали, включая генераторы видео и более простые базовые модели.


В симуляции система управления на базе MolmoMotion успешно выполняла 76,3% операций "взять и переставить" против 56,0% у аналога на Molmo 2, а при генерации видео модель улучшила движение по всем пяти измеряемым показателям.


Среди ограничений авторы называют использование лишь 8 точек на объект при обучении. Этого достаточно для общей траектории, но мало для точного описания сложных деформаций.


📌Лицензирование: Apache 2.0 License


🟡Блогпост
🟡Релиз на HuggingFace
🟡Техотчёт
🖥Github


@ai_machinelearning_big_data

#AI #ML # #MolmoMotion #Ai2
  • 👍 1
Post #1365 2.13K
Тест прошёл. А PostgreSQL вообще в курсе?

Интеграционные тесты часто выглядят надёжно ровно до того момента, пока приложение не встречается с настоящей базой.

На локалке всё зелёное. В CI всё зелёное. Моки довольны. In-memory база тоже не против. А потом в проде внезапно выясняется, что реальный PostgreSQL иначе обрабатывает запрос, constraint не даёт сохранить данные, транзакция ведёт себя не так, как ожидалось, а Redis показывает проблему, которую тесты вообще не могли поймать.

Именно поэтому Testcontainers в .NET так хорошо заходят для интеграционных тестов. Вместо имитации базы вы поднимаете настоящий PostgreSQL, Redis или другой сервис в Docker-контейнере, прогоняете приложение против реальной зависимости и удаляете контейнер после тестов.

Это даёт намного больше уверенности, чем тесты против подмены. При этом не нужен общий тестовый сервер, который кто-то сломал, не почистил или настроил иначе.

В хорошей схеме контейнеры запускаются через fixture, приложение получает connection string динамически, версии образов фиксируются, а настройка прячется за небольшими helper-классами. Сам тест при этом остаётся читаемым: он проверяет бизнес-сценарий, а не превращается в простыню из настройки базы и очистки состояния.

Есть важный нюанс. Общие fixtures ускоряют тесты, но требуют дисциплины со shared state. Когда изоляция важнее скорости, лучше использовать отдельные fixtures и не ловить фантомные падения из-за данных, оставшихся от соседнего теста.

Мне нравится этот подход именно за баланс. Вы тестируете не идеальную игрушечную модель приложения, а поведение, максимально близкое к реальному окружению. Но без боли ручной инфраструктуры.

Поэтому в следующий раз, когда интеграционный тест прошёл против in-memory базы, стоит задать неприятный вопрос: а настоящая база с ним согласится?
  • ❤ 3
  • 👍 2
  • 🔥 1
  • 🤔 1
Post #1364 2.43K
Классика
  • 😁 62
  • 🔥 1
  • 🙏 1
Post #1363 2.7K
Одна маленькая звёздочка в SQL может незаметно просадить весь backend.

На первый взгляд всё логично: зачем перечислять поля, если можно забрать из таблицы сразу всё? На тестах быстро, в разработке удобно, проблем не видно.

Но потом в таблицу добавляют тяжёлый JSON, аватар, длинный текст или служебные данные. И старый код внезапно начинает таскать лишние мегабайты на каждый запрос.

Дальше всё сыпется по цепочке: растёт трафик, запросы тормозят, память уходит быстрее, кэш работает хуже, а любое изменение схемы становится рискованнее.

Поэтому в продакшене лучше выбирать только те поля, которые реально нужны приложению.

Звёздочка удобна для быстрой проверки. Но в рабочем коде это та самая лень, которая потом больно бьёт по продакшену.

#sql #backend #database #postgresql #mysql #разработка #программирование #devtips #webdev
  • 👍 7
  • ❤ 3
  • 🤔 1
Post #1362 2.43K
Сегодня вместо опроса настоящий хакатон: Ozon Tech запустил Робозон с задачами по автоматизации складов и призовым фондом 15 000 000 рублей.

Три трека:
— имитационное моделирование сортировочного центра;
— инженерные решения для автоматизированной сортировки;
— системы компьютерного зрения для классификации товаров.

Всё на реальных данных, и решать можно онлайн. Команду можно собрать свою или вписаться в существующую на платформе хакатона. И до 6 сентября есть время предложить решение.

Тех, кто пройдёт в финал, организаторы привезут на E-CODE. На конференции пройдёт и защита, и награждение. Проезд и проживание за счёт компании.

Регистрация до 11 июля.
Задачи уже выложены на сайте
  • 🔥 3
  • 😁 1
Post #1361 2.31K
⚡️ Ling & Ring 2.6: новый техрепорт и open-weight модели

Ant Ling выпустили технический отчёт по Ling & Ring 2.6 и открыли два base checkpoint.

Главное:

* 7:1 Hybrid Linear Attention: 7 Lightning Attention слоёв + 1 MLA слой, чтобы сделать 256K context практичнее
* KPop RL: адаптивный Binary KL вместо uniform KL, прирост SWE-bench Verified с 70.8% до 76.28%
* ~4× token efficiency: больше “интеллекта” на меньшее число output-токенов
* Ling-2.6-flash: 104B, быстрый inference
* Ling-2.6-1T: trillion-scale flagship
* Ring-2.6-1T: deep reasoning и long-horizon agentic задачи

Суть релиза: команда оптимизирует не только модель, а всю связку architecture + training + agentic capability.

Открыты:

* Ling-2.6-1T-base
* Ling-2.6-flash-base
* код и inference-стек

📑 Full technical report: http://arxiv.org/abs/2606.15079
🧱 Ling-2.6-1T-base:
http://huggingface.co/inclusionAI/Ling-2.6-1T-base
🧱 Ring-2.6-flash-base:
http://huggingface.co/inclusionAI/Ling-2.6-flash-base
💻 Code:
http://github.com/inclusionAI/Ling-V2.5
⚙️ Inference:
http://github.com/inclusionAI/linghe
  • ❤ 2
  • 👍 1
  • 🔥 1
Post #1360 2.32K

Forwarded from Анализ данных (Data analysis)

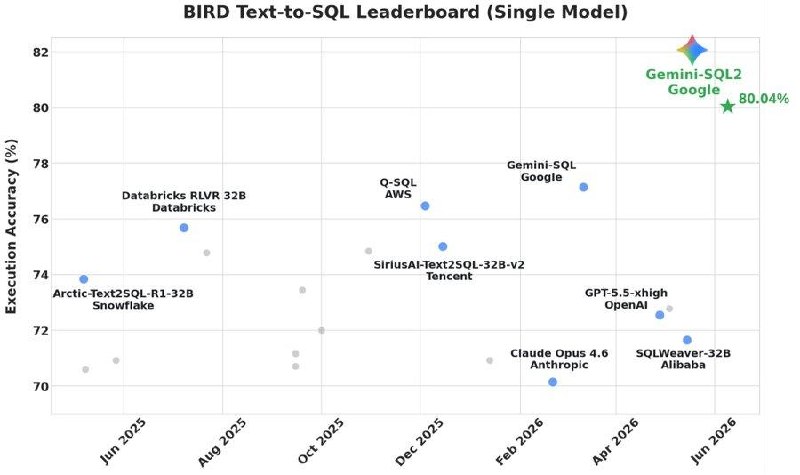
Google Research представила Gemini-SQL2 - новую систему text-to-SQL на базе Gemini 3.1 Pro.

Она превращает вопросы на обычном языке в исполняемые SQL-запросы, позволяя получать данные из баз без ручного написания кода.

На бенчмарке BIRD система показала state-of-the-art результат - 80,04% execution accuracy.

BIRD реально запускает запрос и проверяет, возвращает ли он правильный результат.

https://x.com/GoogleResearch/status/2065475343205740911

@data_analysis_ml
  • ❤ 8
  • 👍 6
  • 🔥 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →