TGViewer
Channel Public Channel
Базы данных (Data Base)

Базы данных (Data Base)

@database_info

Базы данных (Data Base). По всем вопросам @evgenycarter
Subscribers
8.05K
Photos
669
Videos
479
Links
688

Showing posts older than #1245 · Back to latest

Older Posts 11 shown
Post #1243 1.7K
SQL. Решаем ТЕСТОВЫЕ ЗАДАНИЯ из AMAZON и FACEBOOK (подробный разбор)

00:00 - Где искать задачи с собеседований IT-компаний?
00:53 - Решаем задачу из Amazon
09:36 - Решаем задачу из Facebook
20:44 - Задача со звездочкой из моей работы. Пишите ваши решения в комментарии!

источник

#db

👉 @database_info
  • 👍 4
Post #1242 1.84K
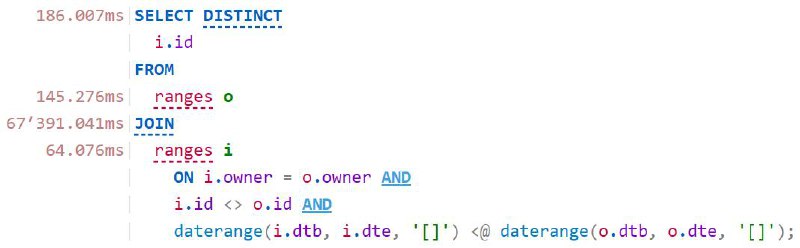
PostgreSQL Antipatterns: устраняем вложенные интервалы

Недавно попался на глаза примерно вот такой запрос, которым хотели отобрать в таблице (очевидно, для последующего удаления) все id записей интервалов, которые полностью перекрыты каким-то другим интервалом того же owner'а:

https://habr.com/ru/companies/tensor/articles/847128/

#db

👉 @database_info
  • 👍 5
Post #1241 1.98K
Функция STUFF() в SQL

Функция STUFF() в SQL используется для замены части строки другой строкой, начиная с определенной позиции и на заданную длину.

Синтаксис функции:


STUFF (string_expression, start, length, replace_with_expression)


- `string_expression` — это исходная строка, в которую вносится изменение.
- `start` — позиция, с которой начинается замена.
- `length` — количество символов, которые будут удалены из строки.
- `replace_with_expression` — строка, которая будет вставлена на место удаленных символов.

Пример использования:


SELECT STUFF('Hello World', 7, 5, 'SQL');


В этом примере функция заменяет часть строки "World" начиная с 7-й позиции и длиной в 5 символов на строку "SQL". Результат:


Hello SQL


Таким образом, STUFF() позволяет удобно заменять часть строки другой строкой на основе указанных параметров.

#db

👉 @database_info
  • 👍 8
  • ❤ 3
Post #1240 1.85K
Компания Uber создала собственную базу данных с нуля. Она получила название Schemaless DB.
В ее рамках они хотели добиться высокой доступности операций записи.

Uber сделала это возможным благодаря использованию умной и простой техники под названием Buffered Writes.
В двух словах, Buffered Writes означает, что каждый запрос на запись хранится как минимум на двух узлах - Primary Leader и Secondary Leader.

Вот как это работает:

✅ Клиент делает запрос в обработчик запросов.

✅ Обработчик запросов отправляет запросы на запись на Secondary Leader. Данные сохраняются в специальной буферной таблице на Secondary Leader.

Затем он также отправляет запрос на запись на Primary Leader. Только если обе записи прошли успешно, клиент получает подтверждение успешной записи.

✅ Задача Primary Leader заключается в репликации данных.

Но если leader выходит из строя до успешной асинхронной репликации, Secondary Leader служит временной резервной копией данных.

✅ Background Worker следит за Primary Follower, чтобы узнать, когда появится запись после репликации

✅ Как только запись появляется на Primary Follower, Background Worker удаляет запись из Buffer Table.

Здесь следует отметить несколько важных моментов:

- Количество вторичных лидеров настраивается

- Secondary leader выбирается случайным образом

- Буферизованные записи используют идемпотентность. Если существует несколько записей с одинаковыми идентифицирующими полями, то не имеет значения, сколько раз был сделан запрос.

#db

👉 @database_info
  • 👍 6
  • ❤ 2
  • 👎 2
Post #1238 1.7K
В поисках улучшения производительности базы данных: Всеобъемлющее руководство с 8 ключевыми стратегиями

По мере роста программного обеспечения наступает момент, когда необходимо улучшить производительность хранения данных. Это может проявляться в замедлении скорости поиска, ухудшении операций записи или общем снижении производительности. Хотя понимание этих проблем важно, не менее важно знать распространенные подходы к их решению.

В этой статье я постараюсь собрать все доступные техники, которые я учитываю при работе с производительностью баз данных. Я начну с простых советов и постепенно буду вводить более сложные методы по мере увеличения стоимости их реализации.

Это руководство будет полезно всем, кто хочет расширить свои знания о базах данных. Освоение всего этого может быть сложным, но, безусловно, стоит изучения.

https://levelup.gitconnected.com/in-search-of-improving-database-performance-a-comprehensive-guide-with-8-key-strategies-3496f2262cdb


#db

👉 @database_info
  • 👍 7
  • 🎉 2
Post #1237 1.9K
Интернет вещей -- "новый черный" в высоких технологиях. Мы начинаем "привыкать к хорошему", и вау-эффект сменяется "а, значит можно так было?!" Технологии с использованием индустриальных IoT-решений приходят и в такие глобальные отрасли экономики, как строительство и транспорт.
О том, что транспортная отрасль сталкивается с рядом вызовов, говорили эксперты и участники рынка на Форуме "Цифровая транспортация 2024" @dtla_ru в технологическом кластере "Ломоносов".
В рамках его мероприятий было запущено движение беспилотных грузовиков по трассе М-11, а РЖД и партнёры представили итоги внедрения Интернета вещей.
ГК "ИНСПАРК" @InsparkGroup разработчик отечественной Inspark.IoT Platform, продемонстрировал, насколько прозрачными и управляемыми могут стать такие важнейшие объекты инфраструктуры, как железнодорожный мост, компрессорная станция, участки пути. Их "цифровые двойники" уже передают массивы данных для онлайн -мониторинга обслуживающим специалистам.
По словам Олега Крупенко, генерального директора ГК "ИНСПАРК", скоро
цифровое проектирование по ТИМ-модели и работа с "цифровыми двойниками" станут "золотым стандартом" при  проектировании и эксплуатации транспортных объектов такого масштаба.

Больше новостей Интернета вещей / IoT-технологий 🔜 @InsparkGroup
  • 👍 2
  • 🔥 2
Post #1236 1.78K
⚡️ Совет по работе с базами данных 💡

Иногда вы хотите сделать столбцы уникальными, но не можете сделать это, потому что, например, в таблице все еще существуют строки, помеченные как удаленные, с тем же значением. Тем не менее, вы можете создать это ограничение, включив только неудаленные строки.

#db

👉 @database_info
  • 👍 5
  • 🎉 3
Post #1224 1.97K
SQL на LeetCode

SQL на Leetcode #13
SQL на LeetCode #16
SQL на LeetCode #18
SQL на LeetCode #20
SQL на LeetCode #23
SQL на LeetCode #25
SQL на LeetCode #26
SQL на LeetCode #28
SQL на LeetCode #30
SQL на LeetCode #32

источник

#db

👉 @database_info
  • 👍 7
Post #1223 1.56K
О создании системы, преобразующей текст в SQL для аналитиков Pinterest

Написание запросов для решения аналитических задач — это основное занятие тех, кто работает с данными Pinterest. Но подбор подходящих данных и преобразование описания проблемы в корректный и эффективный SQL‑код могут оказаться непростыми делами. Ведь речь идёт о среде, которая быстро меняется, и о значительных объёмах данных, разбросанных по разным местам.

https://habr.com/ru/companies/wunderfund/articles/832092/

#db

👉 @database_info
  • 👍 5
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →