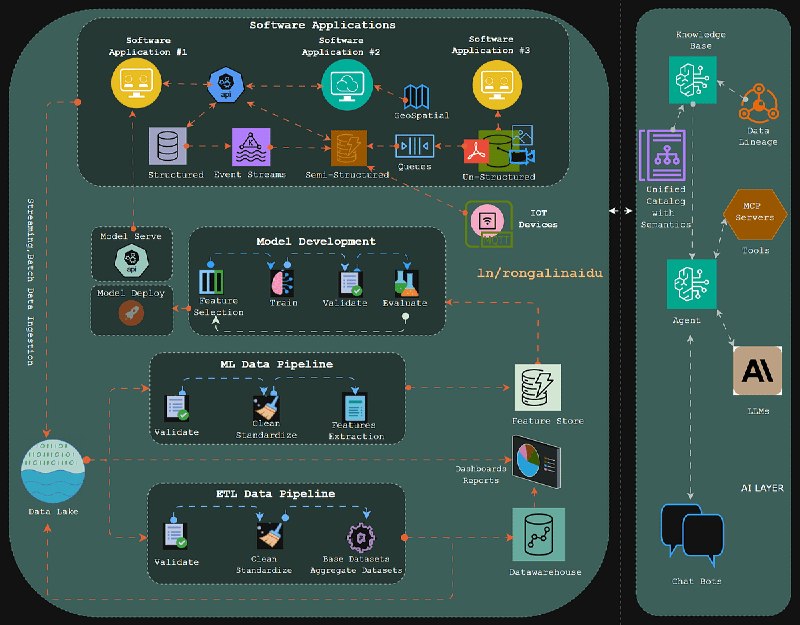
🔵 عنوان مقاله
Why We Moved from Hive-Style Data Lakes to Apache Iceberg? (12 minute read)
🟢 خلاصه مقاله:
چرا ما انتقال از دریاچه داده با سبک Hive به Apache Iceberg را ترجیح دادیم؟ این سوال، برای تیمهای داده و تحلیلگرانی که به دنبال بهبود کارایی و انعطافپذیری سیستمهای خود هستند، بسیار حائز اهمیت است. در گذشته، بسیاری از سازمانها از دریاچههای داده مبتنی بر هارد قالب Hive استفاده میکردند که عمدتاً بر روی فایلهای Parquet در سامانه S3 و با کاتالوگ AWS Glue استوار بود. این سیستمها، در طول زمان، با مشکلاتی مانند محدودیتهای درویشپذیری، ناتوانی در اصلاح ساختارهای داده و مشکلات در بروزرسانیهای اسکیمای دینامیک، مواجه شدند.
با گسترش اکوسیستم AWS و افزودن قابلیتهایی مانند پشتیبانی بهتر از جداول S3 و امکانات جدید، تیمهای داده توانستند این نواقص را کاهش دهند. در این مسیر، معرفی و توسعه Apache Iceberg به عنوان یک فرمت جدول منطبق بر استاندارد، نقطهعطف بزرگی بود. Iceberg با قابلیتهای خاصی مانند حذف کامل نگرانیهای مربوط به اصلاح اسکیمای جداول، پشتیبانی از تغییرات سریع در ساختار دادهها، امکان سفر در زمان (Time Travel) برای بازیابی نسخههای قبلی دادهها و برنامهریزی بهبود یافته در اجرای کوئریها، انقلابی در مدیریت دادهها ایجاد کرد.
در نتیجه، انتقال به Iceberg نه تنها مشکلات گذشته را برطرف کرد، بلکه کارایی عملیاتهای تحلیل و پرسوجو را هم افزایش داد. این مزایا موجب شد تا سازمانها بتوانند درک عمیقتری از دادههای خود داشته و به صورت مؤثرتری تصمیمگیری کنند. در نهایت، این تحول، نقطهی عطفی در روند مدیریت دادههای بزرگ و سیستمهای دیتا آنالیتیکس به حساب میآید.
#دیتا_مدیریت #Iceberg #تحلیل_داده #پیشرفته
🟣لینک مقاله:
https://medium.com/@rongalinaidu/why-we-moved-from-hive-style-data-lakes-to-apache-iceberg-f9f23e7a64d3?utm_source=tldrdata
➖➖➖➖➖➖➖➖
👑 @Database_Academy
Post #1368
99