


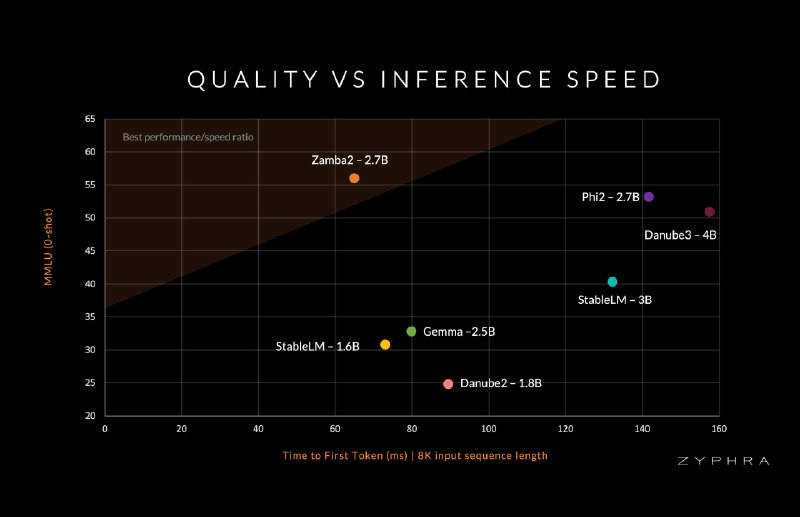
Zamba2-2.7B - это гибридная модель, состоящая из блоков пространства состояний (state-space) и трансформеров. Она сохраняет качество инференса модели 3-4В плотности, требуя при этом вычислительных ресурсов на уровне модели плотностью 1-2B.
Такие характеристики были получены за счет использования блоков Mamba2, чередования блоков внимания в схеме "А-В-А-В" и применения LoRA projector для каждого общего MLP-блока.
Zamba2-2.7B использует токенизатор Mistral v0.1 и была предварительно обучена на 3T токенов текста и кода, полученных из открытых источников, включая датасет Zyda.
По завершению обучения, модель была подвергнута дополнительной фазе агрессивного снижения скорости обучения на смеси из 100B высококачественных токенов.
Согласно заверению создателей, Zamba2-2.7B достигает лучших результатов среди моделей аналогичного масштаба, таких как Gemma2-2.7B, StableLM-3B, OpenELM-3B и Phi2-2.7B.
⚠️ Внимание:
🟠модель не имеет встроенной модерации и не подвергалась дополнительному цензурированию;
🟠модель не была дообучена для выполнения инструкций или выполнений функций чата, поэтому не стоит ожидать хороших результатов от нее в этих задачах;
🟠не рекомендуется использовать модель без поддержки Mamba, поскольку это приведет к значительному увеличению задержки и использования памяти.
Эксплуатация модели доступна с использованием Zyphra's fork of transformers или с помощью кода из репозитория разработчиков модели.
▶️Локальный запуск :
# Сlone and install
git clone https://github.com/Zyphra/Zamba2.git
cd Zamba2
pip install -e

# Install core mamba dependencies
pip install -U mamba-ssm causal-conv1d

# Inference
from mamba_model import MambaModel
from mamba_config import MambaConfig
import torch
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("Zyphra/Zamba2-2.7B")
input_text = 'A funny prompt would be '
input_ids = tokenizer(input_text, return_tensors="pt").to("cuda")["input_ids"].transpose(0,1)
model = MambaModel.from_pretrained(model_name = "Zyphra/Zamba2-2.7B").cuda().half()
tokens_to_generate = 20
model.eval()
with torch.no_grad():
    for _ in range(tokens_to_generate):
        out = model(input_ids)
        out_last = out[:, -1]
        idx = torch.argmax(out_last)[None, None]
        input_ids = torch.cat((input_ids, idx), dim=0)
input_ids = input_ids.transpose(0, 1)[0]
print(repr(tokenizer.decode(input_ids.cpu().numpy().tolist())))
📌Лицензирование : Apache 2.0 license
🟡Страница проекта
🟡Arxiv
🟡Модель на HF
🖥Github [ Stars: 10 | Issues: 0 | Forks: 0]
@ai_machinelearning_big_data
#AI #ML #SLM #Mamba