TGViewer
Channel Public Channel
Аналитика данных / Data Study

Аналитика данных / Data Study

@data_study

Помогаю аналитикам расти в профессии и доходе

Курс по продвинутому SQL и автоматизации потоков данных https://datastudy.ru/sql_advanced

По всем вопросам: @daniildzheparov

Канал в MAX https://max.ru/id591908196110_biz
Subscribers
9.46K
Photos
623
Videos
68
Links
463

Showing posts older than #1479 · Back to latest

Older Posts 10 shown
Post #1478 1.23K
Чем мне помогает ИИ на реальных задачах аналитика данных

По моим наблюдениям есть 3 лагеря людей
1. "ИИ не может помочь мне в моих задачах потому что ..."
2. "Я делаю практически все через ИИ, хотя сам этого никогда не делал"
3. "Использую ИИ как помощника, который ускоряет мой процесс работы и снимает часть рутины и объема, но главные вещи я делаю сам"

Первый и второй лагерь - это две крайности. Одни игнорируют удобство ИИ, а другие им злоупотребляют и с небольшими собственными техническими навыками сильно полагаются на него.
Я отношусь к 3-му лагерю и называю это "осознанное использование" 😁, где ИИ реально экономит 3–5 часов в неделю

Например, часть моих сценариев

🔹 Генерация и проверка SQL и Python кода по ТЗ/задаче. Даёшь ИИ описание и сэмпл данных: «Нужно посчитать LTV по когортам, окно 12 месяцев, исключить возвраты, группировка по source и country» — и получаешь рабочий запрос с оконными функциями и CTE. Дальше проверяешь логику, оптимальность, правишь сам или через итерации с агентом и доводишь до финала. Это не сразу «готовое решение», а черновик, который экономит время на написание кода с нуля.

НО ЕСЛИ ТЫ САМ НЕ ЗНАЕШЬ SQL ИЛИ PYTHON, такой подход будет содержать кучу ошибок, которые ты даже проверить не сможешь. Это сравнимо с тем, чтобы попросить ИИ написать текст на китайском, а результат ты никак не оценишь, если сам китайского не знаешь.

🔹 Рефакторинг кода. Есть старый запрос на 700 строк без комментариев? Кидаешь его в ИИ с промптом: «Разбей на CTE, добавь алиасы, прокомментируй каждый блок одной строкой, объясни логику преобразования данных». Получаешь читаемую структуру, которая поможет разобраться в чужом коде и быстрей его понять

🔹 Работа с документацией и поиском информации по гиту. Нужно быстро найти, как считается конкретная метрика или где и как используется конкретная таблица? Натравил ИИ на репозиторий со всеми файлами или на выборку документации и просишь: «Найди все места, где упоминается Retention, выпиши формулы, источники данных. За пару минут получаешь выжимку, которую раньше искал вручную через поиск или спрашивая других аналитиков.

🔹 Прототипирование дашбордов и макетов. Это не про тему навайбкодить готовый дашборд, так в крупных компаниях с установленным набором инструментов и доступов не прокатит. Это про структуру разрабатываемого отчета: «Дай список метрик, измерений и фильтров для панели “Продажи по регионам”» или «Предложи 3 варианта визуализации для динамики оттока». Это помогает быстрее согласовать макет с бизнесом и не тратить время на «переделки».

🔹 Разбор ошибок и логов. Получил непонятную ошибку в ETL потоке данных? Кидаешь текст ошибки и фрагмент кода — ИИ часто подсказывает, в чём проблема: «Ошибка связана с приведением типов в JOIN, проверь, что id в обеих таблицах — INT, а не VARCHAR» или «В подзапросе нет алиаса для агрегированного поля».

➡️ИИ не заменяет экспертизу аналитика. Он не знает всех бизнес-правил, особенностей логики, хотелки заказчиков и «подводные камни». Но он отлично закрывает рутину: синтаксис, структуру, выжимки, черновики. А финальное решение, проверка данных и ответственность — всегда на аналитике.
  • ❤ 17
  • 👍 13
  • 🏆 1
Post #1477 1.25K
🎉 С Днём знаний, друзья! 📚

Пусть новые знания даются в радость, а не через «надо», и сразу находят применение — в крутых запросах, в аккуратных витринах, в решениях, за которые не стыдно. Пусть каждая строчка кода становится не просто упражнением, а маленьким шагом к уверенному «я это умею». 💪

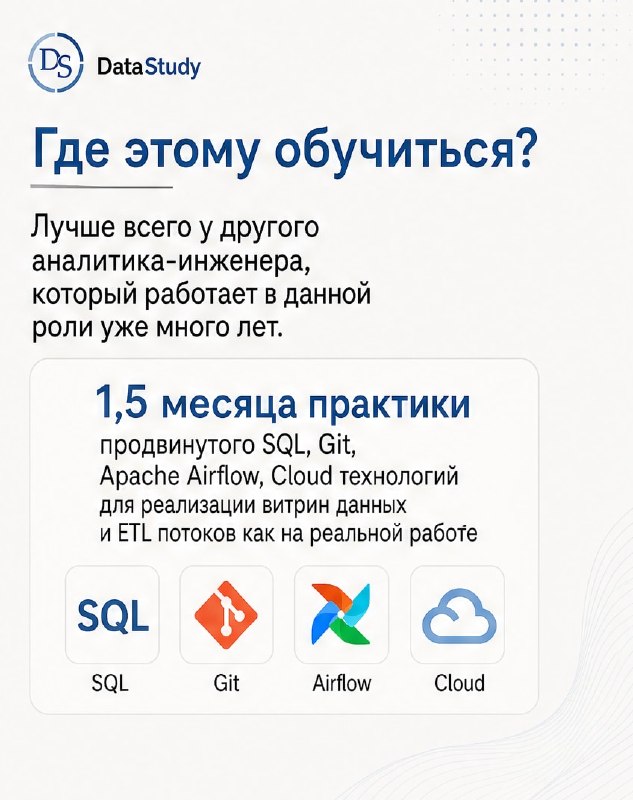
А если хочется, чтобы теория не висела в воздухе, а сразу ложилась в практику — я как раз готовлю группу к старту 14 сентября. Там всё про реальные задачи, инструменты и навыки, которые реально спрашивают на собеседованиях.

Обучение созданию аналитических витрин и автоматизации потоков данных
datastudy.ru Продвинутый SQL и автоматизация витрин данных За 1.5 месяца научитесь создавать витрины данных с помощью SQL и автоматизировать их обновление в Apache Airflow и не только
  • 🎉 10
  • ❤ 5
Post #1474 1.76K
Счастливый на рыбалке в месте, где провел все незабываемое детство 😊
  • 🔥 20
  • ❤ 8
  • 🎉 4
Post #1473 1.95K
CTE + рекурсия: когда нужно «пройтись» по иерархии данных

Есть задачи, где данных недостаточно «плоских» таблиц: нужно подняться по иерархии (от подчинённого к руководителю), спуститься по дереву категорий или пройти по цепочке транзакций. Тут выручают рекурсивные CTE — мощная штука, про которую многие вспоминают только тогда, когда обычный JOIN уже не спасает.

Конструкция простая по форме, но очень эффективная:
WITH RECURSIVE имя_cte AS (
-- Базовый случай (с чего начинаем)
SELECT ...
UNION ALL
-- Рекурсивный шаг (как переходим дальше)
SELECT ... FROM имя_cte JOIN ...
)
SELECT * FROM имя_cte;


Есть типичный формат иерархической таблицы, где фиксируется сам объект и его родительский id. К примеру давайте посмотрим на категории товаров, когда например для товара есть целый путь категорий ("Для мужчин" - "Верхняя одежда" - "Зима" - "Куртки"). В итоге с помощью рекурсии для каждого объекта можно сразу достать весь путь его родительских категорий).

WITH RECURSIVE category_path AS (
SELECT
category_id,
parent_category_id,
name,
name AS full_path,
1 AS depth
FROM categories
WHERE parent_category_id IS NULL -- корневые категории

UNION ALL

SELECT
c.category_id,
c.parent_category_id,
c.name,
cp.full_path || ' > ' || c.name,
cp.depth + 1
FROM category_path cp
JOIN categories c ON c.parent_category_id = cp.category_id
)
SELECT category_id, full_path, depth
FROM category_path;


Другими словами, рекурсия с cte - это некая реализация цикла с помощью SQL. Ставь 👍 если узнал новое
  • 👍 37
  • ❤ 3
Post #1472 2.16K
Мой любимый, но редкий вид офиса

Спасибо моей профессии, что она позволяет работать из любой точки 🙏

В целом по жизни заметил, что моя одна из основных ценностей - это свобода. Терпеть не могу, когда нужно быть загнанным в работе, жизни, отдыхе, досуге в какие-то рамки. Хочу принимать решение сам, делать то что я внутри себя желаю и хочу, но при этом это никогда не выражается во мне как «бунтарство», или не выполнение своих обязанностей. Когда процессы выстроены правильно, они в любом случае оставляют человеку свободу выбора, частичку творчества и разнообразие решений, будь то рабочие процессы или бытовые вопросы.

Увы, сейчас глобально все тяжелее ощущать вокруг себя то что мне ценно. ВСЕ вокруг вызывает неудобства и постоянную тревожность. Думаю, что сейчас я далеко не один такой.

Желаю каждому из вас вокруг себя по максимуму создавать и удерживать ту уютную и спокойную среду, на которую можно повлиять напрямую и которая зависит только от вас самих ♥️
  • ❤ 41
  • 👍 12
Post #1471 2.14K
Кормили нутрий в Туле, рекомендую 😉
  • ❤ 21
  • 🔥 2
  • 👍 1
Post #1470 2.66K
Применяю SQL потому что лень писать на Python)

Решал типовую рабочую задачу.
Суть в том, что данные были получены с помощью python и по датасету нужно было сделать несколько преобразований и вычислений метрик.

Преобразования сами по себе стандартные: фильтрация, агрегация, сортировка. Можно взять написать все эти операции с помощью pandas к уже имеющемуся датафрейму.

Но мне так стало лень писать несколько строк кода на python, что для меня было проще написать всю логику в одном select запросе на sql 😁
Вы спросите
"нафига так делать???" чтобы применить sql данные нужно положить в базу данных

Нет, точнее не всегда) Данные остались в том же датафрейме, а обработку я сделал с помощью pandasql.

Простой пример применения и сравнения pandas VS pandasql 👇
import pandas as pd 
from pandasql import sqldf

data = {
'product_id': [1, 2, 1, 3, 2, 3, 1],
'sale_date': ['2023-01-01', '2023-01-02', '2023-01-03', '2023-01-01', '2023-01-02', '2023-01-03', '2023-01-04'],
'amount': [100, 200, 150, 300, 250, 350, 400]
}

df = pd.DataFrame(data)

# логика с pandas (фильтруем по датам, группируем по product_id, считаем агрегат суммы по полю amount и сортируем по нему же)
result_df = (
df[df['sale_date'].between('2023-01-02', '2023-01-03')]
.groupby('product_id', as_index=False)['amount']
.sum()
.sort_values(by='amount', ascending=False)
)

# или применяя sqldf
query = """
SELECT product_id, SUM(amount) as total_amount
FROM df
WHERE sale_date BETWEEN '2023-01-02' AND '2023-01-03'
GROUP BY product_id
ORDER BY total_amount DESC
"""

sql_result = sqldf(query, globals())


Я на работе настолько привык крутить все данные с помощью SQL, что в голове любые преобразования я продумываю на логике sql-запросов, а потом если все таки нужно могу переложить это на python скрипты.

Это как с разговорными языками. Если например переезжаете в другую страну и начинаете разговаривать/писать/слушать на другом языке, то у вас мозг со временем начинает мыслить на этом же языке. У меня так было с английским 🇬🇧, когда учеба и работа была полностью на английском, при этом жил в Москве, но все равно замечал что формулирую предложения сначала на английском, а потом уже осознаю что можно на русском)

P.S. sqldf применяет диалект SQLite, поэтому можно использовать все функции которые доступны для этой базы.

👍 если узнали новенькое для себя из поста
  • 👍 26
  • ❤ 11
  • 🔥 2
  • 🤓 1
Post #1467 2.4K
Data Warehouse, Data Lake, Data Lakehouse, Data Fabric, Data Mesh – что это такое, и в чем разница между концепциями

Есть классная историческая справка про появление понятия DWH (сможете похвастаться перед коллегами или на собесах знанием истории концепций хранилищ данных 😎). Если кто-то думает, что аналитика данных и Big Data зародились когда все об этом начали в рекламе курсов кричать, то вы далеко ошибаетесь, история уходит еще в 20 век.

Ну и лаконично описаны концепции хранилищ и показаны на визуальных схемах с основными элементами. Помогает понять зачем вообще такой зоопарк систем нужен и как это все обусловлено эволюцией подходов работы с данными.

Читать статью
  • ❤ 10
  • 👍 3
Post #1461 1.83K
За что аналитики получают 300к+ в месяц?

Далеко не каждый аналитик получает такие суммы, а только те, кто имеет сильные технические компетенции. И получают за то, что другие специалисты сами сделать не могут, или если спец может сделать работу за 2-их или 3-их людей, которые суммарно будут дороже стоить компании.

Поэтому совмещение компетенций аналитики и инженерии данных в одном специалисте ценят, ищут, и готовы за это платить выше чем тем, кто только знает "базовые запросы sql, собрать ручную выгрузку" или "я могу только в excel это сделать"

Поэтому если хочешь больше 💰, то можешь даже не рассчитывать, что базовых навыков SQL или Python тебе для этого будет достаточно. Нужно копать глубже, иметь техническую насмотренность.

➡️А получить это ты можешь вместе со мной на курсе, стартуем уже завтра
  • 👍 8
  • ❤ 3
  • 🔥 2
Post #1455 2.62K
Как хранить исторические данные и отличать их от актуальных данных

В аналитике всегда есть потребность работать с историческим объемом данных, чтобы уметь отвечать на вопросы бизнеса на всем интервале времени, а не только знать ситуацию в текущий момент.

Есть разные варианты хранения и обновления исторических данных, которые описываются типами SCD.
🔎 SCD или Slowly Changing Dimensions - медленно меняющиеся измерения, когда некоторые атрибуты в данных могут меняться со временем, тем самым возникает необходимость добавлять новую версию записи данных.

🔵 SCD type 0
Данные попадают в таблицу только один раз и становятся статичными, нет версионности и изменения данных. Подходит для хранения конкретных справочников, например названия и ISO коды стран

🔵 SCD type 1
Данные перезаписываются новым значением, что также не позволяет хранить версионность. Механизм простой, вместо старых значений в ту же строку перезаписываются новые значения измененных атрибутов, это позволяет не "раздувать" объем таблицы, но не дает доступа к историчности данных.

🔵 SCD type 2
Данный тип заключается в том, что в таблицу добавляется новая запись по измененным данным. Это реализовано с помощью специальных атрибутов, которые позволяют управлять версионностью. Обычно эти атрибуты выглядят так:
- Дата Начала версии
- Дата Конца версии
- Актуальность записи

🔵 SCD type 3
Реализация выглядит таким образом, что в таблице добавляется атрибут со старым значением.
- Историческое значение
- Новое значение
Есть большой недостаток, что невозможно добавлять много новых столбцов для хранения всех версий данных, поэтому история обычно ограничивается только предыдущей версией.

🔵 SCD type 4
Для хранения исторических данных создается отдельная таблица, чтобы хранить предыдущие версии. Основная таблица будет отображать только актуальную запись по данным. Большой плюс, что можем обращаться всегда к таблице основной версии, но при этом нужно создавать и поддерживать отдельную таблицу с историческими данными.

🔵 SCD type 5
Это некий гибрид типов 1 и 4. Если таблица имеет много атрибутов, то ее могут разбить на более мелкие таблицы справочники, которые будут статичны. Но если в этом маленьком справочнике будет перезапись значений по типу 1, то также необходимо будет перезаписать данные в связанной с этим справочнике более большой таблице измерений с помощью перезаписи ключа

🔵 SCD type 6
Гибрид типов 1,2,3. Здесь используется комбинация вышеперечисленных методов, где хранится полная историчность данных с доступом к актуальной версии и всем историческим значениям. Будут добавлены следующие столбцы для управления историчностью:
- Дата Начала версии
- Дата Конца версии
- Актуальность записи
- Историческое значение
- Новое значение

Если пост полезен, ставь реакции и делись им с другими 👨‍💻

Больше технических моментов про хранение и обработку данных в базе данных разбираем на курсе по Продвинутому SQL и ETL автоматизации

➡️Начни практическое обучение 27 июля
  • 👍 15
  • ❤ 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →