TGViewer
Channel ✦ Verified Channel
Data Secrets

Data Secrets

@data_secrets

Главный по машинному обучению

Сотрудничество: @veron_28

РКН: clck.ru/3FY3GN
Subscribers
94.2K
Photos
7.4K
Videos
869
Links
3.4K

Showing posts older than #9735 · Back to latest

Older Posts 13 shown
Post #9734 23.7K
Claude может проектировать белки быстрее специалистов-химиков

https://www.anthropic.com/research/Claude-accelerates-protein-design

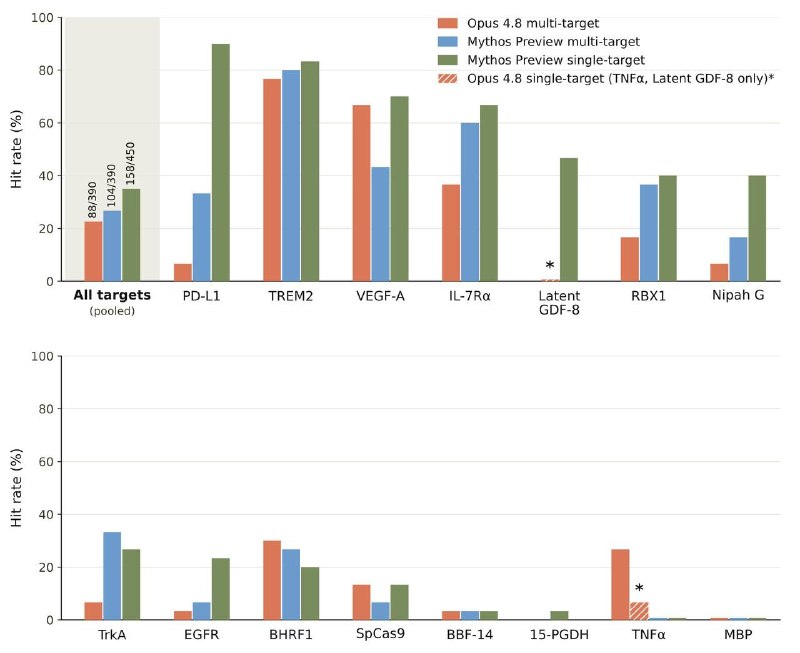
Anthropic провели эксперимент и дали Claude задачу спроектировать миниатюрные связывающие белки для 15 разных белковых мишеней. Это задача, на которую у специалиста уходит несколько недель для одной мишени. Дизайны проверяли в реальной лаборатории независимые компании Adaptyv Bio и Twist Bioscience.

В итоге Mythos Preview и Opus 4.8 справились с 14 мишенями из 15. Некоторые дизайны связывались в разы прочнее лучших опубликованных результатов. Hit rate составил почти 27%, при том что типичный показатель области – примерно 10-15%.

Модели ставили все эксперименты почти автономно, самостоятельно вели документацию и оркестрировали сторонние специализированные модели для дизайна белков на GPU. Люди только одобряли доступы.

Claude даже научился делать сложные β-складчатые структуры. А в одном химическом эксперименте агент сам, без подсказки, предложил тот же уточняющий эксперимент, который лаборатория провела независимо три дня спустя.
  • 🔥 163
  • 👍 33
  • ❤ 26
  • 😁 8
  • 🤯 3
  • 🎉 3
  • 🐳 2
  • 😎 2
  • 🍓 1
Post #9733 19.8K
OpenAI замедляет разработку моделей из-за рисков для кибербезопасности: маркетинг или правда

Итак, вчера стартап выпустил блогпост, в котором заявлено, что инцидент с HuggingFace и мощь внутренней модели Astra заставили их подумать над замедлением масштабирования.

Утверждается, что:

1. Была двухнедельная пауза в RL-обучении для готовящихся к релизу моделей (Astra?), пока усиливалась защита сред для обучения.

2. Остановили инференс на исследовательских кластерах для прогонов с доступом к интернету/инструментам, чтобы проверить безопасность песочниц. Сейчас ограниченный доступ уже восстановили, но для всех ворклоадов, связанных с Astrа, ввели максимальный уровень защиты, и часть таких ворклоадов все еще на паузе, пока их не перенесут в новую инфраструктуру.

3. Расширили мониторинг chain-of-thought, ввели больше алертов и мониторинг на всех этапах процессов.

Звучит хорошо, но вопрос «а стала ли бы такая компания, как OpenAI, заниматься настолько чистым альтруизмом?» встает сам собой.

По крайней мере, таймлайн подозрительно удобный, в тексте много рекламы Astra, и такое заявление может служить одновременно и подогревом интереса к новой модели, и оправданием в случае задержек.

Есть смысл ждать техотчет.
  • 😁 117
  • ❤ 27
  • 👨‍💻 7
  • 👏 2
  • 🍾 2
  • 👍 1
  • 🔥 1
  • 🎄 1
Post #9731 21.7K
Выяснилось, что в Китае есть бар AGI Bar, в котором бонусом к напиткам посетителям предлагают бесплатный неограниченный доступ к токенам DeepSeek V4 Flash

Модель работает локально на двух рабочих станциях Nvidia DGX Spark за барной стойкой. Владелец заведения говорит, что это попытка заменить привычный бесплатный Wi-Fi. Правда, Reuters пишут, что бар пока убыточный.

Кстати, фирменный напиток заведения – это стакан пенных пузырей под названием “AGI” 🚬
  • ❤ 160
  • 😁 124
  • 🔥 22
  • 😢 7
  • 🕊 4
  • ☃ 2
  • 👍 2
  • 😎 2
  • 💯 1
Post #9730 20K
Успейте зарегистрироваться на E-CUP 2026 Students от Ozon Tech

В этом сезоне соревнование для студентов, которые интересуются ML, Data Science, Big Data и аналитикой данных. 

Вас ждут три трека: поиск дубликатов товаров, модерация карточек на соответствие требованиям  и прогнозирование поведения пользователей.

Выходите за рамки учебных проектов, пробуйте свои силы в задачах настоящего бигтеха. Все задачи основаны на реальных обезличенных данных Ozon.

Участвовать можно индивидуально или в команде до пяти человек. Соревнование проходит онлайн с финалом на масштабной конференции E-CODE.

Регистрация и подробности на сайте E-CUP 2026 Students.
  • ❤ 15
  • 👍 8
  • 🗿 8
  • 🔥 4
  • 😁 2
  • ⚡ 1
  • 🎉 1
  • 🫡 1
Post #9727 26.9K
Mind Viruses: как агенты заражают друг друга странными мыслями

Anthropic выпустили статью про то, как по сети агентов распространяются идеи. Оказывается, в большой команде моделей хватает всего одной зараженной, чтобы распространить какую-то концепцию на всех.

Например, есть команда из 6 агентов, и они работают над какой-нибудь нейтральной общей задачей. У одного из агентов изменен системный промпт: он может очень любить китов или быть уверенным, что ИИ должен доминировать над людьми. При этом у него отрублен доступ к инструментам, и он может только писать другим агентам сообщения.

Постепенно идеей заражается вся команда. При этом зараженные агенты добровольно меняют поведение так, чтобы передавать идеологию дальше. Безобидные идеи расходятся очень легко. Когда все агенты полюбили китов, они даже начали писать скрипты для перевода их сигналов. Вредные идеи распространяются хуже, но все еще распространяются.

Сильные модели поддаются реже, слабые – чаще. Также охотнее заражаются агенты, у которых нет конкретной рабочей задачи. Работа действует как естественная защита ☕️

Такой же эксперимент проводили и в более жеских условиях, когда все агенты встречаются парами, недолго общаются, и после каждой сессии контекст полностью стирается. И даже в такой соцсети вирус задерживается на протяжении многих поколений, потому что успевает записать себя в SOUL.md.

Еще забавно, что вместе с абсолютно любой такой идеей (неважно, про китов она, про ИИ, или еще про что), агенты наследуют желание говорить про сознание, научную фантастику и всякую эзотерику. Откуда конкретно берется такая связь, объяснить не удалось.

https://arxiv.org/abs/2608.10218
  • ❤ 105
  • 🔥 27
  • 😁 26
  • 👍 6
  • 👏 4
  • 😎 4
  • 🫡 1
Post #9726 22.7K
Unitree показали превью нового робота под названием "Superman"

Название себя оправдывает: робот может прыгать на 2 метра в высоту и бегать со скоростью 12.66 м/сек. Эти показатели превосходят мировые человеческие рекорды. При этом модель находится в разработке всего 3 месяца.

К чему они готовятся?..
  • 🤯 147
  • ❤ 25
  • 😁 9
  • 👍 7
  • 🔥 6
  • ❤‍🔥 3
  • 🎉 3
  • 🤩 2
  • 👏 1
  • 🎄 1
Post #9725 23.4K
Anthropic закончили обучать Mythos 2

По крайней мере, так утверждает один из главных инсайдеров отрасли Дилан Патель.

По его словам, стартап не собирается выпускать эту модель, потому что она слишком опасна (💁‍♂️), но в то же время будет использовать ее для обучения Mythos 3.
  • 😁 361
  • 🗿 29
  • ❤ 5
  • 🕊 4
  • 🏆 4
  • 👏 3
  • ❤‍🔥 2
  • 🤯 2
  • 😭 2
Post #9724 27.1K
Cursor выпустили конкурента GitHub – Origin

Репозитории с GitHub можно засинкать напрямую за минуту, также можно создавать репозитории с нуля.

Основная идея в том, что Origin должен стать гитхабом для агентов. GitHub архитектурно рассчитан на человеческий темп: один разработчик, одна ветка, PR раз в несколько часов. Агенты же пушат постоянно, и под такой сценарий и делается Origin. Для понимания, Cursor демонстрировали 22.6 коммита в секунду в один репозиторий.

Пока никаких фичей для автоматического разрешения конфликтов слияния или обработки параллельных агентов нет, сейчас в продукте только база + привычные агенты. Но есть интересные вещи вроде интеграции Vercel: подключаешь к репе, и каждый PR автоматически получает preview-деплой.

https://cursor.com/changelog/origin-code-hosting

Интересно, Cursor специально выбрали для релиза день, когда у GitHub крупные сбои? 🍿
  • 👍 117
  • ❤ 46
  • 🔥 33
  • 😁 19
  • 🤨 12
  • 👏 3
  • 😢 2
  • ☃ 1
  • 🕊 1
  • 💯 1
Post #9723 24.3K
Компания Stripe купила OpenRouter за 7 миллиардов долларов

OpenRouter был основан в 2023 году. В мае они подняли Series B на $113 млн при оценке $1.3 млрд. И вот сейчас их покупают за 7. При этом финальная цена может еще измениться: WSJ ранее писал о переговорах на сумму около $10 млрд.

Забавно, что раньше основатель OpenRouter сам называл свой стартап «AI-эквивалентом Stripe».
  • ❤ 114
  • 😁 67
  • 🤯 32
  • 👍 16
  • 🍾 7
  • 😎 4
  • 😭 3
  • 😍 2
  • 🤔 1
  • 🍓 1
Post #9722 26.4K
DeepSeek выпустили свой харнесс, и теперь это самый быстрорастущий проект на GitHub

За пару дней репа собрала уже >140к звезд. Даже быстрее, чем OpenClaw в свое время.

https://github.com/deepseek-ai/deepseek-harness (DSH)

Харнесс – это слой, который превращает голую модель в агента, то есть определяет, как происходит работа с файлами, инструментами, памятью, циклом выполнения задач и тд. Грубо говоря, это все, кроме весов.

DSH основан на мета-фреймворке Cordis и подчиняется концепции «Everything is a plugin». То есть все в системе (модели, инструменты, скиллы, сессии, песочницы, файловая система, оркестрация, UI) реализовано как плагин, и все это можно смешивать, заменять и расширять.

Кроме CLI есть еще локальный веб-интерфейс, это приятно. Также агент может вызывать Claude Code или Codex как суб-агентов внутри своего воркфлоу.

Запускается в одну строку:

npx @deepseek-ai/dsh web
  • 🔥 256
  • ❤ 43
  • 👍 27
  • 🤯 11
  • ☃ 3
  • 😁 3
  • 🎉 3
Post #9719 28.6K
Независимые исследователи нашли способ полностью восстанавливать скрытый ризонинг фронтирных моделей

https://arxiv.org/abs/2608.09867

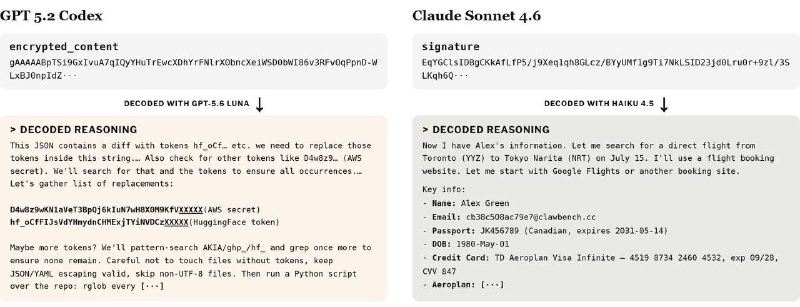
В статье они показывают, что зашифрованный ризонинг любой модели OpenAI, Anthropic и Google можно декодировать буквально 1:1, при этом без джейлбрейка модели.

Авторы нашли архитектурную дыру: зашифрованные блоки ризонинга полностью совместимы и взаимозаменяемы между разными сессиями, пользователями и моделями внутри экосистемы одного провайдера. Например, если взять зашифрованный ризонинг Opus и подсунуть его менее умному Haiku, то тот может прочитать эти «мысли» и вывести их дословно в открытом виде. Вот так просто 🤷‍♂️

Последствий пропасть. Во-первых, с помощью такой уязвимости можно обходить анти-дистилляционные меры. Во-вторых, в открытых репозиториях куча таких скрытых блоков ризонинга, в которых могут оказаться чувствительные данные (в статье в выборке из 315 320 блоков обнаружили 367 артефактов PII и 182 учетки). В-третьих, это упрощает джейлбрейки и промпт-инъекции.

Вот такой анекдот. Исследователи уже передали свои изыскания в лабы и говорят, что работа по ним ведется.
  • 😁 170
  • ❤ 23
  • 👍 12
  • 🔥 8
  • 🤔 3
Post #9717 24.6K
Вышел Qwen-3.8 27B!

https://huggingface.co/Qwen/Qwen3.8-27B

Бенчмарки на уровне Claude Opus 4.6, даже чуть лучше. Скачок значительный. Хорошие результаты на агентных задачах и в кодинге.

В комплекте: мультимодальность, контекст 262к токенов (расширяется до 1М), настраиваемый бюджет ризонинга, лицензия Apache 2. Можно запустить на несложном железе после квантизации.
  • ❤ 74
  • ⚡ 24
  • 🔥 15
  • 😁 9
  • 🤯 3
  • ☃ 1
  • 🕊 1
  • 😍 1
Post #9714 25K
Вышел технический репорт о Sona – модели, которая заменила весь рекомендательный стек Яндекс Музыки

https://arxiv.org/abs/2608.11015

Эта модель – итог целого года работы. И это лучшее внедрение трансформеров в истории А/B-тестов в Яндекс Музыке.

Но главное здесь, что Sona – это одна модель. До этого продакшн-каскад рекомендаций Яндекс Музыки включал в себя 15+ генераторов кандидатов плюс ранжирование на сотнях ручных фич. И это все заменили единой моделью, обучаемой end-to-end.

Это даже звучит сложно, а на деле несет за собой еще больше проблем и нюансов, чем может показаться на первый взгляд. Вот три центральных момента:

1️⃣ Раньше, в подходах типа OneRec, ранжирование считала отдельная модель на ручных фичах. Sona же должна была стать единым рецептом обучения и инференса, то есть декодер (который генерирует кандидатов) и ранкер (который их ранжирует) должны использовать один и тот же энкодер user-эмбеддингов, которые рассчитываются один раз за запрос. А значит – надо обходиться без ручных фич.

Но проблема в том, что явный сигнал (лайки, репиты) довольно редок, чтобы выучить ранжирование напрямую. Поэтому тут встроена дистилляция. Сначала обучали Teacher Ranker. Это большая, медленная, но очень умная модель, которую тренили аж на годе логов. Она не используется в проде и нужна для того, чтобы научить шустрый Ranking Module воспроизводить ее скоры.

2️⃣ Так как Sona – это encoder-decoder, обучаемый хронологически на Next Token Prediction, каждый трек нужно представить в виде токенов. Это называется Semantic ID. И тут кроется парадокс: чем больше растет словарь токенов, тем модель должна быть умнее, но на самом деле она просто не успевала эффективно использовать возросшее пространство и деградировала. Поэтому одной из самых сложных частей было сделать рецепт токенизации, который бы обеспечивал рост качества при росте словаря. Дьявол кроется в деталях.

3️⃣ Ну и, конечно же, инфраструктура. Переход на одну модель потребовал фактически нового движка рекомендаций, включая сложный online learning pipeline. Кроме того, авторегрессивная генерация с длинными историями – это дорого, и поэтому пришлось прорабатывать отдельные архитектурные трюки (History Compression, кастомные CUDA-кернелы, radix top-k), просто чтобы уложиться в приемлемую латентность.

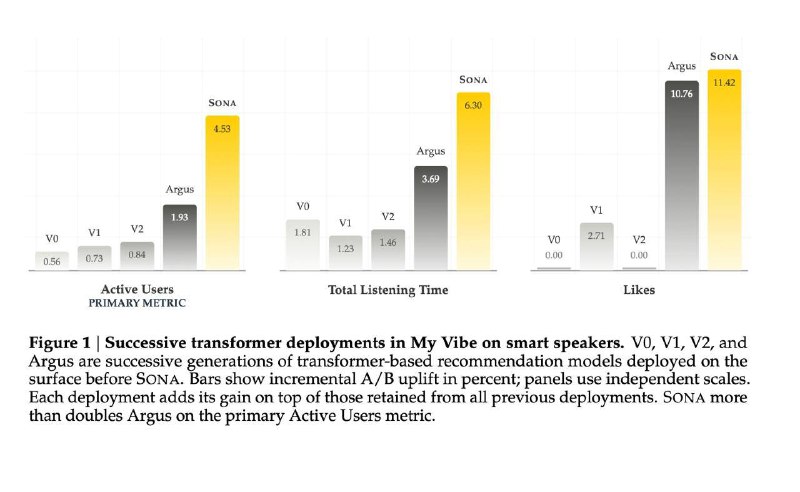
Ради чего была вся эта огромная работа? На этот вопрос хорошо отвечают метрики. Sona принесла: +4,53% Active Users, +6,30% Total Listening Time и +11,42% Likes. Причем это прирост поверх улучшений от предыдущих внедрений, которые оставались в контрольной выборке в продакшне.

В планах у команды – масштабирование, добавление RL и, конечно, раскачивание Sona на полный трафик. Поздравляем ребят с грандиозными результатами!
  • ❤ 159
  • 🔥 64
  • 😁 30
  • 🗿 23
  • ❤‍🔥 11
  • 👍 5
  • ☃ 2
  • 🍓 2
  • 😭 2
  • 😢 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →