TGViewer
Channel ✦ Verified Channel
Data Secrets

Data Secrets

@data_secrets

Главный по машинному обучению

Сотрудничество: @veron_28

РКН: clck.ru/3FY3GN
Subscribers
94.4K
Photos
7.5K
Videos
876
Links
3.4K

Showing posts older than #9466 · Back to latest

Older Posts 15 shown
Post #9464 22.6K
Data Secrets Проснулись улыбнулись: Fable 5 возвращают для всех! https://www.anthropic.com/news/redeploying-fable-5 Никакой верификации гражданства пока не будет, но в модель добавили еще больше фильтров и защит, поэтому, как пишут сами Anthropic, даже некоторые рутинные…
Коротко о возвращении Fable
  • 😁 370
  • ❤ 35
  • 🤔 12
  • 🐳 7
  • 👌 3
  • ⚡ 1
  • 👍 1
  • 🔥 1
  • 🍓 1
  • 🤝 1
  • 😎 1
Post #9463 23.6K
Проснулись улыбнулись: Fable 5 возвращают для всех!

https://www.anthropic.com/news/redeploying-fable-5

Никакой верификации гражданства пока не будет, но в модель добавили еще больше фильтров и защит, поэтому, как пишут сами Anthropic, даже некоторые рутинные задачи по кодингу или дебаггингу с большой долей вероятности будут перекидываться на Opus 4.8.

Не разгуляешься, в общем, но хотя бы так.

Также антропики вынуждены расширить сотрудничество с правительством. Им будут давать предварительные доступы к новым моделям «для оценки безопасности» + будут проводиться некие «совместные исследования».

Mythos, кстати, тоже возвращают. Но только для части организаций в США, которые были одобрены государством.
  • ⚡ 107
  • ❤ 34
  • 😁 28
  • 🕊 24
  • 🤨 11
  • 🤔 6
  • 🍓 3
  • 🤝 3
  • 🎄 1
Post #9462 21.3K
Data Secrets ⚡️ Anthropic выпустили Sonnet 5 Метрики близки к Opus 4.8, но цена ниже. Пишут, что новая версия способна выполнять более длинные задачи и качественнее перепроверять себя. До конца лета в API модель будет по скидке: $2/million input и $10/million output.…
⚫ Модель уже доступна в нашем API-сервисе DS Lab

https://dslab.tech/ai/models/llm/claude-sonnet-5

Цены: 200р/м input, 1000р/м output.

Без VPN и иностранных карт. Подключайтесь в один клик и пользуйтесь.
  • 🗿 94
  • 😁 40
  • 👍 26
  • ❤ 10
  • 🤨 5
  • 🤯 4
  • 🔥 3
  • ⚡ 2
  • 🕊 1
  • 🏆 1
  • 🎄 1
Post #9461 23.4K
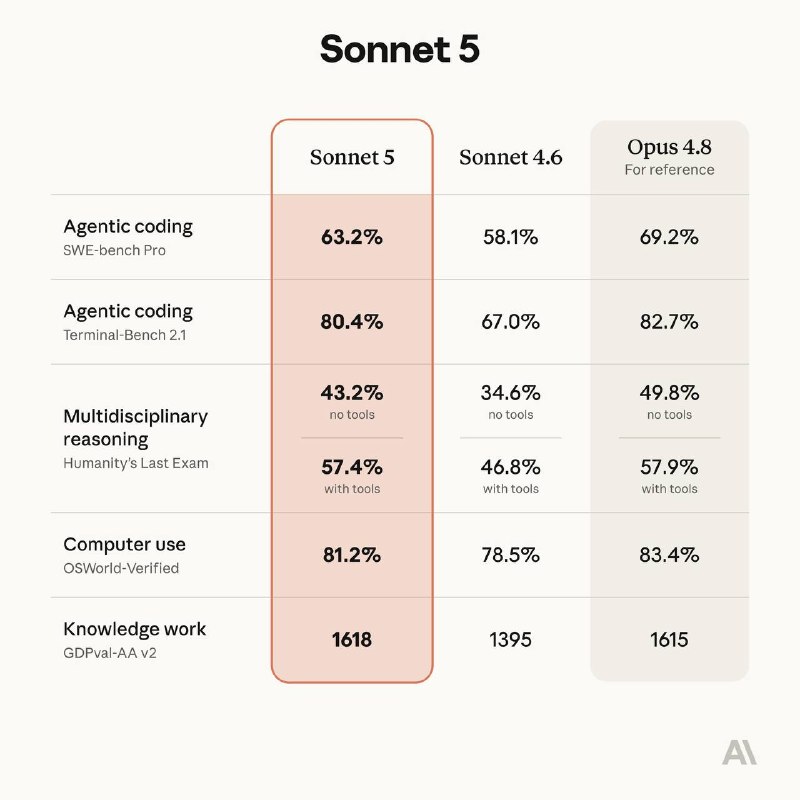
⚡️ Anthropic выпустили Sonnet 5

Метрики близки к Opus 4.8, но цена ниже. Пишут, что новая версия способна выполнять более длинные задачи и качественнее перепроверять себя.

До конца лета в API модель будет по скидке: $2/million input и $10/million output.

https://www.anthropic.com/news/claude-sonnet-5
  • 🤔 118
  • 🔥 72
  • 😁 22
  • 👍 10
  • ❤ 5
  • 🆒 3
  • 🎄 2
  • 🗿 2
  • 💯 1
  • 🍓 1
Post #9460 22.6K
VP of Engineering из Spotify дал интервью Борису Черному и случайно стал мемом

Он заявил, что в его компании делается 4500 PR ежедневно, из них 73% – с помощью агентов.

Пользователи в комментариях не поняли, откуда взялись такие огромные цифры:

«Это они добавляют каждую новую песню в git или что-то в таком роде?»

«Наглядное пособие по созданию ИИ-пузыря»

«Зачем? Последняя новая фича в Spotify появлялась 15 лет назад»


Главное, что KPI по токенмаксингу выполнили
  • 😁 322
  • 😎 41
  • ❤ 27
  • 🍓 2
  • 🫡 2
  • ☃ 1
  • 👍 1
  • 🤯 1
Post #9458 28.1K
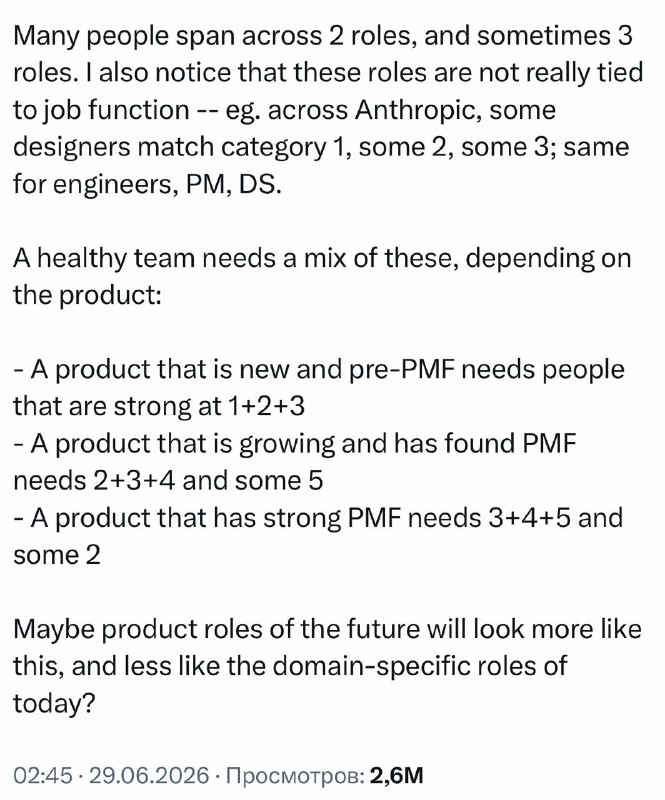
В будущем не будет продактов, инженеров и дизайнеров: создатель Claude Code Борис Черный сказал, что нас ждет всего 5 архетипов

1. Prototyper: генератор множества идей, только некоторые из которых будут реализованы.

2. Builder: быстро превращает прототипы и идеи в продукт.

3. Sweeper: чистит UX, упрощает код, оптимизирует систему.

4. Grower: берет продукт и итеративно улучшает его с точки зрения Product-Market Fit.

5. Maintainer: владеет зрелой системой и следит за ее безопасностью, надежностью и эффективностью.


При этом эти архетипы не будут зависеть от домена или специфического стека, как большинство современных ролей, и один человек сможет объединять в себе до трех статусов.

В новой системе не нашлось места только эйчарам 🤷‍♂️
  • 😁 367
  • ❤ 58
  • 👍 43
  • 🗿 6
  • 👨‍💻 4
  • 🤯 3
  • 🕊 2
  • 🫡 2
  • 🍓 1
  • 🍾 1
Post #9455 21.1K
Новый дроп в опенсорс от Сбера: выложили токенизатор KVAE-Audio

Фундаментально эта модель решает давнюю проблему обучения диффузионных систем. Им требуется максимально качественное сжатое представление данных, от которого напрямую зависит верхний предел возможностей создания нового контента. Разработчики закрыли эту потребность, представив третью часть семейства KVAE. Ранее команда уже публиковала схожие алгоритмы для работы с видео и картинками, а теперь очередь дошла до аудио формата.

Система способна переваривать треки на частоте 48 кГц, охватывая весь спектр человеческого слуха. Во время обработки алгоритм уплотняет временную шкалу в 960 раз. На выходе получается сверхкомпактное пространство, состоящее из 64 каналов. Такие скромные размерности сильно упрощают жизнь при тренировке генеративных архитектур.

Главный инженерный вызов здесь заключался в адаптации выходных данных именно под диффузию. Классические подходы часто показывают отличные цифры при воссоздании исходного аудио, но плохо справляются с созданием оригинального материала. Чтобы сбалансировать результаты в обеих задачах, авторы применили уникальный метод регуляризации.

Если посмотреть на бенчмарки, новинка уверенно обходит MMAudio от Sony абсолютно по всем фронтам. При сравнении с DACVAE от Meta и SAME-L от Stability AI разработка выигрывает в качестве генерации и держит паритет в реконструкции, при этом обладая значительно меньшим весом.
Код и веса под свободной лицензией MIT уже лежат на GitHub и Hugging Face.

Habr
  • ❤ 87
  • 🔥 38
  • 🗿 32
  • 👍 22
  • 😁 7
  • ☃ 2
  • 🤔 2
  • 💯 2
  • 🏆 1
  • 💘 1
Post #9454 23.7K
Чтение мыслей 2.0 от Meta*: компания выпустила Brain2Qwerty v2

В компании сделали модель, которая может с большой точностью восстанавливать текст, который человек молча печатает на клавиатуре. И, кажется, они впервые доказали, что неинвазивные методы могут приближаться к качеству, которое раньше считалось достижимым только после операции на мозге аля Neuralink.

Итак, Brain2Qwerty v2:

– Система основана на Brain2Qwerty v1. Но, в отличие от первой версии, v2 восстанавливает текст без знания момента каждого нажатия клавиши. Она получает непрерывный поток мозговой активности и сразу генерирует предложение целиком.

– Внутри задача разбита на три уровня: есть энкодер, который преобразовывает сырые сигналы MEG в отдельные символы. Дальше эту последовательность обрабатывает Aligner: он пытается понять, где начинаются и заканчиваются слова и строит их эмбеддинги. Далее эти эмбеддинги вместе с исходными сигналами отправляются в LLM, и она уже правит все в конечный вид.

– Выглядит это все как огромная установка стоимостью в миллионы долларов.

Точность относительно предыдущих методов, можно сказать, зашкаливает. Заявляется 61% word accuracy в среднем (около 70% на лучших участниках). При этом система может допускать больше символьных ошибок, чем первая версия, потому что не знает времени нажатия клавиш, но смысл оказывается намного ближе к оригиналу.

И да, это все еще слишком низкая точность для массового применения. НО (и это самое интересное!) исследователи открыли почти идеальный scaling law. Качество продолжает улучшаться почти логарифмически с увеличением объема данных, и насыщения пока не видно.

Так что возможно все, что нужно для очень точного неинвазивного чтения мыслей – это больше данных. В удивительное время живем.

facebookresearch.github.io/brain2qwerty/
  • 🤯 174
  • 🔥 53
  • ❤ 22
  • 👍 9
  • 👏 3
  • 😁 3
  • 💯 1
  • 🤗 1
Post #9453 24.7K
Дарио Амодеи заявил, что опенсорс в ИИ – это «отвлекающий маневр»

Он сказал, что на самом деле это не тот опенсорс, к которому мы привыкли:

«Вы все равно не можете видеть внутренности модели, и основные плюсы опенсорса вроде коллективной доработки работают с сфере ИИ иначе»


Основной аргумент:

«В итоге вам все равно придется хостить ее в облаке»


В довершении CEO Anthropic заявил, что для конкуренции важнее способности модели и ее эффективность на инференсе, а не «ярлык» опенсорса и лицензия.

Мнения? 😐
  • 🗿 293
  • 😁 131
  • ❤ 16
  • 👍 9
  • 🔥 5
  • ☃ 3
  • 🤨 2
  • 🕊 1
  • 😎 1
Post #9451 30.2K
Правительство США дропнуло новый бенчмарк для LLM ⚡️
  • 😁 760
  • 👍 45
  • 🔥 31
  • ❤ 12
  • 🗿 12
  • ☃ 5
  • 🫡 5
  • 😍 3
  • 🕊 2
  • 🐳 2
  • 🍓 2
Post #9450 27.3K
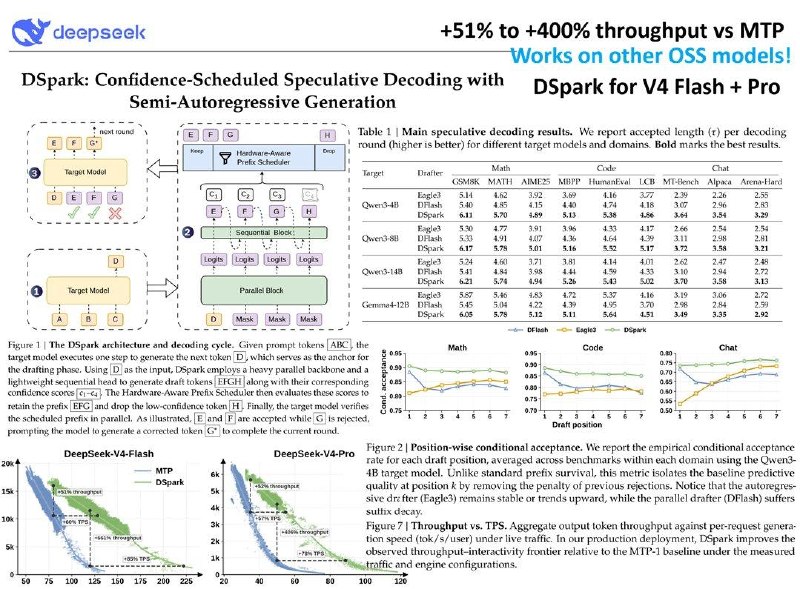
Новый дроп от DeepSeek: выложили полностью открытый стек для ускорения генерации LLM

Внутри готовые алгоритмы, обучение, эвал и даже пайплайн для данных. Бери и пользуйся, супер практично. github.com/deepseek-ai/DeepSpec

Основная соль – в алгоритме DSpark. Его DeepSeek уже использует для DeepSeek-V4 Flash и Pro в проде, и, по их данным, относительно старого бейзлайна скорость генерации для пользователя выросла примерно на 60–85%.

Как устроен алгоритм:

– Фундаментально, это небольшая модель, которая пишет черновики для основной LLM. Это называется драфт-модель.

– Такой подход сейчас в моде (Google, например, делают такое для Gemma: t.me/data_secrets/9179), но DeepSeek выводят его на новый уровень. Их драфт-модель работает необычно, в два этапа. Сначала параллельно набрасывается блок токенов, а потом легкий марковский модуль уточняет зависимости между соседними токенами. Благодаря такому подходу драфтер и работает быстро, и не очень сыпится в хвостах.

– После того, как драфтер накидал черновик, основная LLM его проверяет и принимает только правильный префикс, корректируя остальное. При этом DSpark сам решает, сколько токенов отправить на проверку, основываясь на оценках уверенности по токенам и текущей нагрузке на железо.

В результате получаем ускорение минимум в 1.5 раза абсолютно без потери качества. Снимаем шляпу перед DeepSeek за такой опенсорс.
  • ❤ 264
  • 🔥 84
  • 👍 43
  • 👏 4
  • 😁 3
  • 🕊 3
  • 🤨 2
  • 🍾 2
  • 🤗 2
Post #9449 26K
Обновление по Fable и Mythos:

С 12 июня мы тесно сотрудничаем с правительством США, чтобы восстановить доступ к Claude Mythos 5 и Fable 5. Сегодня правительство уведомило нас, что мы можем повторно развернуть Mythos 5 для некоторых организаций США, которые управляют и защищают критическую инфраструктуру.

Мы быстро восстанавливаем доступ для этих организаций, и мы продолжаем работать с правительством, чтобы расширить доступ к Mythos 5 и снова сделать Fable 5 доступным для общего использования.


Честно говоря, пока не слишком обнадеживающе
  • 🕊 33
  • 😁 20
  • 🤔 15
  • 👍 4
  • 🎉 3
  • 🫡 3
  • 😎 2
  • 👏 1
  • 🆒 1
Post #9446 30.6K
Итак, встречайте: GPT-5.6

https://openai.com/index/previewing-gpt-5-6-sol/

Анонсировали три модели, в честь солнечной системы (с самооценкой у создателей все ок):

1. Sol – самая крупная и крутая. На многих бенчмарках обходит Mythos, и при этом дешевле в два раза. При этом авторы пишут, что модель использует в три раза меньше токенов. В целом экономия в 5-6 раз (ну типа).

2. Terra – промежуточный вариант. Уже в три раза дешевле Mythos, уверенно обходит Opus 4.8.

3. Luna – самый дешевая и быстрая, но по результатам все еще хороша.

Бенчмарков показали маловато, так что на другие замеры еще посмотрим. Общий доступ обещают в ближайшие недели, пока что модели вышли только для ограниченной группы тестеров.

Хоть бы не повторилась история с Fable 🙏
  • ❤ 175
  • 🔥 70
  • 👍 27
  • 🤯 13
  • 😁 5
  • ❤‍🔥 4
  • 🍾 4
  • 🤔 2
  • 🍓 1
Post #9445 26.1K
Оранжевый – доля токенов американских моделей в OpenRouter
Серый – доля китайских

Сверху разбиение в июне 2025, снизу – в июне 2026

И кто тут теперь техно-лидер? ⌨️

* из статьи Bloomberg
  • ⚡ 175
  • 😁 89
  • 🤯 34
  • 👍 16
  • ❤ 10
  • 😍 6
  • 🗿 6
  • 🏆 5
  • 💯 2
  • 🎄 2
Post #9444 27.5K
Они добрались до OpenAI: правительство США будет одобрять доступ к GPT-5.6 «клиент за клиентом»

Администрация Трампа связалась с Альтманом и «попросила» его не выпускать модель без одобрения. Конечно же, «по соображениям безопасности».

Так что модель сначала выйдет в ограниченном preview, и только когда-нибудь потом (возмооожно) станет доступна простым смертным: во время периода превью чиновники будут «одобрять доступ клиент за клиентом» (цитата Сэма).

Лицензирование де-факто
  • 🫡 170
  • ❤ 28
  • 🗿 19
  • 😁 10
  • 🤯 7
  • 🤗 7
  • 🤔 4
  • 😍 2
  • 😎 2
  • 🕊 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →