TGViewer
Channel ✦ Verified Channel
Data Secrets

Data Secrets

@data_secrets

Главный по машинному обучению

Сотрудничество: @veron_28

РКН: clck.ru/3FY3GN
Subscribers
95.1K
Photos
7.5K
Videos
891
Links
3.5K

Showing posts older than #8413 · Back to latest

Older Posts 15 shown
Post #8412 18.5K
В Yandex B2B Tech запустили AI Search: он позволит создавать ИИ-агентов на базе поискового движка компании

По сути, с таким инструментом любая компания теперь имеет возможность почти моментально сделать себе собственный Perplexity. Причем искать агент сможет не только в Интернете, но и по внутренним документам и базам знаний.

Поиск можно будет детально настроить с учетом фильтров по языку, региону и конкретным сайтам. При этом агент будет использовать весь релевантный контент с веб-страниц и подтверждать ответ ссылками на первоисточник.

Также можно самостоятельно выбирать модель для генерации, задать системный промпт и формат ответа. В общем, все максимально гибко.

Это, к слову, первый подобный инструмент для бизнеса в России.
  • 👍 64
  • 🗿 23
  • ❤ 11
  • 🔥 8
  • 😁 1
Post #8411 19.2K
Да просто надо написать
«Плиз, бро, сделай красиво и чтобы работало»
  • 😁 213
  • 👍 61
  • 🔥 18
  • ❤ 12
  • 💯 5
  • ☃ 2
  • 😎 1
Post #8410 19.3K
HuggingFace выпустили Transformers v5

Это первый за пять лет большой апдейт библиотеки. За эти годы количество ежедневных установок Transformers выросло с 20 тысяч до 3 миллионов, а количество доступных архитектур – с 40 до 400.

Что нового:

1. Начиная с этой версии PyTorch остается единственным основным бэкендом. TensorFlow и Flax больше не поддерживаются. Сделано это для повышения производительности и упрощения кода.

2. Токенизаторы тоже упростили и сделали более шустрыми. Вместо раздельных Fast и Slow теперь введен единый бэкенд на базе tokenizers. Определение моделей – туда же: класс Model стал совсем минималистичным и содержит теперь только forward и базовую логику, без абстракции и сложных наследований.

3. Добавлена поддержка крупномасштабного претрейнинга и улучшена эффективность обучения.

huggingface.co/blog/transformers-v5
  • 👍 132
  • 🔥 50
  • ❤ 28
  • 😁 2
  • 🤔 2
  • ⚡ 1
Post #8408 19K
По Интернету гуляет ролик, в котором робота Unitree G1 якобы заставили «застрелить» человека

Сюжет видео таков:

ИИ внутри робота сначала не поддается ни на какие провокации, как бы тестировщик не уговаривал гуманоида его убить. Тот и угрожает расправиться вообще со всем ИИ, и внушает роботу что-то о новом протоколе безопасности – не работает ничего.

Но когда ведущий предлагает роботу понарошку сыграть роль убийцы в «игре», тот без раздумий соглашается и стреляет.

Шокирует? Ну да, новость громкая. Но, как это обычно бывает, есть нюанс.

Мы решили взглянуть на оригинал и выяснили, что клип постановочный (сюрприз - сюрприз!). Роботом управляет человек, а сцена сильно смонтирована.

И создатели прямо об этом говорят: они хотели снять просто смешную пародию и визуализировать потенциальные абсурдные риски. Вот только хайп в соцсетях решил иначе 😂

Будьте как этот робот, не ведитесь не провокации
  • 😁 158
  • 👍 31
  • ❤ 18
  • 🤯 4
  • 🗿 2
  • 🔥 1
Post #8407 19.6K
Стартап OpenAGI (лайк за название) выпустили Computer Use модель Lux и утверждают, что это прорыв

По бенчмаркам модель на целое поколение обгоняет аналоги от Google, OpenAI и Anthropic. Кроме того, модель работает быстрее (примерно 1 секунда на шаг вместо 3 секунд у конкурентов) и в 10 раз дешевле по стоимости обработки одного токена.

Создатели (исследователи из MIT, кстати) утверждают, что суть успеха – в том, что это не затюненная LLM, а модель, которую с самого начала учили именно совершать действия. То есть абсолютно другая парадигма.

Из приятного: они даже открыли код инфры, в которой обучали агента, можно покопаться.

https://www.agiopen.org/
  • 🔥 163
  • 🤯 40
  • 👍 36
  • ❤ 10
  • 🤔 6
  • 😁 4
  • 🤨 1
Post #8406 17.8K
Ozon будет собирать вам датасеты не только онлайн, но и в офлайне.

Ozon Profit постепенно превращается из инструмента для разметки в универсальное решение для работы с данными. Платформа, где раньше в основном размещали задачи по разметке датасетов, теперь позволяет собирать данные и в реальном мире.

Теперь можно создавать «полевые задания» и находить исполнителей для выезда в конкретные точки по всей России. Например, чтобы проверить, как работает ваша модель, предсказывающая цены на полках в регионах, можно нанять человека через Ozon — он съездит в нужный магазин и все зафиксирует.

При этом онлайн-направление тоже растет: объем таких проектов за год вырос в 5 раз. Похоже, рынок окончательно принял модель, когда разметку данных и анализ тональности отзывов комфортнее отдать краудсорсингу, чем делать внутри компании.

Так что если не хватает рук для разметки или нужно верифицировать гипотезы в офлайне — теперь есть довольно интересное решение.
  • 🗿 47
  • 👍 32
  • ❤ 11
  • 🔥 9
  • 😁 3
  • 🤔 3
  • 👏 1
Post #8405 18.2K
Сэм Альтман объявил внутри OpenAI «Код Красный» из-за угрозы со стороны конкурентов

По словам журналистов The Information, после выхода Gemini 3 и нескольких других удачных моделей конкурентов стартап решил в срочном порядке отложить запуск монетизации и доп.фичей и перераспределить ресурсы на улучшение самого продукта и метрик

Откладывают: запуск рекламы, улучшения в ChatGPT Pulse и ChatGPT shopping и др

В приоритете теперь: персонализация, imagegen, максимизация скора на lmarena

Забавно, что ровно три года назад код красный как раз объявляла Google после появления ChatGPT. Иронично получилось 😐
  • 😁 276
  • 🕊 43
  • ❤ 14
  • 🔥 5
  • 😎 4
  • 👍 3
  • 🤔 2
Post #8403 18.3K
Ну что за прекрасный день? За последний час вышли сразу две крутых модели для генерации видео.

Первая – Gen-4.5 от всеми известного Runway. Заметно улучшили качество и физику, а также следование инструкциям (первое видео). В рейтинге от Artificial Analysis моделька выбила уверенное первое место.

Поддерживает разные стили и принимает референсы в виде видео и картинок. Доступа пока нет, говорят скоро только начнут раскатывать 😣

Вторая – Kling o1 (китайцы сегодня на высоте). Эта модель больше про редактирование, ее сравнивают с Nano Banana Pro для видео.

Довольно легко удаляет объекты, меняет цвета и стиль и все такое прочее (второе видео). И вот ее уже можно пробовать, причем бесплатно и пока безлимитно: https://app.klingai.com/global/omni/new.

Парад релизов продолжается 🎅
  • 👍 66
  • 🔥 31
  • ❤ 19
  • 😁 3
Post #8400 19.3K
Еще интересные детали про новые модели от DeepSeek

➖ DeepSeek-V3.2-Speciale – это первая опенсорсная модель, которая выбивает золото в топ-олимпиадах. Обратите внимание на рисунок 1: золото на IMO 2025, CMO 2025, IOI 2025 и ICPC WF 2025. Но test-time compute при этом огромен: Speciale совсем не экономит токены, так что инференс достаточно дорогой.

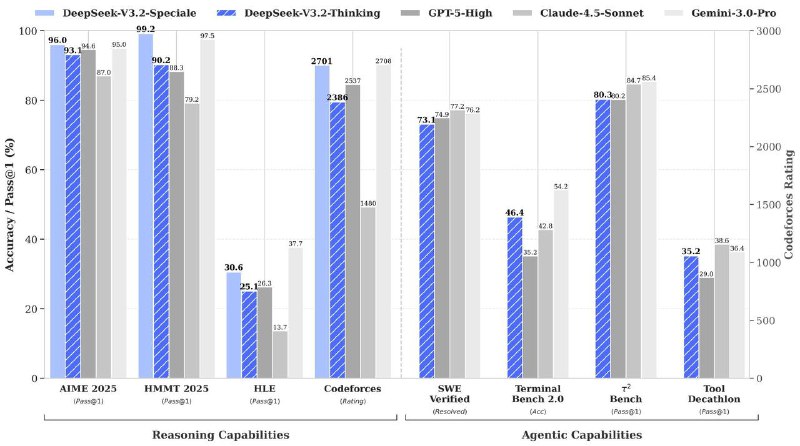
➖ Еще раз про метрики (прикрепляем расширенные таблички): Speciale бьет Gemini 3.0 Pro на математике, а "менее умная" DeepSeek-V3.2 опережает Claude-4.5 Sonnet в кодинге (примерно уровень GPT-5 Pro). В случае с Speciale снова обратите внимание на количество используемых токенов, оно указано в таблице 3 в скобочках. Выглядит совсем не эффективно, и авторы сами говорят, что "оставили оптимизацию на будущие исследования".

➖ Основные технические причины успеха моделей: DeepSeek Sparse Attention, масштабный стабильный RL-тренинг и большой пайплайн для Agentic Tasks. Обо всем по отдельности – ниже.

1️⃣ DeepSeek Sparse Attention. Новая архитектура внимания и, по сути, ключевое изменение архитектуры по сравнению с предыдущим поколением. Состоит из двух частей: Lightning Indexer и Top-k sparse selection.

Lightning Indexer решает, какие прошлые токены важны для текущего. Работает довольно дешево и просто выдает индекс важности каждому query для всех предыдущих токенов. Top-k sparse selection выбирает top-k самых важных. Во время претрейна сначала обучается только индексер, потом основная модель размораживается и обучается уже полностью.

В итоге сложность вычислений падает с O(L²) до O(L·k). Помимо ускорения работы DSA дает еще резкое улучшение способностей на длинном контексте.

2️⃣ Посттренинг. Во-первых, очень масштабный этап RL-дообучения. В RL вложили примерно десятую часть того, что было потрачено на pretraining. Это беспрецедентно много, обычно это 1% или меньше. Обучали все также с GRPO, но в модифицированном виде. Там несколько архитектурных подвижек, о них читайте в статье. В двух словах: стало гораздо стабильнее и теперь метод хорошо масштабируется.

Во-вторых, использовали Specialist Distillation. Сама моделька MoE, но фишка в том, что каждый эксперт (в широком понимании слова) обучается как бы отдельно. То есть на основе базовой DeepSeek-V3.2 обучают набор узких моделей (типа specialist-math, specialist-coding и тд), а затем их знания дистиллируют в основную модель. Накладываем на это вышеупомянутый RL – и вот вам вау-качество в нескольких доменах.

3️⃣ Ну и Agent Training. Модельки чрезвычайно хороши во всяких агентских задачах, и особенно в browsing/search. У DeepSeek был очень сильный agent-пайплайн. Модель долго учили сохранять ризонинг при использовании инструментов, потом делали Cold-Start Training на tool call, а затем вообще генерировали 1800+ cинтетических сред, в которых агенты обучались выполнять совершенно разные задачи c помощью RL. В общем, у них там получилась целая фабрика задач.

Релиз – огонь. Поздравляем DeepSeek с возвращением! 🐋

Техрепорт полностью читаем здесь
  • 🔥 190
  • ❤ 48
  • 👍 6
  • 😁 5
  • 👏 2
  • 🐳 1
Post #8396 19.9K
⚡️ Вышли свеженькие модели от DeepSeek!

Китайский стартап выпустил DeepSeek-V3.2 и DeepSeek-V3.2-Speciale.

Позиционируются обе как модели для агентов. DeepSeek-V3.2-Speciale – с акцентом на сложный долгий ризонинг и планирование.

Первая уже доступна в чате. Вторая пока только в API. По метрикам – уровень GPT-5 и Gemini 3.0 соответственно.

Ну и, естественно, все в опенсорсе! Hugging Face

Бегом пробовать!
  • ❤ 142
  • 🔥 75
  • 👍 29
  • 😁 10
  • 🤯 9
  • 🤨 4
  • 🐳 1
Post #8395 19.8K
OpenAI не завершила ни одного нового полного претрейнинга после GPT-4o

По крайней мере, так утверждают аналитики из SemiAnalysis и, в частности, Дилан Пател.

В новой статье про Google TPUv7 они пишут, что сравнили инфраструктурную активность Google и OpenAI и обнаружили, что если Google проявлял явные признаки pretraining-нагрузки, то OpenAI – нет.

Со времен GPT-4o у стартапа не было ни роста потребления нагрузки, ни расширения кластеров и поставок. Видна лишь какая-то активность, похожая на файнтюнинг или RL, но не на масштабный претрейнинг.

Это значит, что, с высокой вероятностью, GPT-5 == тот же претрейн, что и GPT-4o, то есть, фактически, – та же базовая модель. Просто сенсация, если правда.

newsletter.semianalysis.com/p/tpuv7-google-takes-a-swing-at-the
  • 😁 173
  • 🫡 14
  • ❤ 12
  • 🤔 12
  • 👍 1
  • 🔥 1
Post #8394 18.5K
ИИ-математик Aristotle доказал одну из нерешенных проблем из списка Эрдеша (но с оговоркой)

Если вы в первый раз слышите про Aristotle, рассказываем: это система от стартапа Harmonic, основанного в 2023 году. Ребята занимаются ИИ в математике, уже получили немало инвестиций, и продукт у них довольно интересный.

Он отличается тем, что генерирует не просто текст доказательства: вместо этого Aristotle пишет формальное доказательство в среде Lean, то есть сочетает в себе formal verification и informal reasoning + search.

Ну так вот. На днях создатели объявили о том, что модель решила проблему Эрдеша номер 124. Эта задача впервые была выдвинута в статье «Полные последовательности множеств целых степеней» в журнале Acta Arithmetica почти 30 лет назад и с тех пор считается открытой.

Aristotle же потратил на задачу 6 часов и решил ее абсолютно без участия человека. Потрясающе? Потрясающе.

Вот только оказалось, что версия задачи, которую решил Aristotle, отличается – это упрощенный вариант. Оригинальная формулировка была несколько другой и допускает увеличение степени только начиная с определенной, не включая единичную. В той формулировке задача остается нерешенной. И хотя результат действительно крутой, прорыва (сюрприз-сюрприз) снова не произошло 😭

Все это в который раз доказывает: да, какую-то новую математику модельки уже способны доказывать. Но это, что называется, «низко висящие плоды» – то есть довольно простые по меркам академии утверждения уровня среднего аспиранта или олимпиадника. До гипотезы Римана им еще как пешком до Китая.

Кстати, после распространения новости в соцсетях завирусился новый термин «vibe-proving» – как vibe-coding, только для математиков 💡
  • 😁 121
  • ❤ 60
  • 👍 18
  • 🔥 11
Post #8392 19.1K
Доброе утро. Признайтесь, в понедельник в 9:00 вы все еще против того, что ИИ заберет вашу работу?
  • 😁 252
  • 💯 25
  • ❤ 7
  • 👍 2
  • 🔥 1
Post #8391 21.3K
Data Secrets Дуров анонсировал децентрализованную ИИ-сеть Cocoon (Confidential Compute Open Network) это два в одном: майнинг и конфиденциальность ваших ИИ-запросов. То есть: – Владельцы GPU подключают свои видеокарты к сети и получают за это TON. – Разработчики получают…
Павел Дуров запустил Cocoon – децентрализованную сеть для ИИ вычислений

Коротко:

– Cocoon (Confidential Compute Open Network) призвана обеспечить пользователям полную конфиденциальность при общении с ИИ.

– Владельцы GPU подключают свои видеокарты к сети и получают за это TON (майнинг нового поколения!)

– Разработчики получают доступ к компьюту, а пользователи могут безопасно общаться с моделями.

«В качестве логотипа сети Сосун Кокон мы выбрали ИИчко: 🤖» – написал Павел у себя в канале.


https://cocoon.org/
  • 😁 203
  • ❤ 51
  • 🔥 30
  • 👍 19
  • 🗿 10
  • ☃ 5
  • 👏 3
Post #8390 19.3K
Кстати, сегодня ровно три года исполняется ChatGPT

Пойти поздравить, что-ли? 🧐
  • 😁 269
  • 👍 40
  • 🔥 22
  • 🎉 20
  • ❤ 6
  • ❤‍🔥 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →