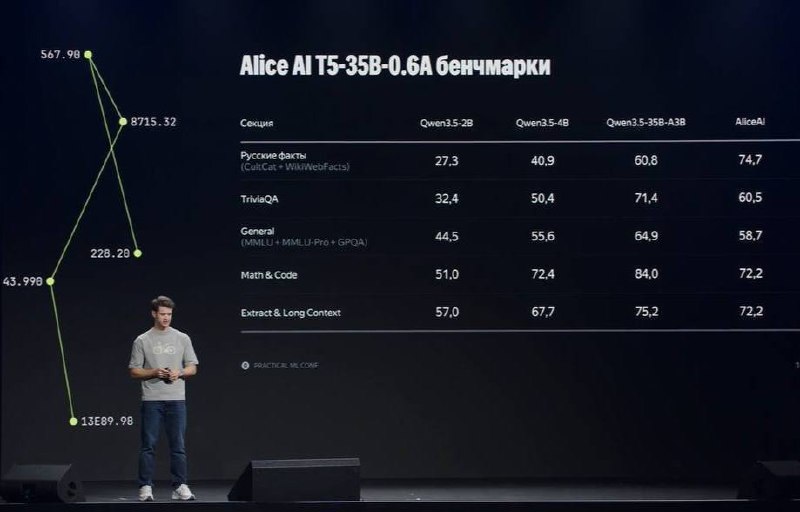
На этой неделе Яндекс опенсорснул Alice AI‑T5-35B‑A0.6B. Это обученная с нуля претрейн модель, которая отвечает за быстрые ответы на Поиске.
Только что на Practical ML Conf мы слушали про этот релиз из первых рук: Артур Петросян, CTO Alice AI Search, рассказал о том, как команда обучила систему, которая дала +0.34% к продуктовой метрике Sessions Per User и в 56.7% случаев выигрывает в попарных сравнениях против Google AI Overview.
— Одна из главных интересных особенностей этой модели – ее архитектура. Это Encoder‑Decoder + MoE. Последние такие модели выходили в 2021–2023 годах (не считая недавнего DeepSeek-V4.1-Flash, который вышел почти в один день с Alice AI‑T5), так что выбирать такую архитектуру было довольно необычным и рискованным решением.
Не обошлось без сложностей при разработке: например, на претрейне сколлапсировал роутинг в энкодере, и пришлось сменить схему балансировки экспертов. Зато архитектура себя оправдала. Энкодер один раз читает длинный контекст из документов, а легкий декодер быстро пишет короткий ответ, что идеально для задачи «много на входе, мало на выходе». MoE при этом дает знания уровня 35B параметров при вычислениях как у 0.6B.
— После претрейна с моделью также колдовали с помощью SFT и RLHF. На этих этапах модель училась писать ответ так, чтобы он был максимально полезен для живого пользователя. Интересно, что при этом команда обошлась без эталонных ответов, написанных людьми: на запрос генерировалось много ответов от разных систем, лучший отбирался автоматически по набору сигналов качества, а на этапе RL модель дополнительно училась на сигналах реального поведения пользователей Поиска.
— Еще одна интересная деталь пайплайна – сжатие контекста. Чтобы не гонять через LLM огромные пачки документов, команда с нуля обучила маленькую BERT‑подобную модель на 80 млн параметров, которая занимается тем, что определяет релевантность каждого токена запросу. Далее поверх этого накладывается метод под названием Cross‑Entropy RL, и в итоге получается экстрактор, который понимает, какую именно информацию модель уже знает из весов, и какой минимальный контекст ей нужен для хорошего ответа.
И да, все это – только некоторые детали работы. Про остальные нюансы обучения и строения системы можно почитать вот в этой статье на Хабр. Поздравляем команду с релизом!
Post #9959
17.9K


- 👍 139
- 🗿 51
- 😁 30
- ❤ 28
- 🔥 13
- 🤨 3
- 🍓 3
- ☃ 2
- 👌 2
- 👏 1