
Google перепридумали квантование: их алгоритм TurboQuant может стать новым стандартом эффективности LLM
В современных моделях проблема памяти не только в числе параметров, но и в том, что модель постоянно таскает за собой огромное количество векторов – в KV-cache для длинного контекста и в индексах vector search для RAG. Именно они тормозят модель и делают инференс дорогим. Можно квантовать векторы (то есть уменьшать битность вычислений), но тогда модель теряет в качестве.
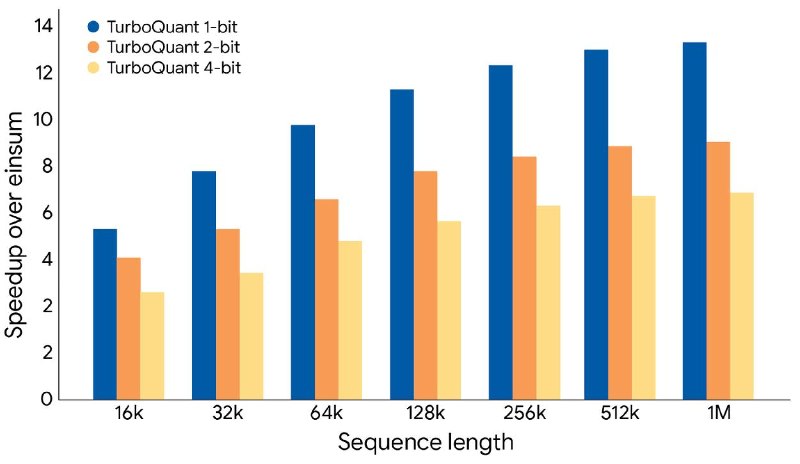
Google придумали, как сжимать умнее: не просто округлить числа погрубее, а сделать это так, чтобы модель почти не замечала потери точности. Для практики это означает три вещи:
1. Длинный контекст становится дешевле
2. Инференс на том же железе ускоряется
3. Vector search по огромным базам становится компактнее и быстрее
Технически метод TurboQuant состоит из двух слоев. PolarQuant сначала преобразует вектор через случайное вращение так, чтобы его можно было эффективно сжать с минимальными служебными затратами – именно за счет этого происходит основное сжатие без потери смысла. Затем QJL (Quantized Johnson-Lindenstrauss) добавляет сверхдешевую коррекцию ошибки, кодируя остаток всего одним дополнительным битом на компоненту. Это помогает еще точнее восстановить attention score с минимальной нагрузкой на вычисления.
В экспериментах TurboQuant показывает лучший баланс между искажением скалярного произведения, recall и размером KV-cache – его удалось квантануть аж до 3 бит без дообучения и без компромисса по точности. В статье подчеркивается, что значения близки к теоретическим нижним границам, то есть это почти оптимум.
Очень сильная инфрастуктурная работа. Google, как всегда, молодцы.
research.google/blog/turboquant-redefining-ai-efficiency-with-extreme-compression/
Post #8920
21.5K


- 🔥 217
- ❤ 52
- 👍 27
- ❤🔥 4
- ✍ 3
- 😁 3
- 🤝 1
- 🫡 1