Google релизнули фичу Agentic Vision для Gemini 3 Flash
По сути, она превращает анализ изображений из статического процесса в динамический. То есть вместо «посмотри на изображение и ответь» модель теперь делает «посмотри на изображение, поработай с ним и ответь».
Конкретнее, отрабатывает цикл «Think-Act-Observe», то есть модель (1) анализирует изображение, думает и составляет план; (2) выполняет какой-то код для обработки изображения, всяких расчетов, детекции и тд; (3) обрабатывает результаты и добавляет в контекст новую информацию, которую использует для ответа.
Например, есть задача посчитать пальцы на руке. Модель не просто смотрит и отвечает «5», а детектит каждый палец (прямо с рамками), считает прямоугольнички и выдает ответ. Пример упрощенный, но передает суть: модель тут работает с картинкой, как бы делая из нее визуальный черновик для рассуждений.
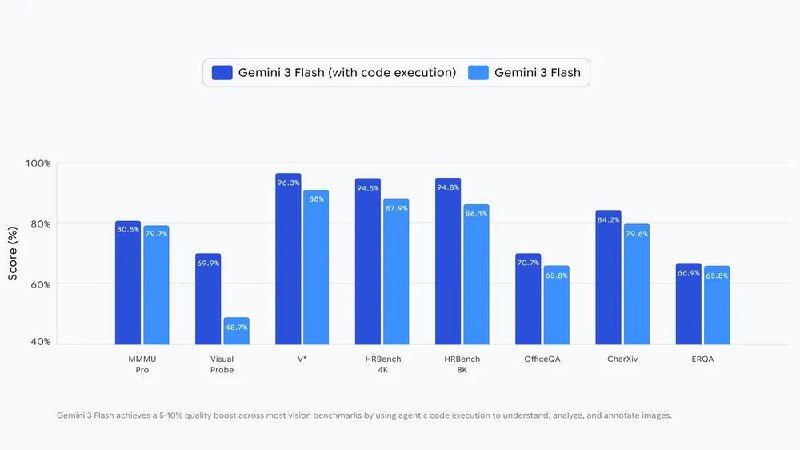
Лучше всего фича показывает себя, конечно, на всяких сложных таблицах и при работе с мелкими деталями. Прирост к метрикам относительно ванильной Gemini 3 Flash – в среднем примерно 5-10%.
Попробовать уже можно и в API, и в AI Studio
blog.google/innovation-and-ai/technology/developers-tools/agentic-vision-gemini-3-flash/
Post #8669
25.5K
- ❤ 112
- 👍 37
- 🔥 20
- ⚡ 5
- ❤🔥 1
- 👨💻 1