Помните стартап Prime Intellect? Ребята занимаются децентрализованным обучением и на днях впервые выпустили конкурентоспособную модель Intellect-3
Прошлая версия модели вышла в мае и была занятной (в частности потому что обучалась децентрализованно), но не на уровне frontier.
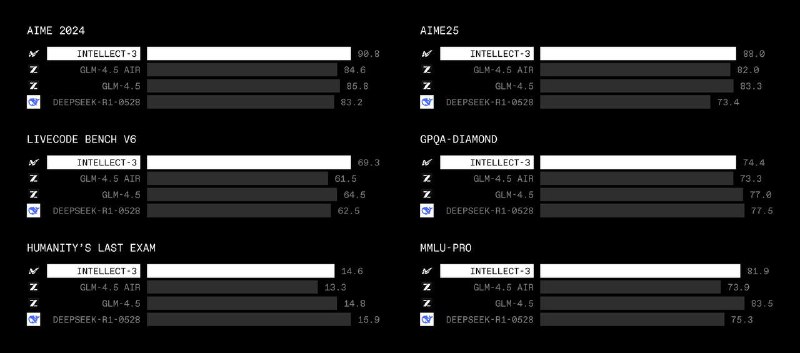
Теперь же по бенчмаркам Intellect-3 опережает GLM-4.5 и DeepSeek-R1-0528, а по математике вообще достигает SOTA в своем размере (она 106B MoE).
Что интересно: для RL-обучения использовался асинхронный RL-фреймворк prime-rl. С инженерной точки зрения это очень сложный процесс и PRIME единственные, кто сейчас таким занимаются. Но успех модели в целом доказал, что подход работает. В стартапе уверены, что именно такие инструменты – это путь к сильным децентрализованным моделям.
Prime-rl уже выложили в опенсорс, так что кому интересно, покапаться в нем можно здесь.
Репорт | HF | Блог
Post #8379
18K
Data Secrets Intellect-2 или как обучить ризонинг модель на 32В без кластера GPU Помните, примерно пол года назад мы рассказывали вам, как в стартапе Prime Intellect впервые децентрализованно обучили крупную LM? Так вот теперь исследователи пошли дальше и обучили уже…
- 🔥 82
- 👍 26
- ❤ 20
- 😁 2
- ☃ 1