
В Meta показали собственную вариацию механизма внимания: Multi-Token Attention
В стандартном multi-head attention внимание вычисляется посредством сравнения запросов (Q) и ключей (K) для каждого токена с каждым. Но если нужная информация распределена между несколькими токенами, такой подход приводит к тому, что модель может не суметь правильно её обнаружить.
А Multi-Token Attention – это атеншн со свертками: исследователи добавляют в классический подход key-query convolution и head mixing convolution.
В измерении ключей и запросов свертки помогают учитывать не один токен, а окно из нескольких рядом стоящих. Аналогично на уровне голов – после применения софтмакса головы не сразу домножаются на значения (V), а сначала миксуются в свертки и как бы обмениваются информацией. Схемы – на 1 и 2 картинках.
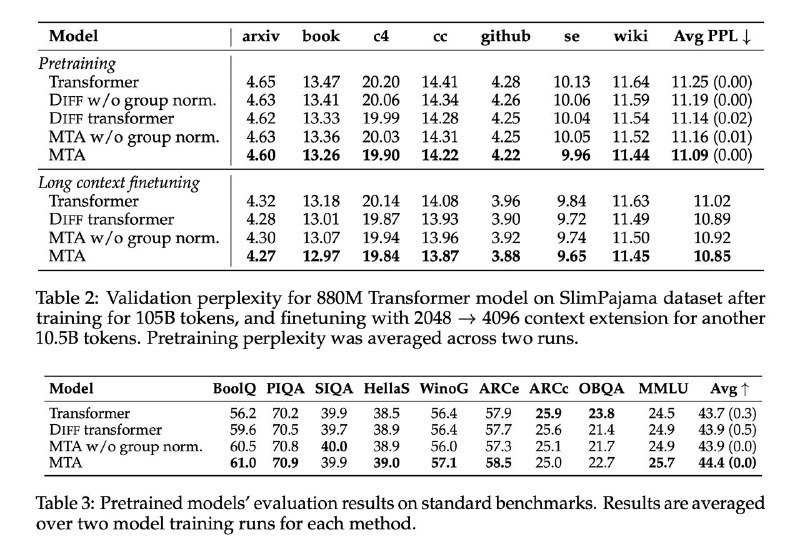
Работает ли это? Да, на валидационных срезах снижается и перплексия, и количество ошибок модели. Особенно это видно на задачах, где нужно аккуратно работать с контекстом, типа BabiLong (рис 4) и Needle-in-the-Haystack (рис 5).
Вычислительно напряжно, конечно, но все-таки идея интересная
arxiv.org/pdf/2504.00927
Post #6581
36.6K




- 👍 66
- ❤ 13
- 🔥 11
- 🤔 4