


Традиционное внимание очень прожорливо: вычисления масштабируются квадратично по мере увеличения длины последовательности. Это приводит к тому, что скейлинг трансформеров на реально длинное контекстное окно становится почти невыполнимой задачей.
В DeepSeek придумали разреженное внимание, NSA (Native Sparse Attention), которое как бы разбивает весь процесс на три параллельные ветви:
➖ Token Compression. Здесь все токены разбиваются на группы по L штук, и для каждой такой подпоследовательности вычисляются эмбеддинги. Так вместо обычных ключей и значений для внимания мы получаем сжатые, которые несут информацию о глобальных паттернах в последовательности (а не об отдельных токенах) при более низкой вычислительной нагрузке.
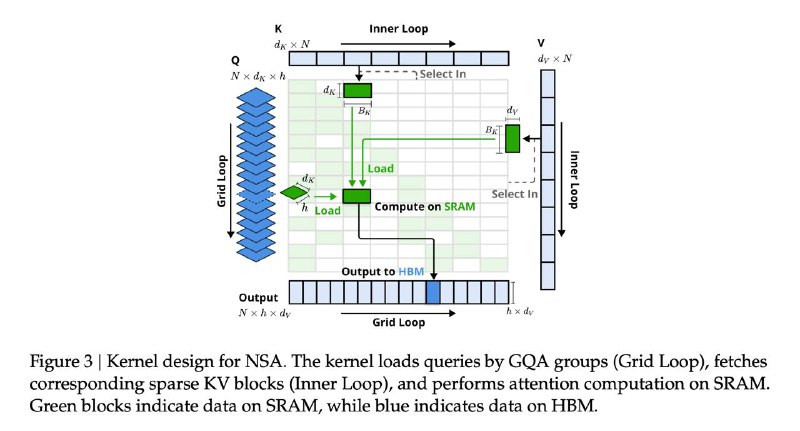
➖ Token Selection. Тут тоже происходит агрегация, но иначе. Последовательность также делится на группы токенов, из которых с помощью промежуточного внимания извлекаются n самых значимых. А уже затем, когда мы отобрали эти самые важные группы, из них берутся оригинальные токены и для них вычисляются признаки без компрессии.
➖ Sliding Window. Тут ничего нового, локальное внимание, которое отвечает за обработку самых недавних токенов в пределах фиксированного окна.
Получается, за счет Token Compression мы экономно сохраняем общие представления о последовательности, за счет Token Selection детально храним самую важную информацию из нее, а благодаря Sliding Window помним о локальных зависимостях и формулируем текст без языковых косяков.
Самое крутое: по результатам экспериментов NSA не только не уступает обычному вниманию, но и в ряде случаев превосходит его, особенно конечно в задачах с длинным контекстом (до 64 тыс. токенов).
При этом DeepSeek еще и предложили оптимизированные ядра и на них алгоритмом достигается прямо очень значительное ускорение: до 11,6х на декодировании и до 9х на прямом проходе.
arxiv.org/pdf/2502.11089 🔥