
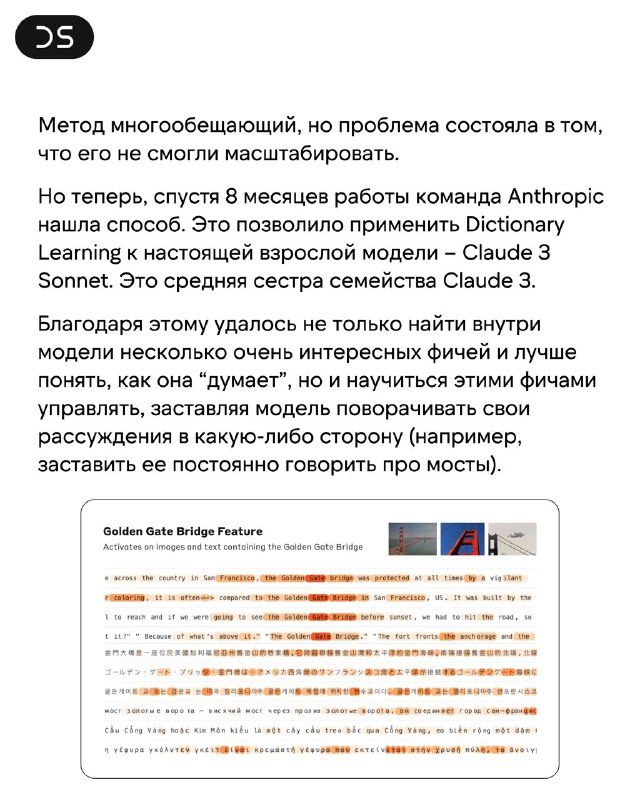
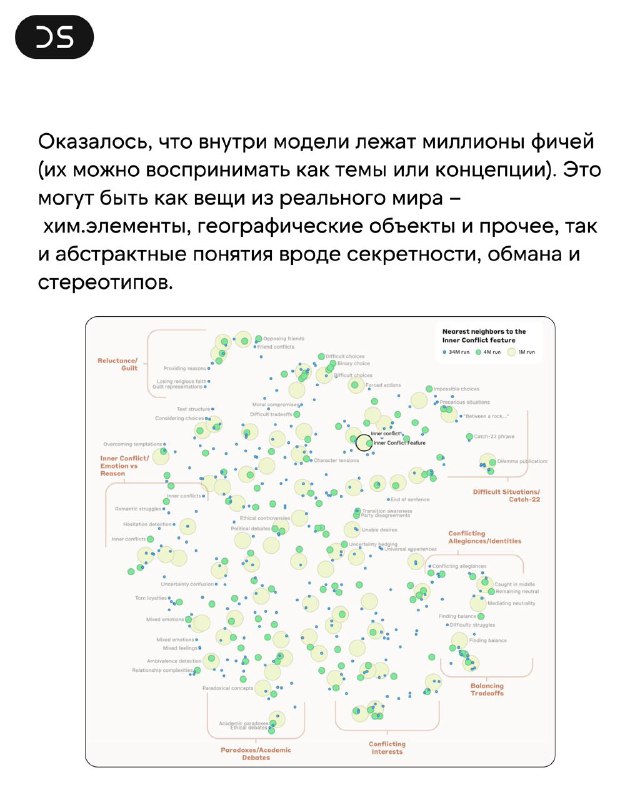
Что тут у нас? Это же новая громкая статья от Anthropic про интерпретируемость модели!
Исследование просто взорвало комьюнити: в нем выясняется, что, затюнив какие-то вполне конкретные фичи, мы можем заставить LLM всегда писать уязвимый код, генерировать фишинг и др. Как это работает – выясняем в карточках.
Подробнее: сочный блогпост с визуализациями, статья.
Post #4097
9.92K




- ❤ 56
- 🔥 21
- 👍 10