
Для обучения AI-моделей в дата-центрах устанавливают GPU. Но инференс — когда модель уже отвечает пользователю — устроен иначе, чем процесс обучения. Здесь важна скорость доступа к памяти и энергоэффективность.
Именно на нишу инференса делает ставку Qualcomm с портфелем чипов Dragonfly.
⏹️ Dragonfly C1000 — серверный CPU на архитектуре Oryon, более 250 ядер, частоты выше 5 ГГц. По расчётам Qualcomm, производительность на ватт вдвое выше конкурентов. Осуждаемая компания из прошлого поста уже договорилась использовать его в следующем поколении серверного парка. Старт коммерческих поставок запланирован на 2028 год.
⏹️ Dragonfly AI300 — акселератор инференса с технологией HBC Gen 2. Ожидаемая производительность: в 4–8 раз лучше по токенам на ватт по сравнению с GPU-архитектурами.
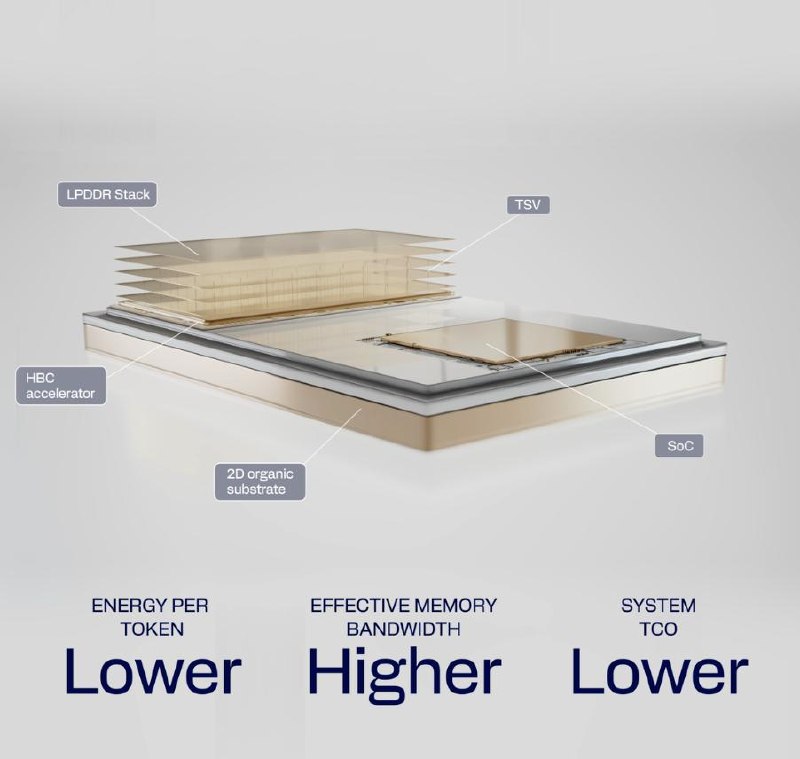
❗️ High Bandwidth Compute (HBC) — главное, чем Dragonfly отличается от конкурентов на уровне архитектуры.
В GPU-акселераторе процессор и память — это отдельные чипы, данные гоняются между ними по шине. Это быстро, но энергозатратно. HBM-память, которую используют NVIDIA и AMD, ускоряет этот обмен, но принцип остаётся прежним.
Qualcomm использует 3D-стек, где вычислительный блок размещается прямо под слоями памяти. Результат: в 6 раз больше по полосе пропускания на ватт, чем у HBM. Это буквально, как расположить склад и ПВЗ маркетплейса в одном здании.
Qualcomm даже не смотрит в сторону GPU-обучения, там доминирует Nvidia. Ставка сделана на инференс агентных AI-систем, где постоянные запросы к модели создают непрерывную нагрузку на память. Это быстрорастущий и пока незаполненный сегмент.
📈 Прогноз Qualcomm — $5 млрд выручки от дата-центровых чипов в 2027 финансовом году и $15 млрд к 2029 году. Если архитектура HBC подтвердит на практике заявленные цифры, у Qualcomm есть все шансы занять нишу экономичного инференса.
🕹️ Серверная