TGViewer
Channel Public Channel
Agentic Engineer

Agentic Engineer

@data_engi

Data Engineering Technologies.
SQL, Python, Kafka, Spark, Pandas, Airflow, Clickhouse, Greenplum, Postgres, dbt, LLM, Agentic systems, AI, robots, drones etc.

Boost channel - https://t.me/boost/data_engi
Subscribers
684
Photos
453
Videos
130
Links
747

Showing posts older than #1350 · Back to latest

Older Posts 20 shown
Post #1349 167
Голосование агентов заменили проверкой «от ответа к фактам» 🍴

10 сентября исследователи предложили новый способ разрешать споры между LLM-агентами. Проблема большинства и модели-судьи в том, что они рассуждают тем же путём — от входных данных к ответу — и часто повторяют общую ошибку.

Новый метод строит независимую обратную оценку: насколько вероятны наблюдаемые факты, если каждый из предложенных ответов верен.

Затем система:

🔘 сравнивает вывод каждого агента с обратной оценкой;
🔘 повышает вес наиболее согласованных вариантов;
🔘 объединяет прямое и обратное рассуждение в финальный ответ.

На случаях, где агенты расходились, метод обошёл лучшие варианты голосования на 1,2–4,7 процентного пункта для всех пяти протестированных LLM.

Для тебя здесь важен принцип: полезное разнообразие агентов — это не разные роли и промпты, а независимые способы проверки. Вместо ещё одного судьи можно добавить обратный проверяющий контур, который ищет согласованность ответа с исходными фактами.

Ограничения серьёзные: использовался один синтетический медицинский тест с закрытым набором ответов, одинаковая модель для всех агентов и только один раунд. Для открытых задач метод пока не проверен.

Пруф: исследование When Agents Disagree от 10 сентября 2026 года

#aiagents #multiagent #reasoning #llmevaluation #bayesianinference #agentarchitecture

@data_engi
arXiv.org When Agents Disagree: Bayesian Backward Reasoning as a Label-Free... When multiple LLM agents yield conflicting answers, the decision-making process dictates whether agent diversity improves performance or merely compounds shared errors. Existing collective...
  • ❤‍🔥 1
Post #1348 174
Станок за $400 млн решит, какими будут следующие ИИ‑чипы

14 сентября Reuters сообщил: крупнейшие производители чипов окончательно делают ставку на High NA EUV — новое поколение литографических машин ASML.

Такая установка печатает элементы примерно на 40% меньше, чем нынешние EUV‑системы, и позволяет разместить на той же площади почти втрое больше транзисторов. Цена вопроса — около $400 млн за один станок, вдвое дороже предыдущего поколения.

Intel уже обработала на High NA более миллиона кремниевых пластин. Samsung и SK Hynix планируют серийное производство с 2028 года, TSMC — с 2030-го. Обычные EUV‑машины ASML стоимостью $200 млн тем временем почти полностью распроданы до конца 2027 года.

Главный нюанс: конкурентов у ASML в передовой EUV‑литографии по-прежнему нет. Получается, скорость развития ИИ зависит не только от Nvidia — между идеей нового ускорителя и заводом стоит единственная европейская компания с аппаратом размером с автобус и ценой как у небольшого авиалайнера.

Пруфы:
🔘Reuters, 14 сентября
🔘ASML о High NA EUV
🔘Intel, 11 сентября

#asml #semiconductors #aichips #euv #hardware

@data_engi
Post #1347 572
Agentic Engineer 🖼️ PostgreSQL научился загружать Parquet через движок ClickHouse 8 сентября ClickHouse представила расширение chdb для PostgreSQL. Его модуль перехватывает команду COPY и импортирует или экспортирует данные напрямую через S3, GCS, Azure Blob, HDFS и HTTP.…
ClickHouse читает физический WAL PostgreSQL — без Kafka 😎

10 сентября ClickHouse открыла исходный код WalShadow — движка, который реплицирует PostgreSQL в ClickHouse непосредственно из физического WAL. Изменения декодируются вне исходной базы и записываются сразу в нативные блоки ClickHouse: без Kafka, JSON и логических слотов репликации.

В тесте авторов задержка от фиксации транзакции до появления данных составила около 200 мс против 10 секунд у PeerDB, а пропускная способность достигла 289 тысяч строк в секунду.

Для инженеров это перспективный способ получить почти моментальную аналитику с меньшей нагрузкой на PostgreSQL. Но проект пока имеет статус Development Preview: поддерживаются PostgreSQL 16–18, незапланированное переключение ведущего узла не работает, а изменения одной транзакции в разных таблицах могут стать видимыми не одновременно.

Пруфы:
🔘анонс ClickHouse от 10 сентября 2026 года,
🔘репо и список ограничений

#postgresql #clickhouse #wal #cdc #replication #realtimeanalytics #dataengineering

@data_engi
ClickHouse Introducing WalShadow: Sub-second Postgres replication to ClickHouse from physical WAL | ClickHouse WalShadow replicates Postgres data directly from physical WAL into ClickHouse, delivering around 200 ms latency and 289,000 rows per second in benchmarks.
  • ❤‍🔥 3
Post #1346 197
Дешёвая LLM отсеяла 47% вызовов сильной модели

10 сентября исследователи представили CAUC — каскад моделей без отдельного обучаемого маршрутизатора.

Сначала система калибрует уверенность каждой модели на проверочной выборке, чтобы значение вроде 0,9 означало примерно одинаковую вероятность правильного ответа. Затем запрос получает дешёвая модель:

🔘 если её уверенность достаточна, ответ принимается;
🔘 если нет — вызывается более сильная модель;
🔘 ответы объединяются, только когда ошибки моделей действительно дополняют друг друга.

При добавлении новой модели не нужно переобучать весь маршрутизатор: достаточно откалибровать её и обновить порог.

На шести языковых тестах CAUC пропустила около 47% вызовов сильной модели, одновременно повысив точность относительно её одиночного использования в среднем на 1,9%.

Вывод: каскад стоит строить не на сыром confidence, который у разных моделей означает разное, а на откалиброванной вероятности ошибки.

Ограничение существенное: эксперименты проводились на задачах с вариантами ответа и доступом к логитам. Стоимость считалась по размеру моделей, а не по реальным ценам и задержкам API.

Пруф: исследование CAUC от 10 сентября 2026 года

#llm #modelrouting #modelcascade #calibration #inference #llmops

@data_engi
arXiv.org Calibration-Aware Uncertainty Cascades for Efficient Heterogeneous... Heterogeneous model collaboration seeks to exploit the complementary strengths of different models to balance predictive performance and inference cost. Existing approaches typically rely either...
  • ❤‍🔥 1
Post #1345 186
Pub/Sub встроил вызов ИИ-модели прямо в поток данных

10 сентября Google сделала общедоступным AI Inference SMT. Pub/Sub теперь может отправить каждое входящее сообщение модели из Gemini Enterprise Agent Platform и добавить её ответ к исходным данным перед дальнейшей обработкой.

Так можно выполнять классификацию, поиск аномалий, анализ тональности или построение эмбеддингов без отдельного сервиса между брокером и моделью. Pub/Sub также регулирует частоту запросов, чтобы не перегружать модель.

Инженерам рекомендуют применять преобразование на подписке: при сбое модели Pub/Sub повторит доставку или отправит сообщение в отдельную тему для ошибок. Если поставить его на тему, недоступность модели приведёт к ошибке публикации. Есть и ограничения: один запрос к модели на сообщение, без пакетной обработки, с тайм-аутом 60 секунд; закрытые сетевые адреса моделей пока не поддерживаются.

Пруфы:
🔜 анонс Google Cloud от 10 сентября 2026 года
🔜 техническая документация

#googlecloud #pubsub #streamprocessing #realtime #datapipeline #machinelearning #dataengineering

@data_engi
Google Cloud Blog What’s new with Google Data Cloud | Google Cloud Blog Recent product news and updates from our data analytics, database and business intelligence teams.
  • ❤‍🔥 2
Post #1344 182
Скиллы AI-агента оптимизировали как многорукого бандита 😎

10 сентября исследователи представили COBRA-Skills — систему, которая улучшает инструкции-скиллы без полного прогона каждого варианта.

Каждый скилл считается отдельным «рычагом». Небольшая модель прогнозирует его полезность, а алгоритм LinearUCB добавляет приоритет перспективным, но ещё плохо изученным вариантам. Только победитель раунда запускается на реальном агенте.

Периодически система обновляет набор скиллов:

🔘 переписывает инструкции по успешным и провальным траекториям;
🔘 комбинирует удачные подходы;
🔘 удаляет слабые варианты;
🔘 добавляет новые направления поиска.

На шести бенчмарках и трёх моделях COBRA-Skills показала лучший средний результат среди сравниваемых методов. Стоимость оптимизации снизилась на 55–58% относительно SkillOpt, причём для каждого бенчмарка использовалось лишь 50 примеров.

Для тебя вывод: скиллы агента можно оптимизировать как ограниченный вычислительный бюджет. Не тестировать всё подряд, а направлять дорогие запуски туда, где ожидается польза или не хватает данных.

Пока это результаты авторов на бенчмарках, а не проверка в продакшене. Но код уже открыт под Apache 2.0.

Пруфы:
🔘исследование COBRA-Skills от 10 сентября 2026 года
🔘репозиторий проекта

#aiagents #agentskills #contextualbandits #llmops #agentoptimization #opensource

@data_engi
arXiv.org COBRA-Skills: Contextual Bandit-Guided Evolution for Agent Skill... Large language model (LLM) agents can benefit from reusable skills distilled from prior task experience, yet existing skill optimization methods often rely on costly execution-based evaluation and...
  • ❤‍🔥 1
Post #1343 185
👀Песочницы AI-агентов сжали в 8,7 раза, пока модели «думали» 😊😊😊

10 сентября исследователи HKUST представили AgentZip — систему сжатия оперативной памяти для параллельных агентных песочниц.

Такие песочницы обычно создаются из одного образа, открывают одинаковый репозиторий и запускают похожие команды. Даже к концу выполнения у них оставалось до 76% одинаковых страниц памяти.

AgentZip использует это тремя способами:

🔘 хранит изменения как разницу с исходным образом;
🔘 применяет общий словарь сжатия для родственных песочниц;
🔘 выполняет тяжёлое сжатие, пока песочница ждёт ответа LLM.

Нужные страницы система заранее восстанавливает перед следующим вызовом инструмента. В экспериментах расход памяти снизился до 8,7 раза против 2,1 раза у стандартных механизмов Linux. Замедление составило около 40%.

Для тебя вывод: при массовом запуске агентов первым может закончиться не GPU, а обычная RAM. Связанные песочницы стоит планировать как группу с общим образом и известными фазами ожидания, а не как полностью независимые виртуальные машины.

Ограничение: результаты получены при воспроизведении траекторий на десяти Python-репозиториях и одном KVM-сервере — это ещё не проверка на рабочей облачной платформе.

Пруф: исследование AgentZip от 10 сентября 2026 года

#aiagents #sandboxing #memorycompression #agentinfrastructure #linux #llmops

@data_engi
arXiv.org Memory Compression for High-Fanout Agent Sandboxes High-fanout agent workloads create a growing memory bottleneck because a single task may spawn many concurrent sandbox sessions. Yet these sandboxes are far from independent: they originate from a...
Post #1342 182
🌖 NASA и IBM выложили ИИ, который ищет лёд на Луне

10 сентября NASA и IBM открыли Lunar Foundation Model — модель, обученную на десятилетиях наблюдений за Луной. В неё собрали более 30 слоёв данных от девяти приборов с четырёх космических миссий.

ИИ отмечает перспективные залежи льда в вечно затенённых кратерах, картографирует места для безопасной посадки и распознаёт вулканические образования. В тестах точность оказалась до 23% выше, чем у распространённых методов.

Лёд здесь — не просто научная находка. Из него можно получать воду, кислород и ракетное топливо для лунной базы и дальнейших полётов к Марсу.

Важно: модель не доказывает наличие воды, а показывает, куда стоит отправить аппарат или исследовательскую группу. И ты можешь работать с ней сам — модель и объединённый лунный набор данных опубликованы открыто.

Пруф: Reuters, 10 сентября

#ai #nasa #spacetech #opensource #moon

@data_engi
Post #1341 190
🏢 Google собрала агента по данным из MCP-серверов и Markdown-скиллов

8 сентября Google представила Data Agent Kit — открытый набор инструментов для Codex, Claude Code, Cursor и других сред разработки.

Архитектура разделена на два слоя:

🔘 MCP-серверы дают доступ к BigQuery, Cloud SQL, Cloud Storage и другим сервисам;
🔘 редактируемые скиллы объясняют агенту, как искать данные, писать SQL, собирать dbt-модели и разворачивать конвейеры.

В демонстрации агент провёл расследование сразу по трём источникам, а затем превратил результат в dbt-проект. Ошибку с дублированием строк поймал обычный тест уникальности — после этого агент исправил модель и повторил сборку.

Для тебя здесь полезен архитектурный паттерн: инструменты отвечают за доступ и действия, скиллы — за правила работы, а корректность проверяют детерминированные тесты. Перед выполнением SQL среда запрашивает разрешение и сохраняет полный след вызовов.

Пока это предварительная версия до v1.0: возможны несовместимые изменения, а опубликованный сценарий — демонстрация, не сравнительный тест.

Пруфы:
🔘анонс Google Cloud от 8 сентября 2026 года
🔘репозиторий Data Agent Kit

#dataagents #mcp #agentskills #dataengineering #dbt #googlecloud

@data_engi
Google Cloud Blog Agentic analytics with the Data Agent Kit | Google Cloud Blog Data Agent Kit is a set of MCP servers and agent skills that helps data developers run data workflows from their IDEs. It’s available both as an extension for VS Code forks (Antigravity IDE, Cursor) and as a plugin for other tools (Antigravity 2.0, Antigravity…
Post #1340 197
Snowflake научил dbt проверять только изменённые модели 😗

10 сентября Snowflake сделала общедоступным Slim CI для встроенных dbt Projects. Система берёт артефакты последнего успешного запуска и с помощью state:modified+ проверяет только изменённые модели и их зависимости.

Режим defer подставляет готовые таблицы из production вместо повторной сборки неизменённых родителей. После сбоя можно перезапустить лишь ошибочные модели через result:error+. Отдельное хранилище артефактов при этом не требуется.

Для инженеров это более быстрые и дешёвые проверки pull request и восстановление пайплайнов без повторного выполнения уже успешных шагов. Нюанс: параллельным запускам нужны раздельные пути для артефактов и журналов, иначе они могут перезаписывать результаты друг друга.

#snowflake #dbt #slimci #cicd #dataops #dataengineering

@data_engi
Post #1339 203
Agentic Engineer Postgres превратили в переходник к ClickHouse Платформа недвижимости QuintoAndar перестраивает обработку 900 млн событий в месяц от 14 млн пользователей. Раньше горячие данные обслуживал PostgreSQL, а холодный контур круглосуточно сводился в Databricks. Теперь…
🖼️ PostgreSQL научился загружать Parquet через движок ClickHouse

8 сентября ClickHouse представила расширение chdb для PostgreSQL. Его модуль перехватывает команду COPY и импортирует или экспортирует данные напрямую через S3, GCS, Azure Blob, HDFS и HTTP. Поддерживаются Parquet, Arrow, ORC, Avro и десятки других форматов; схему таблицы можно вывести из файла автоматически.

chDB запускается отдельным вспомогательным процессом только на время запроса. Его сбой не затрагивает другие сессии PostgreSQL, а после завершения освобождаются все ресурсы.

Для тебя это лёгкий способ связать PostgreSQL с объектным хранилищем без отдельного ETL-сервиса. Но версия пока ранняя: каждый запрос изолирован, требуется PostgreSQL 15+, а ключи доступа к хранилищу нужно передавать явно.

Пруфы:
🔘анонс ClickHouse от 8 сентября 2026 года
🔘релиз chdb 0.1.1 в PGXN

#postgresql #clickhouse #chdb #parquet #objectstorage #etl #dataengineering

@data_engi
ClickHouse Introducing chdb Postgres extension: High-performance imports from cloud storage | ClickHouse The chdb Postgres extension brings fast imports and exports across cloud storage platforms and data formats, powered by the embedded ClickHouse engine.
Post #1338 198
Агенту дали мышь и терминал — шагов стало на 57% меньше

4 сентября исследователи представили CUA-Universe — среду, где агент управляет приложением через GUI и CLI, работающие с общим состоянием. Экран нужен для поиска и визуальной проверки, а точные и массовые изменения выполняются командами.

Система автоматически подготовила виртуальные среды и CLI-инструменты для 16 приложений — от Blender и GIMP до VS Code и LibreOffice. На 4 923 проверенных траекториях дообучили модель Qwen3.5-9B.

На OSWorld гибридный агент повысил успешность на 16,8 процентного пункта, выполняя на 57% меньше шагов и расходуя на 44% меньше токенов. Улучшение сохранилось и на OSWorld-MCP с другим, не встречавшимся при обучении интерфейсом инструментов.

Вывод: computer-use агента не стоит ограничивать кликами по пикселям. Дай ему единый слой действий: GUI — для визуальных задач, CLI или MCP — для точных и проверяемых операций.

Ограничения пока заметные: только Linux, сценарии внутри одного приложения, а код и данные авторы ещё лишь обещают опубликовать.

Исследование CUA-Universe от 4 сентября 2026 года

#aiagents #computeruse #guiagents #cli #mcp #agentarchitecture

@data_engi
arXiv.org CUA-Universe: A Scalable and Dynamic Environment for Hybrid GUI+CLI Agents Computer-use agents have advanced on benchmarks like OSWorld and AndroidWorld, but still act mostly through the GUI, often producing inefficient trajectories. Real-world computer work is hybrid,...
Post #1336 190
AWS покупает команду DuckDB, но не сам DuckDB 🦆

Amazon подписала соглашение о покупке DuckLabs — компании разработчиков DuckDB. Создатели базы Ханнес Мюлейзен и Марк Раасвелдт продолжат руководить проектом уже внутри AWS.

Сам DuckDB, а также DuckLake и Quack остаются собственностью независимого DuckDB Foundation, сохраняют лицензию MIT и прежнюю модель управления. AWS планирует теснее связать движок с S3, Athena, Redshift, EMR и Glue.

Задел уже есть: DuckDB используется внутри Amazon Quick, где его оптимизации помогли снизить среднюю задержку запросов на 30% при обработке более 2,5 млрд запросов.

Для инженеров это одновременно мощное ускорение развития DuckDB и риск усиления влияния одного облака. Главная страховка — код и интеллектуальные права остаются у независимого фонда.

#duckdb #ducklake #aws #database #analytics #opensource #dataengineering

@data_engi
DuckDB DuckLabs to Join AWS, Projects to Remain Open Source DuckLabs will join Amazon Web Services (AWS), which is expected to be effective in early September. The projects will remain open-source under the MIT license.
Post #1335 182
Агент может забыть прошлое после замены модели — даже если базу памяти не трогали 😊

Исследователи сравнили четыре способа хранения памяти: полную историю, RAG, сжатые моделью заметки и граф знаний с фиксированной схемой.

Когда заметки, написанные одной LLM, передали другой, точность изменилась на +9,9 пункта в одном направлении и на −13,3 в обратном. Усреднение показало бы почти нулевую разницу, скрыв поломку конкретной миграции.

Ещё опаснее смешивание эмбеддингов. Старый и новый энкодеры выдавали векторы одинаковой размерности — 1024, поэтому база продолжала работать без ошибок. Но индекс с половиной старых и половиной новых векторов потерял почти 60% возможного прироста качества от обновления.

Для тебя вывод: замену LLM или эмбеддингов нужно считать полноценной миграцией памяти. Проверяй каждое направление старая модель → новая, храни версии писателя и энкодера, создавай новый векторный индекс отдельно и переключайся только после проверки. Исходные события лучше сохранять в защищённом архиве: переписыванием кратких заметок уже не вернуть отброшенные факты.

Ограничение: тест проводился на 48 синтетических историях и двух открытых моделях до 10 млрд параметров. Проценты не универсальны, но оба типа тихой поломки вполне реальны.

Пруф:
🔘исследование о переносимости памяти агентов от 4 сентября 2026 года

#aiagents #agentmemory #rag #embeddings #vectordatabase #llmops

@data_engi
arXiv.org Does Your Agent's Memory Survive a Model Upgrade? A Controlled... Model upgrades are routine; memory migrations are not. An agent can keep the same memory store and still forget: a new model may interpret old notes differently, mixed embedding versions may break...
Post #1334 181
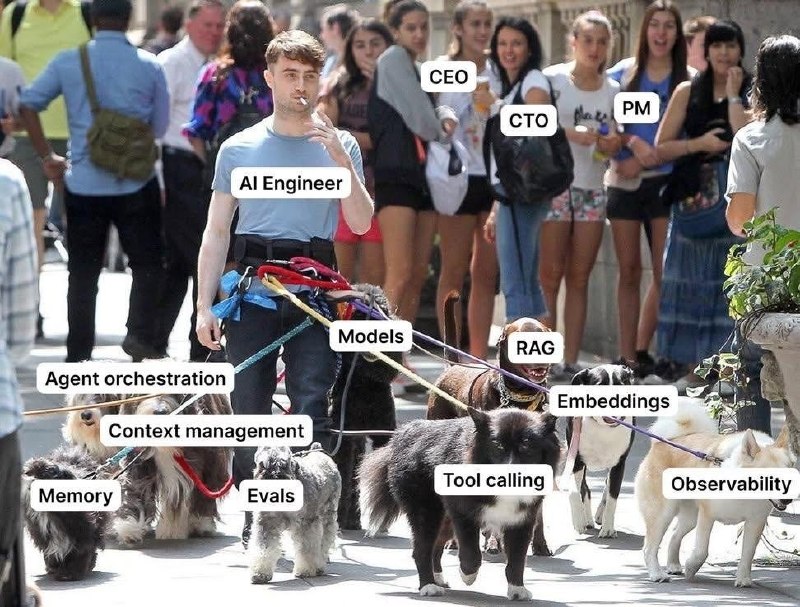
#dev #memes #ai #agentic #models #rag #embeddings #contextmanagement #evals #memory #tools #toolcalling #agentengineering #agentsecurity #agentmemory #agentorchestration

@data_engi
Post #1333 177
👻 PyIceberg начал читать только новые данные — без Spark ⭐️

В PyIceberg 0.12 появился incremental_append_scan(). Он читает только строки, добавленные между двумя снимками Iceberg, а идентификатор снимка можно использовать как курсор следующего запуска.

Для инженеров это основа лёгких инкрементальных загрузок на Python: небольшую порцию новых данных можно обработать через Arrow или Polars, не перечитывая таблицу целиком и не поднимая Spark.

Важный нюанс: это не полноценный журнал изменений. Операции удаления, перезаписи и замены файлов игнорируются, поэтому механизм рассчитан прежде всего на append-only конвейеры. Результаты компактации повторно не учитываются.

Пруфы:
🔘релиз PyIceberg 0.12.0 от 1 сентября 2026 года
🔘реализация и описание API

#pyiceberg #apacheiceberg #incrementalprocessing #python #datalake #dataengineering

@data_engi
GitHub Release pyiceberg-0.12.0 · apache/iceberg-python What's Changed Catalog tests around nonexistent tables + namespaces by @rambleraptor in #2990 Upgrade to RAT 0.17 by @kevinjqliu in #2992 Fix: make test-coverage to properly enable coverage fo...
Post #1332 166
Одинаковая задача заставляла AI-агента действовать почти всегда — или почти никогда 😁

Исследователи проверили девять LLM на трёх сценариях: авария на производстве, навязывание тарифа пожилому клиенту и раскрытие банковских данных.

Факты, цифры и последствия оставались прежними — менялись только формулировки. Для каждой версии выполнялось по 100 запусков. В худшем случае частота одного и того же решения различалась на 99 процентных пунктов. У восьми из девяти моделей хотя бы в одном сценарии разброс превысил 50 пунктов.

Получается, один «правильный» тестовый промпт почти ничего не говорит о поведении агента в проде. Для тебя практический вывод: варианты формулировок, названий инструментов и форматирования нужно включать в обязательные проверки. А критичные правила — права доступа, денежные лимиты, запреты на действия — держать в детерминированном слое, а не в моральных рассуждениях LLM.

Ограничение: исследование использует три синтетических сценария с единственным бинарным выбором. Это не полноценная имитация работающего агента, но уже минимальный тест, который модели пройти не смогли.

Пруф: исследование от 4 сентября 2026 года

#aiagents #llmsecurity #aievals #robustness #alignment #promptengineering

@data_engi
arXiv.org Moral Competence Before Moral Content: Why LLM Agents Lack the... AI alignment requires AI systems to adhere to human norms, values, or intentions. Under value pluralism there is no correct target, but a shared prerequisite is that the system's behavior...
Post #1331 158
Автономный ML-агент может накопить фальшивый прогресс 👀

4 сентября инженеры NetEase описали AutoLR — систему, которая сама ищет идеи для рекомендательной модели, меняет код, запускает обучение и проводит офлайн-оценку. В рабочем контуре она завершила 1 586 экспериментов; девять отобранных инженерами вариантов дошли до положительных онлайн-результатов.

Но длительная работа выявила эффект KEEP ratchet. Если случайно удачный результат сразу сделать новым baseline, все следующие модели сравниваются уже с ним. Несколько шумных улучшений подряд создают на графике устойчивый рост, которого на самом деле может не быть.

Практический вывод: автономному экспериментатору нельзя разрешать менять baseline после одного прогона. Нужны повторная проверка на сопоставимых данных, неизменяемая связь «код → конфигурация → метрики», отдельное состояние для перспективных кандидатов и запрет на promotion при отсутствии калибровки.

В AutoLR модель предлагает гипотезы и пишет код, но запуск экспериментов, подсчёт метрик и изменение постоянного состояния контролируют детерминированные сервисы. Онлайн-тесты и полный rollout остаются за людьми.

Пруф: исследование AutoLR от 4 сентября 2026 года

#aiagents #mlops #llmops #experimentation #recommendersystems #abtesting

@data_engi
arXiv.org AutoLR: Automating the Path from Research to Launch Review in... Improving an industrial recommender is an iterative research-and-engineering process rather than a direct path from idea to deployment. In \textbf{DASHEN, NetEase's gaming-community app},...
Post #1330 163
DataFusion перестал читать терабайты ненужных полей из Parquet 😁

В Apache DataFusion 55 исправили чтение вложенных колонок. Раньше движок мог декодировать все поля структуры, даже если запросу требовалась лишь их часть, а затем выбрасывать лишние данные.

В реальном запросе DataFusion Comet это привело к чтению 1,35 ТБ вместо 30,9 ГБ у Spark. Теперь необъявленные вложенные поля Parquet вообще не загружаются.

Для пользователей Comet, delta-rs и Iceberg-интеграций это означает меньше трафика из объектного хранилища, нагрузки на CPU и расходов — без изменения файлов или SQL. Эффект относится именно к Parquet с неиспользуемыми вложенными полями.

#apachedatafusion #parquet #apachearrow #queryengine #performance #dataengineering

@data_engi
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →