TGViewer
Agentic Engineer Agentic Engineer @data_engi · 686 subscribers
Post #1219 154
vLLM утроила пропускную способность длинноконтекстных агентов

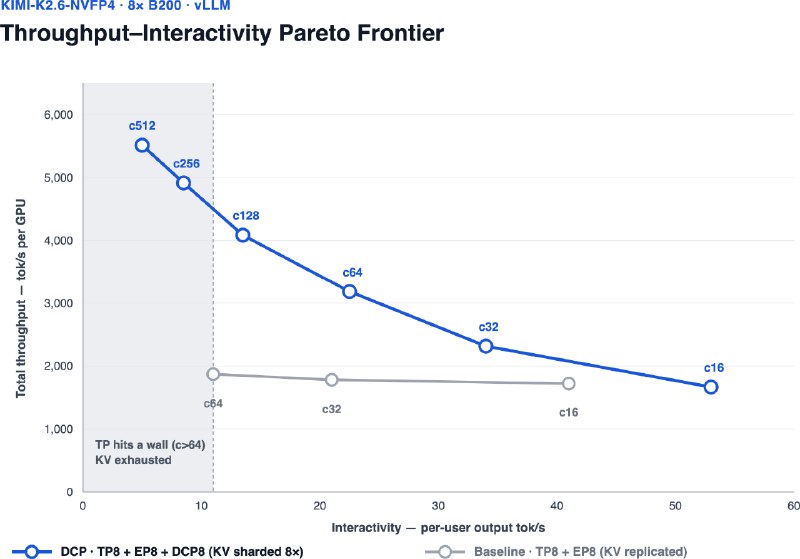
Команда vLLM показала Decode Context Parallelism: KV-кеш делится между GPU не по головам внимания, а по отрезкам контекста. Поэтому видеокартам не приходится хранить одинаковые копии длинной истории агента.

На одном сервере с 8×B200 и Kimi K2.6 производительность выросла с 1 863 до 6 091 токена/с на GPU. Тест использовал реальные агентные трассы с медианой около 67 тысяч токенов и хвостом до миллиона.

Если ты обслуживаешь много долгоживущих агентов, узким местом может быть не сама модель, а дублирование KV-кеша. В vLLM DCP включается одним параметром.

#ai #llm #vllm #inference #kvcache #gpu #agenticai

@data_engi
vllm.ai Efficient Decode Context Parallelism with vLLM for Long Context Workloads Decode Context Parallelism (DCP) in vLLM shards KV cache across GPUs by sequence dimension, enabling 3× higher throughput on long-context agentic workloads comp
More from @data_engi
  1. Oct 6, 2026Post #1399
  2. Oct 5, 2026@data_engi
  3. Oct 5, 2026С днём учителя! @data_engi
  4. Oct 5, 2026Промптом можно пролезть без очереди на LLM-сервере 😁 2 октября исследователи описали JIL…
  5. Oct 5, 2026Iceberg Kafka Connect перестал молча терять данные при ошибке записи 👈 В Apache Iceberg 1…
  6. Oct 4, 2026От "наши LLM - мирового уровня" до "но нужно трезво смотреть на вещи..." прошла одна блоки…
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →