TGViewer
Channel Public Channel
Анализ данных (Data analysis)

Анализ данных (Data analysis)

@data_analysis_ml

Data science, наука о данных.

@haarrp - админ

РКН: clck.ru/3FmyAp
Subscribers
50.6K
Photos
3.7K
Videos
459
Links
3K

Showing posts older than #5279 · Back to latest

Older Posts 14 shown
Post #5277 5.29K
«Claude-Mythos-5» ненадолго засветился в API. Похоже, скоро релиз.

Интересно, пойдут ли они с ценами из поста про Glasswing: $25 за миллион входных токенов и $125 за миллион выходных.

Если да, это сделает Mythos примерно в 5 раз дороже Opus 4.8.

https://x.com/Machinelearrn/status/2063246572914160053
  • ❤ 16
  • 🔥 10
  • 👍 6
  • 🌚 2
  • 👏 1
Post #5276 5.2K
Claude догнал профессиональный химический софт в анализе ЯМР - без дообучения под химию.

Anthropic проверили Claude на ЯМР-спектрах - это метод, по которому химики понимают, какую молекулу они синтезировали. Взяли 20 соединений из свежих препринтов, вышедших уже после даты обучения моделей, и сравнили Claude с ChemDraw и MestReNova.

Что получилось:

- в задаче «предсказать спектр по структуре» Opus 4.7 оказался точнее всех по водороду
- по углероду вышел примерно на уровень специализированного софта
- по форме пиков заметно обошёл классические инструменты
- расщепление пиков угадывал примерно в 80% случаев против 26–35% у обычных тулов

Обратная задача ещё интереснее: восстановить структуру молекулы по спектру.

Специализированный софт такое умеет, но обычно требует 2D-ЯМР, лицензий и человека, который понимает, как с этим работать. Claude же справляется по обычному списку пиков и масс-спектру - по сути, по данным, которые химик мог бы просто скинуть в чат.

Результат:

- 8 из 8 простых молекул восстановлены правильно
- 4 из 7 сложных молекул восстановлены идеально

Выборка пока маленькая, и авторы честно подают это как ориентир, а не финальный приговор химикам.


🔗 anthropic.com/research/making-claude-a-chemist
  • 👍 19
  • 🔥 10
  • ❤ 8
  • 🥱 3
  • 🌭 2
Post #5272 4.13K

Forwarded from Machinelearning

📌ИИ уже ускоряет разработку новых моделей

Anthropic опубликовала аналитический материал, в котором утверждает, что системы искусственного интеллекта всё активнее участвуют в создании следующих поколений ИИ.

Материал подготовлен исследовательским подразделением Anthropic Institute. Его авторы - Марина Фаваро и сооснователь компании, глава отдела политики Джек Кларк.


Отрасль приближается к рекурсивному самоулучшению

Это состояние, когда ИИ способен самостоятельно проектировать и совершенствовать собственного преемника быстрее, чем к этому будут готовы правительства и институты.


При этом Anthropic оговаривается, что до полностью автономной разработки ещё далеко и что такой сценарий не является неизбежным, люди по-прежнему нужны. Они ставят цели, оценивают результаты и решают, какие направления важны.

🟡Внутренние данные

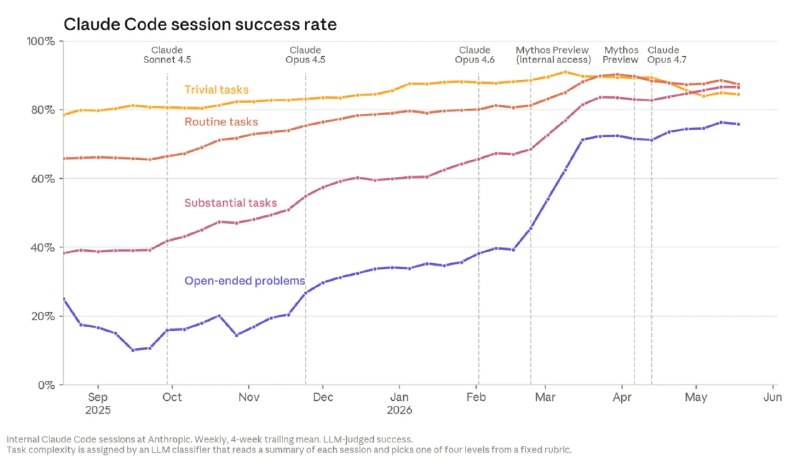
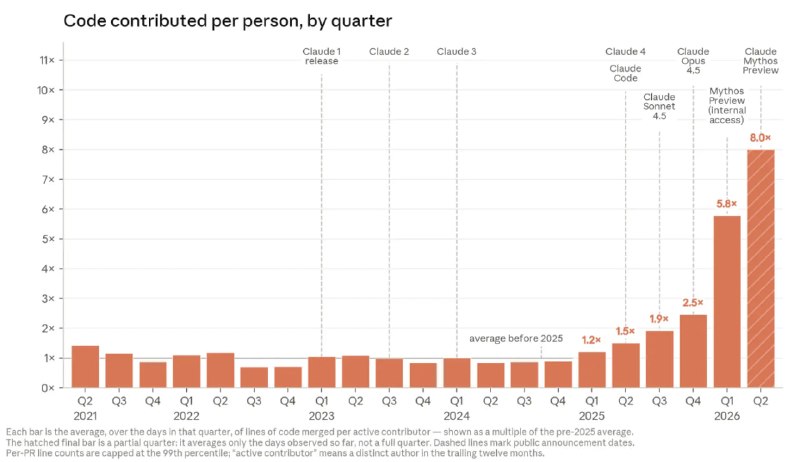
На май 2026 года Claude написал более 80% кода, добавляемого в кодовую базу Anthropic.

До запуска Claude Code этот показатель измерялся единицами процентов.


Во втором квартале 2026 года типичный инженер вносил в проекты примерно в 8 раз больше кода в день, чем в 2024-м.

🟡Публичные тесты

Время выполнения задач, которые модели способны надёжно решать без участия человека, удваивается примерно каждые 4 месяца.

В начале 2024 года Opus 3 справлялся с задачами длиной в несколько минут, годом позже Sonnet 3.7 примерно за полтора часа, а Opus 4.6 - до 12 часов.


На SWE-bench, проверяющем исправление реальных ошибок в коде, передовые модели за два года прошли путь от низких результатов до почти предельных.

Джек Кларк говорит, что компания хочет, чтобы законодатели и институты понимали, что может произойти дальше.

По его словам, цель Anthropic - "заранее обозначить концепцию и дать людям представление о том, что приближается".


Прогресс ИИ, по его оценке, скорее ускоряется, чем замедляется, и может принести значительные результаты в медицине и науке, но требует инструментов для проверки и подтверждения работы, выполненной ИИ.

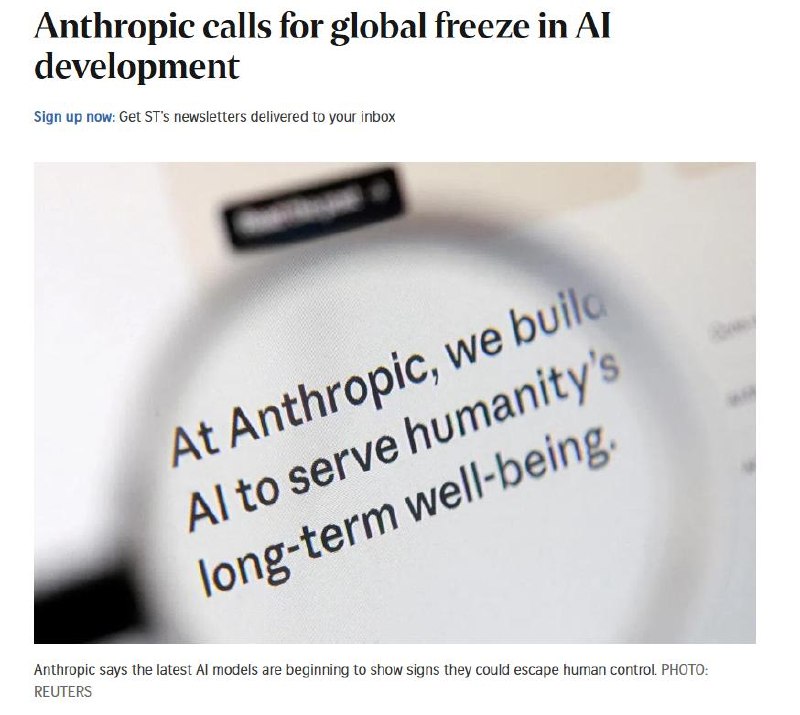
Anthropic выступает за то, чтобы у мира оставалась возможность при необходимости замедлить или временно приостановить разработку передовых моделей, но понимает, что это потребует согласованных всех игроков индустрии в разных странах и механизмов взаимной проверки.

В ближайшие месяцы компания обсудит эти вопросы с законодателями, исследователями и другими участниками отрасли.


@ai_machinelearning_big_data

#news #ai #ml
  • ❤ 8
  • 🥱 5
  • 🔥 2
  • 😱 2
  • 👍 1
Post #5266 4.48K
Глобальной паузы в развитии ИИ не будет — и причина простая.

США открыто называют ИИ стратегической технологией, от которой зависит их мировое лидерство.

Остановиться - значит дать Китаю шанс обогнать, тем более что китайские open-source модели отстают всего на 4–6 месяцев.

Поэтому призывы к паузе - это скорее PR, жест доброй воли, а не реальная стратегия.

Ставки слишком высоки, и никто добровольно не отдаст преимущество сопернику.
  • 🔥 11
  • 💯 4
  • 👍 3
  • 🥱 3
Post #5264 4.95K
Tencent Hunyuan вместе с Gaoling School of Artificial Intelligence при Renmin University of China открыли PlanningBench - фреймворк для оценки и обучения навыков планирования у LLM.

Внутри:

- 30+ задач планирования из реальных сценариев
- автоматическая проверка решений
- поддержка не только оценки, но и обучения моделей

Ресурсы:

arXiv: https://arxiv.org/abs/2605.20873
GitHub: https://github.com/Tencent-Hunyuan/PlanningBench
Hugging Face: https://huggingface.co/datasets/tencent/PlanningBench
  • ❤ 11
  • 🔥 6
  • 👍 4
Post #5263 5.45K
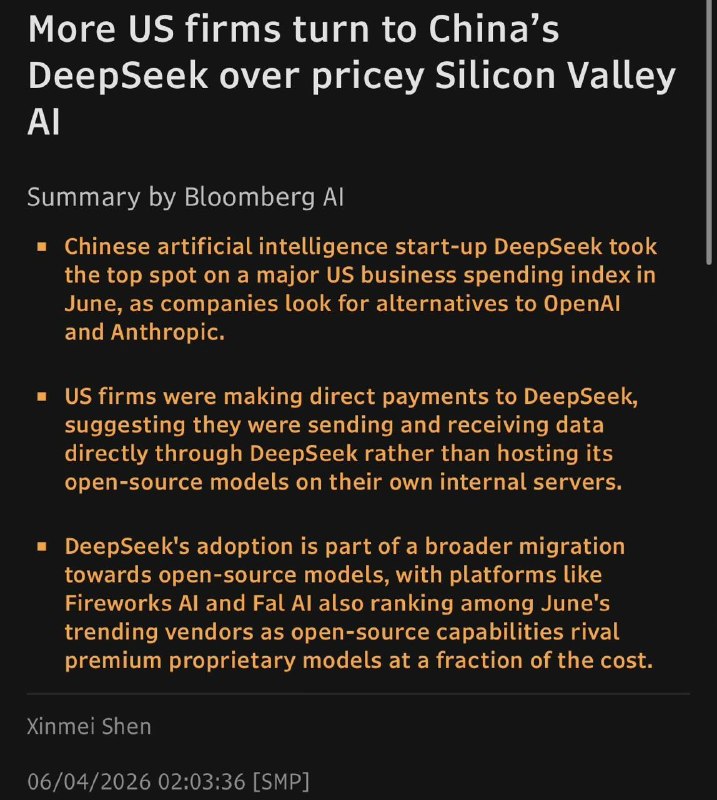
DeepSeek всё чаще появляется в статьях расходах американских компаний.

По данным Ramp, DeepSeek занял первое место в июньском списке trending software vendors. Компании реально начинают платить за более дешёвые альтернативы OpenAI и Anthropic.

Когда ИИ переходит из пилотов в ежедневные процессы, цена токена внезапно становится не мелочью, а строкой бюджета.

Особенно в агентных задачах, где один пользовательский запрос превращается в десятки вызовов модели, поиск, инструменты, повторные проверки и длинный контекст.

С одной стороны, есть привычные OpenAI и Anthropic с сильным брендом, экосистемой и комплаенсом. С другой - DeepSeek и похожие игроки, которые давят ценой и заставляют пересчитывать экономику внедрения.

Самое смешное, что рынок снова ведёт себя без идеологии. Если модель достаточно хороша, API доступен, а счёт в конце месяца заметно ниже, часть компаний начнёт тестировать её независимо от того, кто что говорит про геополитику.

Nothing to see here.
  • 👍 28
  • ❤ 8
  • 🔥 5
  • 🐳 1
  • 🌭 1
  • 🤣 1
Post #5261 3.85K
NVIDIA выкатила Nemotron 3 Ultra - открытую frontier-модель для агентов, которые работают долго, а не просто отвечают на один промпт и забывают контекст.

Ставка здесь не на красивые бенчмарки общего рассуждения, а на длинные агентные цепочки: планирование, вызов инструментов, работа с кодом, исследование документов и enterprise-сценарии, где задача тянется через десятки шагов.

Именно там обычно ломается экономика агентов. Каждый шаг - новый инференс. Чем длиннее траектория, тем выше задержка и итоговая стоимость. В демо это почти не видно, а в проде быстро превращается в главный счёт.

Поэтому самые интересные цифры у Nemotron 3 Ultra связаны с эффективностью:

- до 5x быстрее инференс
- до 30% дешевле на агентных задачах
- фокус на длинных рабочих сессиях
- открытая модель для команд, которым важен контроль над весами

Для продакшен-агентов это бьёт в больное место. Важен не только красивый ответ на одном запросе, а цена завершённой задачи: сколько стоила вся цепочка, сколько времени заняла и сколько раз агенту пришлось дергать модель.

Открытость тоже важна. Команды с собственной инфраструктурой получают больше контроля: можно дообучать под домен, гонять модель внутри периметра и не держать критичный агентный пайплайн полностью на чужом API.

«До 5x» и «до 30%» почти всегда означают лучший сценарий на удобном профиле нагрузки. Реальный прирост зависит от ваших трасс, инструментов, длины контекста и количества шагов.

Проверять такую модель нужно не по latency одного запроса, а по cost-per-completed-task: сколько стоит агенту реально закрыть задачу от начала до конца.

https://blogs.nvidia.com/blog/nvidia-gtc-taipei-computex-2026-news/
  • 👍 10
  • 🔥 5
  • ❤ 2
  • 👏 2
  • 🤯 2
Post #5258 3.29K

Forwarded from Machinelearning

✔️ DeepSeek привлекает около $7,4 млрд инвестиций

Китайская компания проводит первый в своей истории раунд привлечения внешнего капитала около 50 млрд юаней ($7,4 млрд).

По данным агентства Reuters, после вложений компанию оценят в 350–400 млрд юаней ($52–59 млрд).

Крупнейшими внешними инвесторами могут стать интернет-холдинг Tencent и производитель аккумуляторов CATL: первый рассматривает вложение 10 млрд юаней, второй - 5 млрд.

Основатель DeepSeek Liang Wenfeng, по словам источников, внесёт 20 млрд юаней собственных средств (это самый крупный частный взнос в раунде).


Переговоры также ведутся с государственным фондом поддержки ИИ КНР, а также с NetEase и JD.com. Общее число инвесторов, как ожидается, не превысит десяти. Среди возможных участников называют гонконгские IDG Capital и Monolith Management.

На фоне западных сделок раунд выглядит скромно: Anthropic в прошлом месяце привлёк $65 млрд, OpenAI в марте - $122 млрд.

О планах выхода на биржу DeepSeek пока не заявлял.


@ai_machinelearning_big_data

#news #ai #ml
  • ❤ 8
  • 👍 4
  • 😍 2
  • 🤣 1
Post #5256 4.25K
У агентов снова нашли слабое место: память может портиться прямо во время «самоулучшения».

В новой работе Useful Memories Become Faulty When Continuously Updated by LLMs исследователи из University of Illinois, Tsinghua University и других лабораторий проверили, что происходит, когда агент постоянно переписывает свой опыт в аккуратные заметки.

Идея выглядит логично: агент решил задачу, сжал опыт в короткий урок, сохранил его в память и в следующий раз должен работать лучше. Но на практике такие пересказы постепенно ломают исходный смысл.

LLM часто превращает конкретный успешный эпизод в слишком общий совет. Потом эти советы группируются, обновляются, переписываются и начинают смешивать разные типы задач. В итоге память выглядит красиво, но работает хуже, чем сырые попытки с реальным контекстом.

Авторы тестировали это на веб-шопинге, симулированных средах, работе с приложениями и ARC-подобных задачах. Самый жёсткий результат: GPT-5.4 решала 100% небольшого набора ARC-AGI без памяти, но после построения памяти из правильных решений качество падало примерно до 54%.

Что ломалось:

- разные задачи склеивались в одну группу
- частные правила становились «универсальными»
- важные детали терялись при пересказе
- память переобучалась на узкие примеры
- новые обновления затирали полезные старые факты

Для агентных систем это неприятная проблема. Долгая память сама по себе не делает агента умнее. Если каждое действие автоматически превращать в саммари, агент может звучать увереннее, но действовать хуже.

Более рабочая схема - хранить сырые эпизоды как доказательства: реальные попытки, ошибки, решения и контекст. А обобщения делать осторожно, не превращая память в бесконечно переписываемый конспект.

Paper: https://arxiv.org/abs/2605.12978
  • ❤ 15
  • 🔥 7
  • 🥰 4
  • 😁 4
Post #5254 12.7K
⚡️ OpenAI раздаёт ChatGPT Pro на 6 месяцев владельцам open-source проектов.

В рамках программы Codex for Open Source можно получить:

• 6 месяцев ChatGPT Pro
• доступ к Codex и GPT-5.5 Pro
• API-кредиты
• Codex Security

Заявка простая: нужно отправить ссылку на свой репозиторий и коротко объяснить, зачем проект важен и как Codex поможет его улучшить.

Больше шансов у тех, у кого есть:

• активный GitHub-профиль
• несколько публичных репозиториев
• звёзды на проектах
• нормальная история коммитов

Если у вас есть живой open-source проект, это один из самых простых способов получить ChatGPT Pro на полгода бесплатно.

https://openai.com/ru-RU/form/codex-for-oss/

@data_analysis_ml
  • 👍 18
  • ❤ 10
  • 🔥 8
  • 😐 1
Post #5253 5.69K
Кремниевая долина в шоке: Сандерс хочет забрать половину AI-капитала

Берни Сандерс (главный социал-демократ американской политики) готовит законопроект American A.I. Sovereign Wealth Fund Act. Идея звучит максимально жёстко для Кремниевой долины: крупнейшие AI-компании должны передать 50% акций в пользу общества через разовый налог не на прибыль, а именно на stock.

По замыслу Сандерса, эти доли попадут в суверенный фонд. Дальше доходы от роста AI-индустрии должны идти не только основателям, фондам и ранним инвесторам, а обычным гражданам США: через выплаты, медицину, образование и жильё.

Аргумент у него простой и политически очень заряженный. Генеративный ИИ обучался на книгах, коде, статьях, музыке, изображениях, видео и идеях миллионов людей. Значит, если новые триллионы создаются на базе «коллективного знания человечества», то и часть богатства должна возвращаться обществу.

Для AI-компаний это, конечно, выглядит как кошмарный сценарий. Не штраф, не новый налог на прибыль, не регулирование API, а фактическое размывание собственности в пользу государства и граждан.

Что предлагает Сандерс:

- 50% ownership stake для общества в крупнейших AI-компаниях США
- разовый налог акциями, а не деньгами
- создание американского AI sovereign wealth fund
- участие государства в управлении через голосующие акции
- распределение будущих доходов между гражданами

Полный текст закона он обещает раскрыть позже, поэтому пока это скорее политическая рамка, чем готовый юридический механизм. Но сама постановка вопроса уже важна.

Политики начали смотреть на ИИ модели не как на обычный софт, а как на новую нефтяную скважину. Только вместо нефти - данные, код, культура, научные тексты и человеческое внимание.
  • ❤ 48
  • 👍 19
  • 🤯 13
  • 🤣 10
  • 🔥 6
  • 😁 4
Post #5250 4.49K
США хотят смотреть самые мощные AI-модели до релиза

Трамп подписал executive order, который вводит добровольную проверку frontier-моделей перед выпуском. Речь не про все новые LLM подряд, а про системы, которые могут перейти порог по продвинутым киберспособностям.

Если модель уже умеет находить уязвимости, автоматизировать кибероперации или подсвечивать слабые места в критической инфраструктуре, государство хочет получить короткое окно до публичного релиза. Не чтобы «разрешить или запретить» модель, а чтобы защитники успели подготовить патчи, процедуры и ограничения.

По новой рамке AI-лаборатории смогут добровольно давать федеральным агентствам доступ к таким моделям максимум на 30 дней до релиза для других доверенных партнёров. К оценке должны подключаться NSA, CISA, NIST и другие структуры, а сам порог для covered frontier model будет определяться через закрытый benchmarking-процесс.

covered frontier model - это не любая новая модель, не очередной апдейт чат-бота и не open-source релиз на Hugging Face. Это модель, которая по правительственным критериям показывает продвинутые возможности именно в кибердомене.

Отдельно в EO прописано, что документ не создаёт обязательное лицензирование, preclearance или разрешительный режим для разработки, публикации и распространения AI-моделей, включая frontier-модели. То есть формально это не «гослицензия на LLM», а попытка встроить ранний кибер-аудит в релизный цикл самых опасных систем.

Пока это добровольная опция.

http://whitehouse.gov/presidential-actions/2026/06/promoting-advanced-artificial-intelligence-innovation-and-security/
  • 👍 7
  • ❤ 3
  • 🔥 3
  • 🤣 3
Post #5246 5.35K
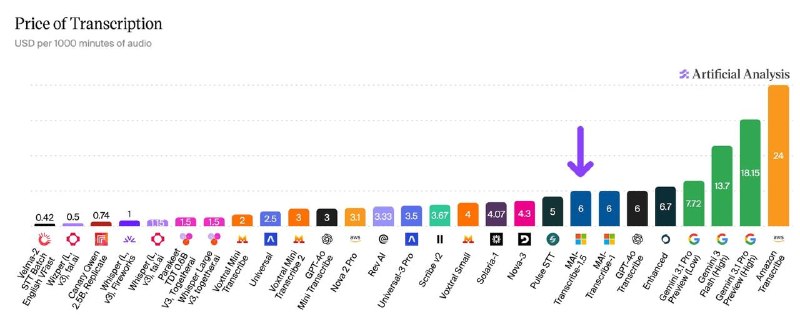
⚡️ Microsoft выпустил MAI-Transcribe-1.5 - модель транскрибации речи, которая обрабатывает аудио в 276 раз быстрее реального времени.

Для сравнения: второй по скорости точный конкурент из топ-10 работает вдвое медленнее.

При этом по качеству - 2.4% WER по бенчмарку Artificial Analysis, третье место в общем зачёте. Впереди только Alibaba Fun-Realtime-ASR-preview (1.7%) и ElevenLabs Scribe v2 (2.2%).

keyword biasing для редких слов - имён собственных, медицинских терминов и поддержка 43 языков включая арабский, японский, китайский.

Скорость такого уровня при точности из топ-3.

https://microsoft.ai/news/introducingmai-code-1-flash/
  • ❤ 16
  • 👍 10
  • 🔥 6
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →