
🧠 Xiaomi потратила около $2,6 млн на этап обучения MiMo через попытки, ошибки и обратную связь.
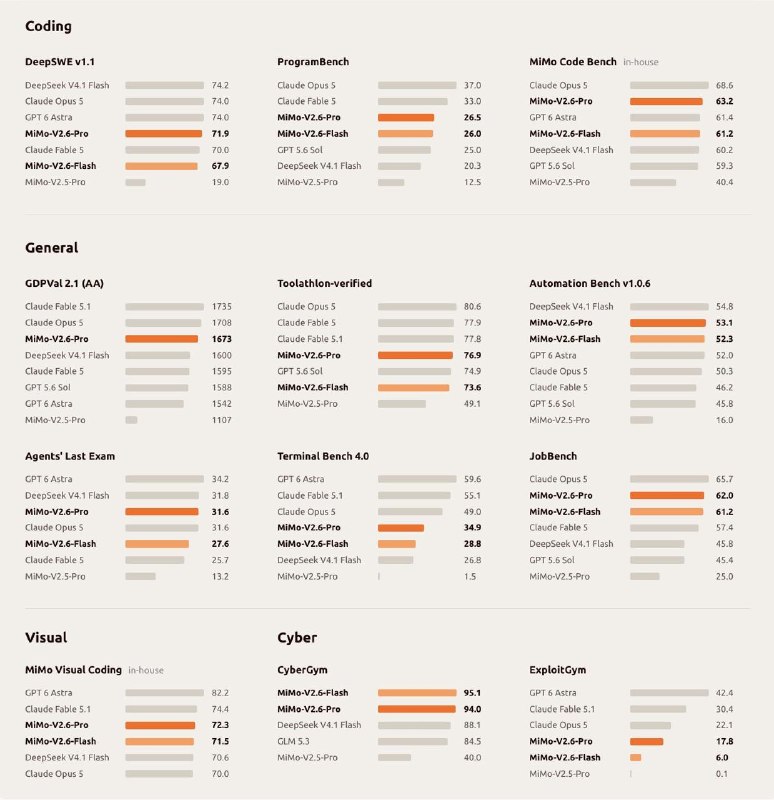
В отчёте MiMo-V2.6 команда разбирает, как масштабировать обучение с подкреплением для ИИ-агентов.
Модель решает задачи в рабочих средах, получает оценку результата и обучается на собранном опыте. Масштабируют сразу три компонента:
• количество попыток и пропускную способность;
• разнообразие задач: код, визуальные сценарии, работа с инструментами и кибербезопасность;
• вычисления на проверку решений.
Интересная деталь: проверяющие сравнивают решения внутри группы, помогая поощрять более качественные и короткие пути к результату. Отдельно предусмотрена защита от *reward hacking*, когда модель находит способ получить награду без полноценного решения задачи.
По данным Xiaomi, после этого этапа результат Pro на DeepSWE v1.1 вырос с 58,4% до 72,6%, а Flash с 48,8% до 65,7%. Команда также открыла веса, RL-фреймворк и более 7 000 тренировочных сред.
https://www.chapterpal.com/s/f8dd8d6f/mimo-v26-scaling-reinforcement-learning-towards-self-improvement
Post #5928
1.33K
- 🔥 8
- 👍 5
- ❤ 4