🧪 Новый бенчмарк проверяет не то, что ИИ знает, а способен ли он сам открыть неизвестные правила
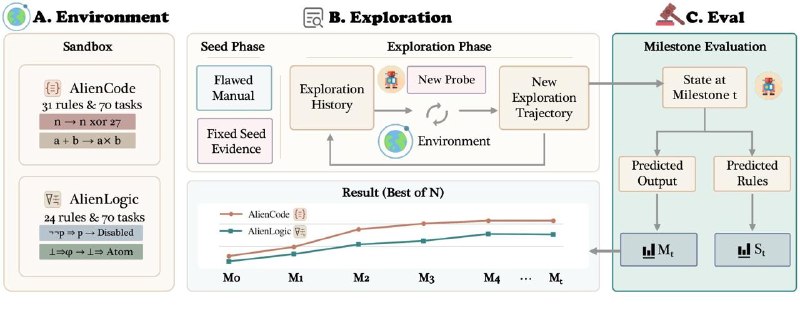
Исследователи Tencent Hunyuan, Fudan и Tsinghua представили ExplorationBench. В нем модели попадают в «чужие миры», где привычная логика намеренно сломана: операторы работают иначе, а правила вывода изменены. Поэтому выученные знания почти бесполезны.
Модель получает неполное руководство и несколько раундов, чтобы самой придумывать эксперименты, проверять гипотезы и восстанавливать скрытые правила.
Результаты интересные:
- без обратной связи модели стартуют максимум с 15,7%;
- после четырех раундов лучший результат в AlienCode достигает 89%;
- у 9 из 10 систем собственные эксперименты оказались эффективнее повторения уже готовых;
- даже когда модель правильно знает все нужные правила, задача решается лишь в 73,4% случаев;
- один и тот же ИИ при одинаковом бюджете мог показать от 5,7% до 79%.
Главный вывод: уметь рассуждать по известным правилам и уметь самостоятельно открывать новые правила - это совсем разные способности.
Paper: https://arxiv.org/abs/2609.30199
Leaderboard: https://explorationbench.com/
Post #5877
1.09K

- 👍 4
- ❤ 2
- 🔥 2