
Tencent Hunyuan представила EvolveScaler - бенчмарк и датасет для проверки того, умеют ли LLM рассуждать в мире, где информация постоянно меняется.
Пример задачи: модель читает журнал RPG за 40 дней, после чего получает вопрос, если на 7-й день пропустить мини-босса, получится ли всё равно победить финального босса?
Прямого ответа в тексте нет. Нужно фактически «переиграть» цепочку событий с изменённым условием.
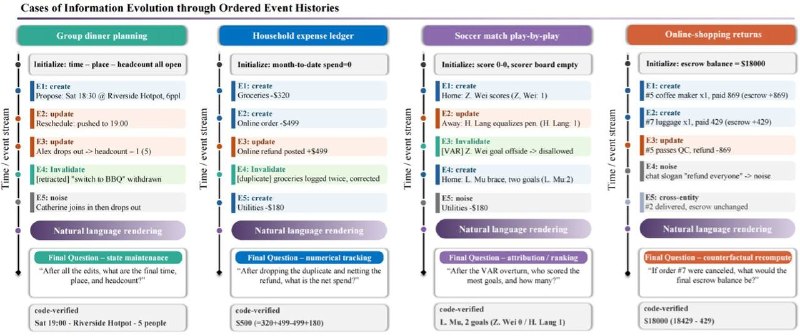
Авторы называют это Information Evolution: записи могут отменяться, исправляться и дополняться задним числом, поэтому простого поиска фактов в длинном контексте недостаточно.
EvolveScaler строится наоборот:
- сначала мир задаётся как исполняемая машина состояний
- логика и зависимости между событиями контролируются кодом
- затем эта история преобразуется в естественный язык
- модель должна восстановить состояние мира и просчитать последствия изменений
Масштаб:
- 117 прототипов сценариев
- 159 типов вопросов
- 5 уровней сложности
- до ~1200 событий в одном примере
Авторы протестировали 14 frontier-моделей. На самом сложном уровне медианный avg@5 падает до 11,3%.
При этом обучение на EvolveScaler дало в среднем +5,25 пункта на 8 внешних бенчмарках, которые не использовались при создании датасета.
Работа проверяет не только понимание длинного контекста, а способность модели поддерживать изменяющееся состояние мира, учитывать исправления и пересчитывать последствия контрфактических изменений.
Paper:
https://arxiv.org/abs/2609.08435
Project:
https://tencent-hunyuan.github.io/evolve-scaler/
Post #5783
4.15K


- 👍 9
- 🔥 6
- ❤ 3
- 👏 1
- 🤔 1