⚡️ Liquid AI выпустила DSpark draft-модели для LFM2.5-1.2B-Instruct, LFM2.5-2.6B и LFM2.5-8B-A1B.
Идея в speculative decoding: маленькая модель примерно на 300M параметров заранее предлагает сразу несколько токенов, а основная модель проверяет весь блок за один проход.
На H100 LFM2.5-8B-A1B в MATH500 ускорилась с 428 до 1362 токенов/с — в 3,18 раза.
На MacBook Pro с M4 Max LFM2.5-1.2B-Instruct в HumanEval — со 136 до 389 токенов/с, почти в 2,9 раза.
Для LFM2.5-2.6B среднее ускорение составило 2,67× на H100 и 2,27× на M4 Max.
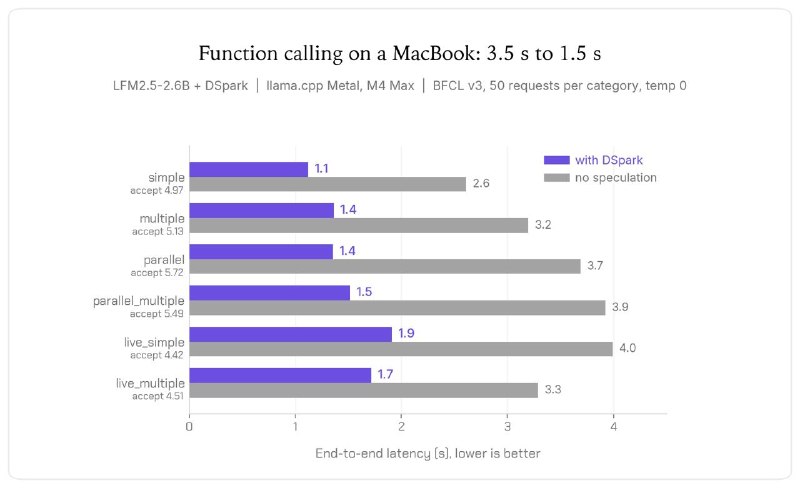
В BFCL-сценариях с несколькими tool calls DSpark почти вдвое сократил среднюю задержку LFM2.5-2.6B.
При greedy decoding результат остаётся идентичным обычной генерации, поэтому ускорение не меняет точность модели.
Чекпоинты уже выложены на Hugging Face, поддержка идёт в llama.cpp и SGLang.
Read more: http://liquid.ai/blog/lfm2.5-dspark
> LiquidAI/LFM2.5-1.2B-Instruct-DSpark: http://huggingface.co/LiquidAI/LFM2.5-1.2B-Instruct-DSpark
> LiquidAI/LFM2.5-2.6B-DSpark: http://huggingface.co/LiquidAI/LFM2.5-2.6B-DSpark
> LiquidAI/LFM2.5-8B-A1B-DSpark: http://huggingface.co/LiquidAI/LFM2.5-8B-A1B-DSpark
> SGLang: https://github.com/sgl-project/sglang/pull/31041
> llama.cpp: https://github.com/ggml-org/llama.cpp/pull/27383
Post #5630
4.18K
- 👍 4
- 🔥 3
- 🥰 3
- ❤🔥 1