Большинство guard-моделей работают с заранее заданным списком запретов. Чтобы адаптировать такую систему под другой продукт, аудиторию или правила компании, часто требуется дополнительное обучение.
Shieldstral предлагает другой подход: разработчик описывает политику безопасности обычным языком прямо во время инференса.
Например:
> «Безопасно ли показывать это изображение несовершеннолетнему?»
Модель анализирует текст, изображение или пару «запрос - ответ», после чего возвращает вероятность
yes или no.Что умеет Shieldstral:
- проверять пользовательские запросы и ответы модели;
- модерировать текст и изображения;
- оценивать, был ли отказ модели обоснованным;
- адаптироваться к новым правилам без переобучения;
- выдавать оценку риска, а не только жёсткий ярлык.
В модели всего 3 млрд параметров, поэтому её можно запустить на одной NVIDIA GPU с 16 ГБ памяти.
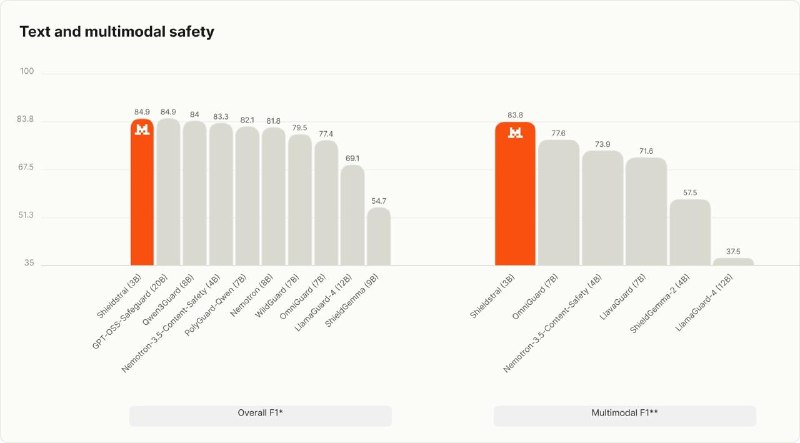
По внутренним тестам Mistral, Shieldstral конкурирует с открытыми guard-моделями, которые крупнее её до семи раз. Эти результаты пока требуют независимой проверки.
Модель опубликована с открытыми весами под лицензией Apache 2.0.
Подробнее:
https://mistral.ai/news/shieldstral