
⚡️ Китайцы из Ant Group выкатили Ling-2.6-flash и он бьёт по больному месту всей индустрии LLM.
Пока все соревнуются, чей ответ длиннее и красивее, Ant Group пошли в обратную сторону и выпустили Ling-2.6-flash.
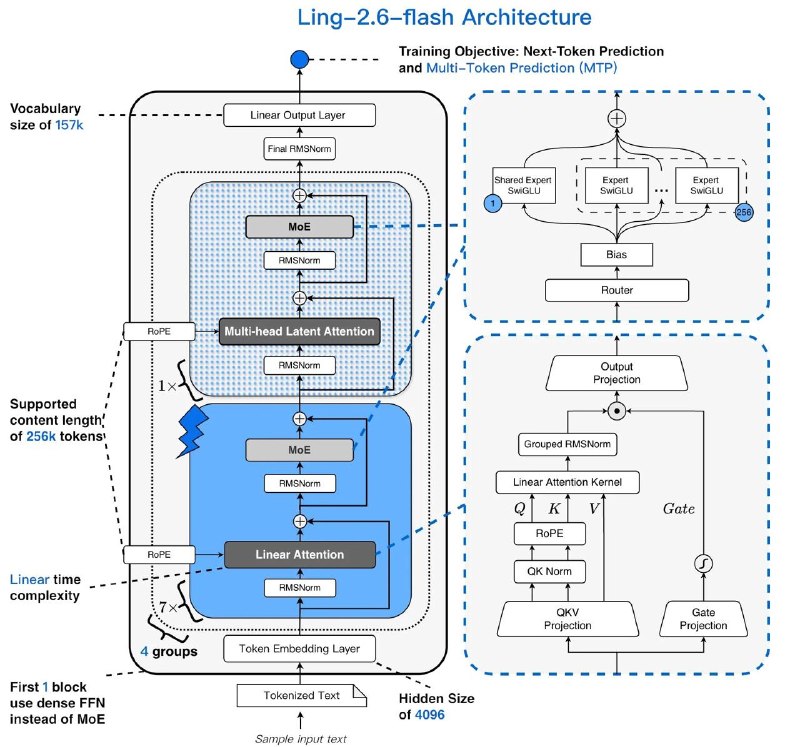
Модель с 104 миллиардами параметров, из которых активных всего 7,4 миллиарда. То есть MoE архитектура, где в каждый момент работает лишь малая часть сети, а считать приходится за копейки.
Модель специально натаскана не раздувать ответы. Никаких простыней на пустом месте, никакого пережёвывания одной мысли на три абзаца ради видимости глубины.
Разработчики прямым текстом говорят: мы оптимизировали соотношение интеллект на токен, а не интеллект на количество слов. Для тех, кто платит за API, это буквально экономия на ровном месте, потому что цена идёт за каждый токен, а выхлоп тот же.
Архитектура гибридная линейная, что даёт серьёзный прирост по скорости и памяти на длинных контекстах.
Обычные трансформеры на длинном входе захлёбываются квадратичной сложностью внимания, а тут эту проблему частично обошли.
Модель быстрая, причём заметно.
Отдельно заточили её под агентские сценарии. Вызов инструментов, многошаговое планирование, выполнение задач.
Замеры идут на BFCL-V4, SWE-bench Verified, TAU2-bench и Claw-Eval, то есть на реальных агентных бенчмарках, а не на синтетике.
И там Ling-2.6-flash держится на уровне конкурентов, которые в разы жирнее по активным параметрам.
Неделю даётся бесплатный доступ через OpenRouter и Novita, плюс официальная площадка ling.tbox.cn.
То есть потрогать можно прямо сейчас, без платёжки и без ожидания вейтлиста.
https://openrouter.ai/inclusionai/ling-2.6-flash:free
Post #5015
4.79K



- 👍 19
- 🔥 10
- ❤ 6