
Как построить data lineage. Обзор решений и опыт команды Тинькофф.
Принесла немного DE-шного материала, посмотрела доклад с конфы Smart Data 2022.
Что такое lineage?
Если кратко, то lineage - это информация, которая описывает движение данных от источника происхождения по точкам обработки и применения.
Где применяется lineage?
- поиск источников: отслеживание зависимостей, поиск узких мест, анализ первопричин аномалий и тд
- анализ влияния: анализ первопричин аномалий, change management, инф.безопасность, комплаенс и тд
Какие есть подходы к построению lineage?
1. 😖Вручную
Сидит разраб и ручками прокидывает стрелочки между элементами, то есть явное указание зависимостей
Плюсы: простота реализации, поддержка множеством etl инструментов
Минусы: как протянуто поле от начала до конца не увидишь, дорогостоящая разработка, так как все связи должен знать разраб, много всего в голове должно держаться.
Кто использует: Pentaho DI, SSIS (рис. 1)
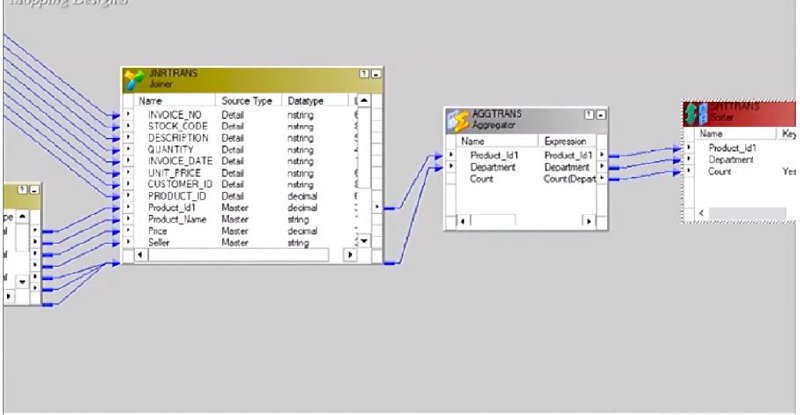
2. 👩💻Полуавтоматический вариант по метаданным
Сидит разраб и ручками заполняет метаданные трансформаций
Плюсы: возможен column-column lineage (то есть видим как поле протягивается от начала до конца), граф выполнения исходя из зависимостей
Минусы: метаданные могут не соответствовать реальности из-за косяков со стороны разраба, сложность в описании явных зависимостей
Кто использует: Informatica (рис. 2), SAS
3. 🤩Автоматически (метаданные извлекаются из кода)
Плюсы: не требует доп.действий, всегд актуальное состояние
Минусы: ограниченное количество инструментов, различия в синтаксисах
Кто использует: dbt(table-table only) (рис. 3), atlan
Нюанс: dbt ничего не знает про семантику, его lineage можно сломать комментом c ref и получим неправильные зависимости.😜
Команда разработчиков в Тинькофф пошла дальше и решила запилить свой собственный инструмент под названием TEDI.
Им потребовалось около 2 лет и 11 человек в команде, чтобы сделать версию под Greenplam.
#трудовыебудни
Post #223
484


- 🔥 6